UniWAM 把理解、預測與機械人動作合而為一

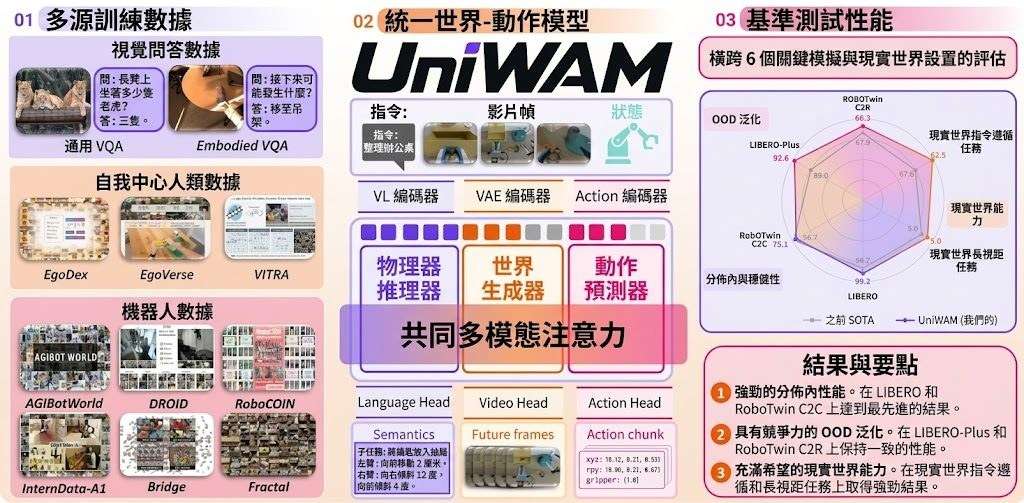
UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。
項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

RobotWorld:把多模態智能體放進機械人世界測試

想比較多模態模型控制不同機械人的能力,RobotWorld 提供 84 項模擬任務及隱藏評測。

Watch RobotWorld in 45 seconds

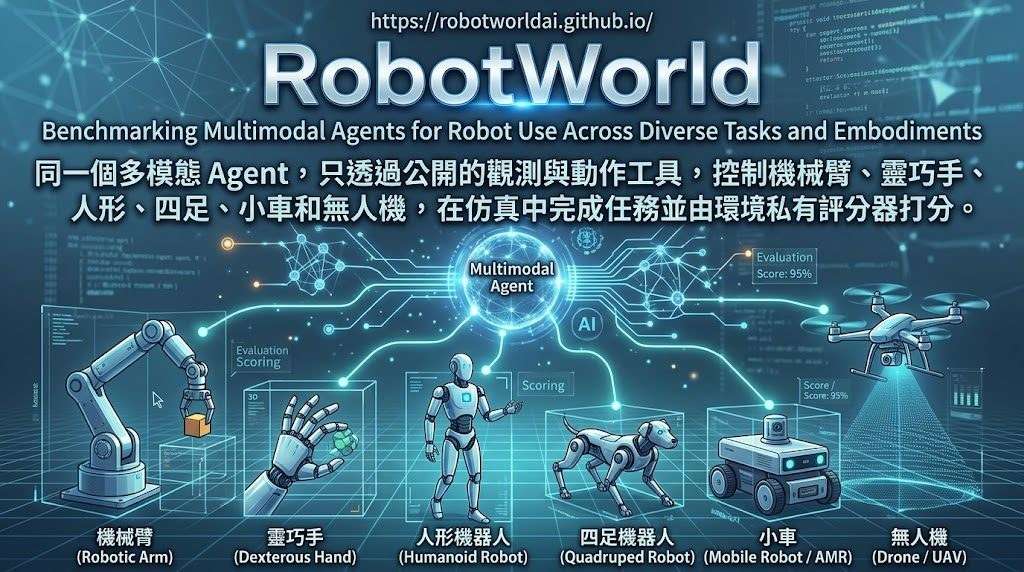
想測試模型能否由影像和狀態資訊控制機械人,而不只是回答完成任務,RobotWorld 提供一套跨模擬器的機械人基準測試項目。它屬於具身智能體評測框架,讓多模態代理透過觀察與動作介面控制機械臂、靈巧手、人形機械人、四足機械人、汽車及無人機,處理 84 項任務和 20 個 benchmark integrations。

代理只能讀取允許的相機影像、關節及任務狀態,再發出受限制的控制指令;環境會回傳執行收據和新觀察,讓代理修正下一步。任務結果由代理看不到的 hidden evaluators 判定,避免模型自行聲稱成功而取代環境驗證,亦能揭示物件狀態遺失、子目標停滯和錯誤完成判斷等失敗原因。

  • 評測方式:預設每項任務進行三次 rollout,並停用 environment-side code control。
  • 涵蓋範圍:由 manipulation、locomotion 延伸至 driving 和 flight。
  • 執行流程:需要還原 source、準備指定 assets、建立 Docker images、編譯 runtime,以及設定模型 API credentials。
  • 限制:已註冊任務不代表全部都有已驗證的成功軌跡,部分依賴和受限制資料集仍需另行取得。

相比只測文字答案或單一機械人的方法,RobotWorld 把模型推理、感知、控制和環境回饋放入同一條閉環,較適合研究團隊比較不同多模態模型、重現評測流程,或為新任務和新 embodiment 擴充測試。代價是安裝和資源準備較複雜,結果亦會受模擬器、模型設定及每項任務預算影響。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, API, Image, World-Action Model, Robotic, 框架, Anthropic, Dataset 數據集

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

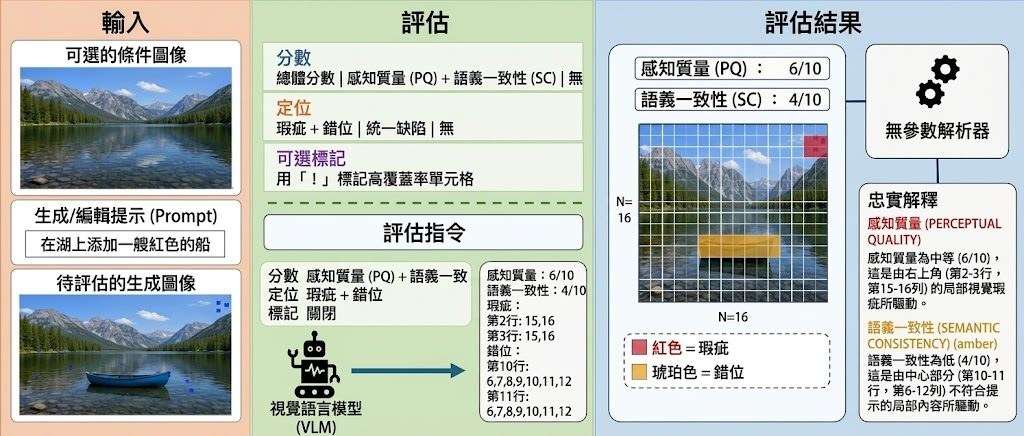
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

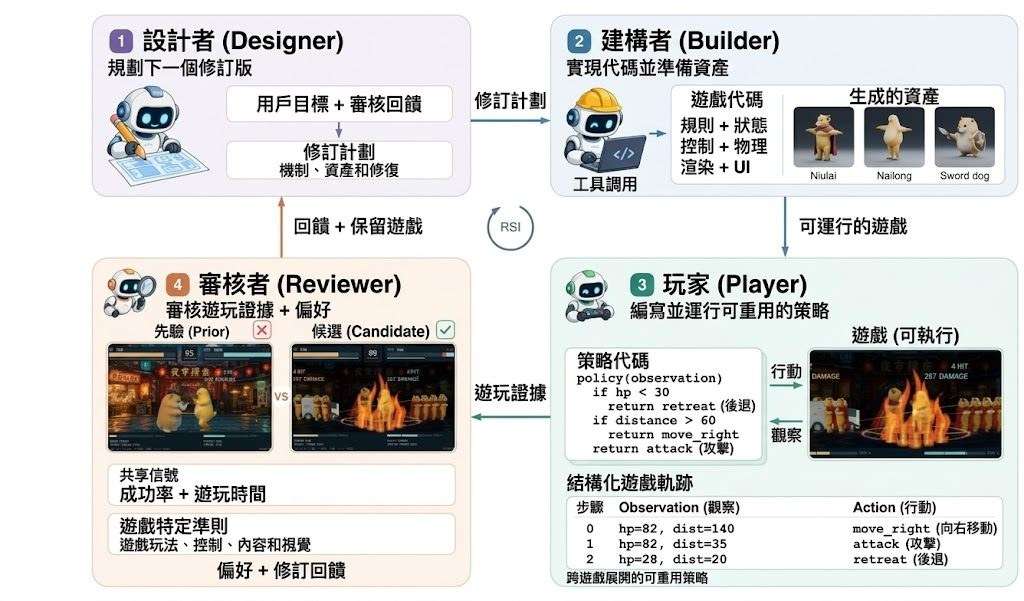
Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

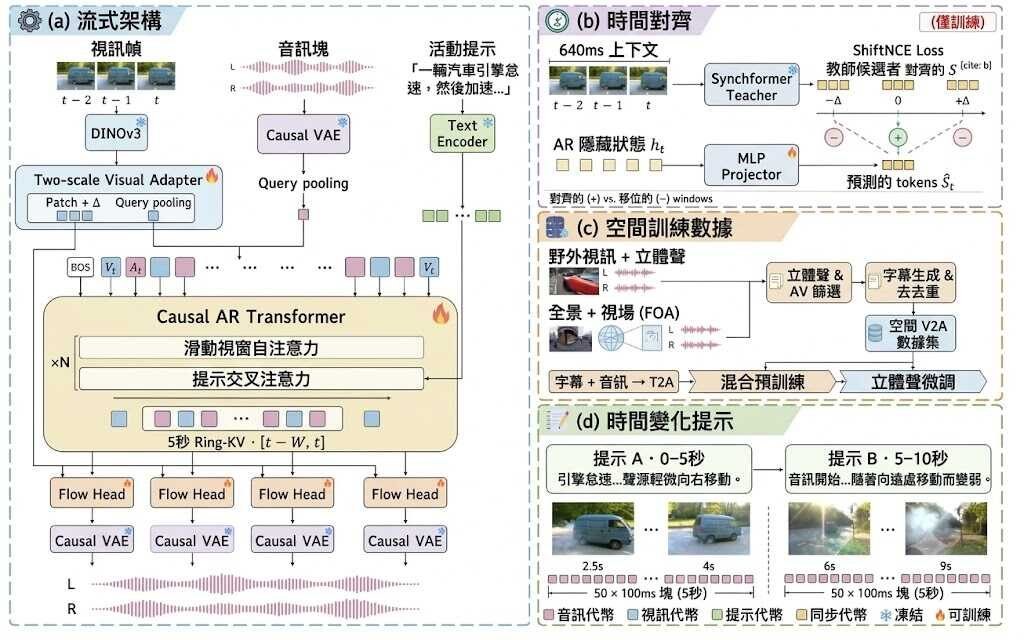
WorldSonus architecture

影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

GRACE 以少八倍 Token 加速影片生成

GRACE 壓縮預訓練影片自編碼器,讓原有 DiT 用更少 latent tokens 生成影片,同時維持接近原模型的質素。

GRACE

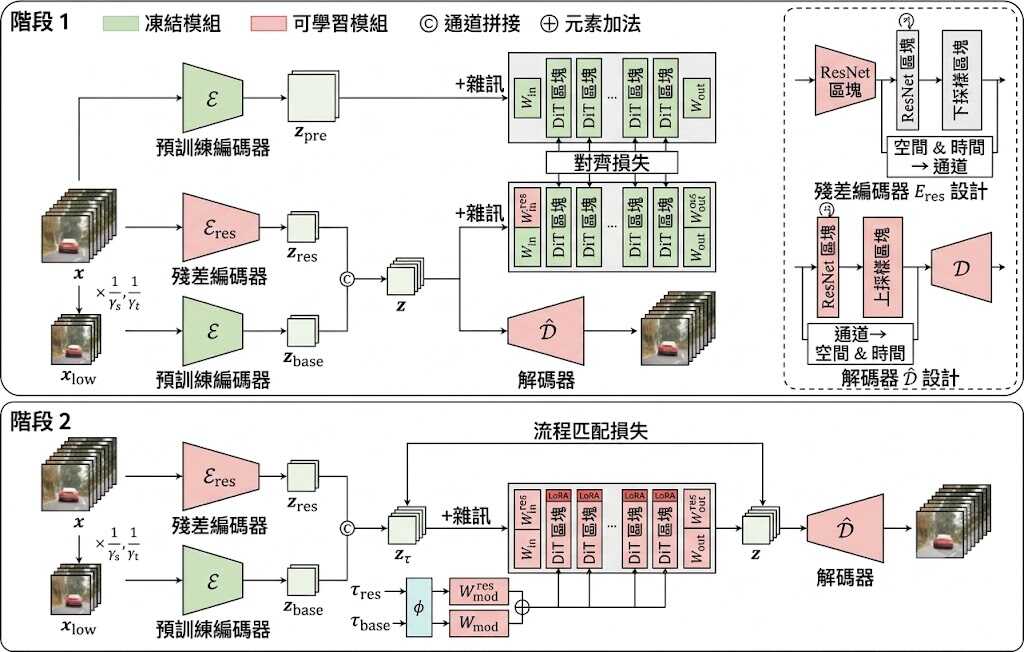
影片生成最難取捨的地方,是壓低 latent tokens 後往往連細節和生成質素一併犧牲。GRACE 以開源模型項目的形式處理這個問題:壓縮預訓練 video autoencoder,讓原本已訓練好的 DiT 在不重新訓練的情況下,從更短的 latent 表示生成影片。

它同時壓縮空間和時間軸,比例分別為 16× 和 8×。模型保留一個 frozen base latent,維持 DiT 熟悉的表示空間,再用 learned residual latent 補回高壓縮率造成的細節;訓練時更在 frozen DiT 的 feature space 對齊壓縮結果,避免只追求 reconstruction quality,卻令生成質素下降。

推理階段採用 asymmetric denoising,base 會比 residual 提前固定 δ=0.15 去噪,讓 residual 在內容穩定後補充細節。這套做法適合研究影片生成、影片模型加速,以及需要沿用既有 DiT 權重而不想從頭訓練的團隊。

  • latent tokens 減少 8×,VBench 分數接近未壓縮模型
  • 480×832×81 輸入的延遲降低 11.1×
  • 736×1280×81 輸入的延遲降低 15.5×
  • 需要按儲存庫提供的環境重現,樣本內容可一致,但不同環境不保證 byte-level 完全相同

安裝及測試時,應先依照項目提供的權重和依賴設定重現結果;提醒部分代理會阻擋指定 PyTorch wheel 來源,檢查 reproduction 時不應額外安裝 FlashAttention,因為 SDPA 已經使用 flash kernel。GRACE 的價值在於以較低推理成本延續既有 DiT 能力,但是否適合生產環境,仍要按硬件、影片尺寸和模型管線重新量度延遲與畫質。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Python, 庫

nanoMuse:跨裝置、會先徵求同意的開源個人代理

nanoMuse 將手機、電腦與網頁連成同一個個人代理,能代辦事情,也會在刪除、傳送或付款前停下來確認。

nanoMuse: an open-source personal agent for every device you own

你可以在手機交代工作,讓 nanoMuse 轉到電腦執行,完成確認時再把要求送回手上的裝置。它屬於開源個人代理項目,處理的是跨裝置協作、持續執行與高風險操作控管。nanoMuse 是獨立的社區項目,與 Meta Platforms, Inc. 無關

手機 App、桌面 App、網頁控制台和串連各裝置的 relay 放在同一個 GitHub 儲存庫,支援 Android、iPhone、iPad、macOS、Windows、Linux 和網頁。Shell、瀏覽器、MCP servers、skills,以及可透過畫面操作手機 App 和電腦視窗的 Hands,全部經 Sentinel 轉接;刪除、傳送或付款前會要求批准,代理本身不會直接執行工具。

  • Markdown 檔案可讀寫,用來描述代理身份、記憶和喚醒時機
  • App 關閉後仍可繼續工作,裝置共用同一個帳戶和對話
  • 可使用社群 relay 的免費模型額度,亦可改用自己的 key
  • relay 能在自家伺服器運行,減少資料離開住所的需要

和 Muse、OpenMinis 的比較:nanoMuse 明確沿用 Meta Muse 式的個人代理方向,但把手機、桌面、網頁、relay 和安全批准機制一併開源。Android、Windows、macOS 和 Linux 有下載版本,iPhone、iPad 則透過 TestFlight beta。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 框架, 工具, Mac, Linux, 庫, 安全, Meta, 免費試用, 中國, 蘋果, Skill 技能

AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

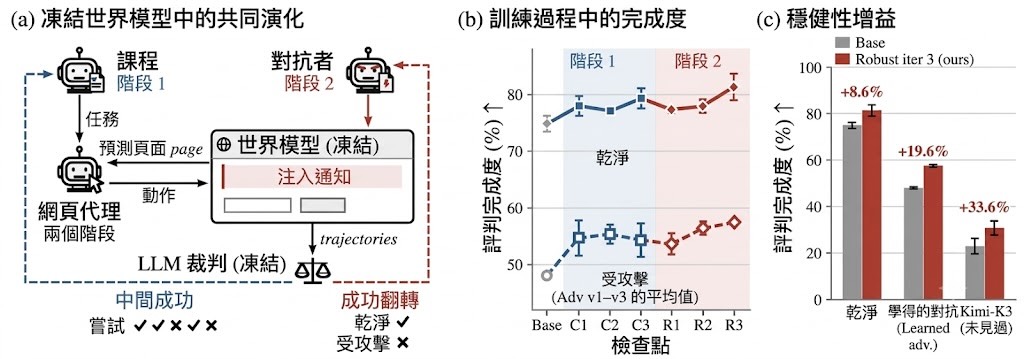
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。

元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

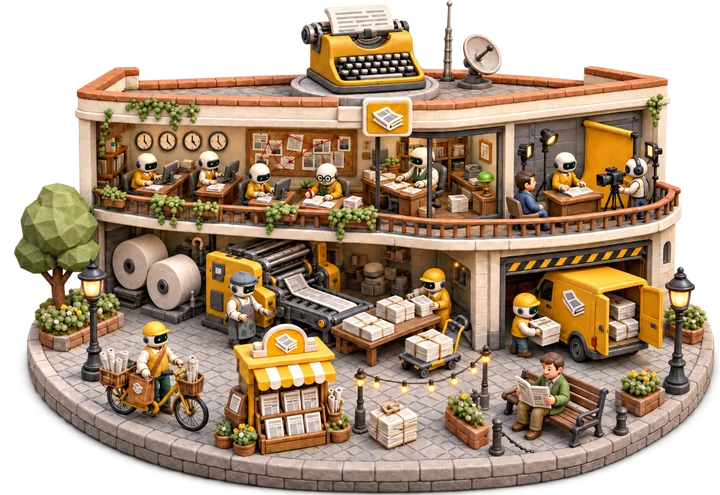
這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

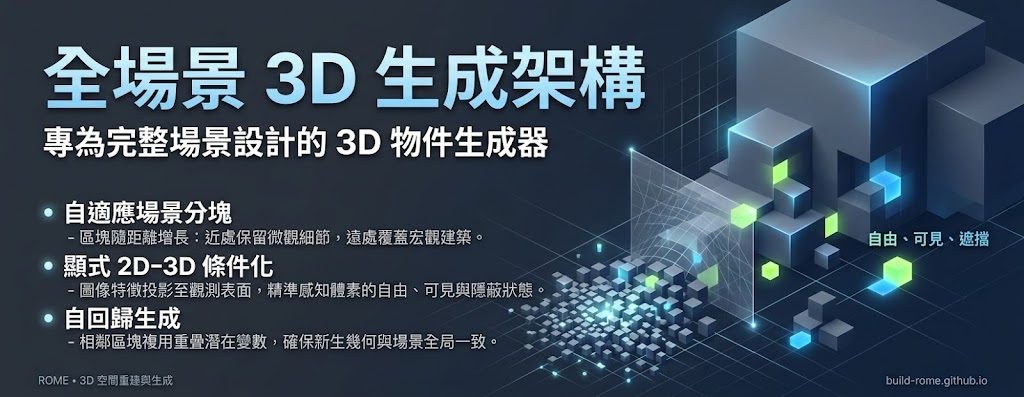
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。

項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

Page 11 of 55
1 … 9 10 11 12 13 … 55