DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

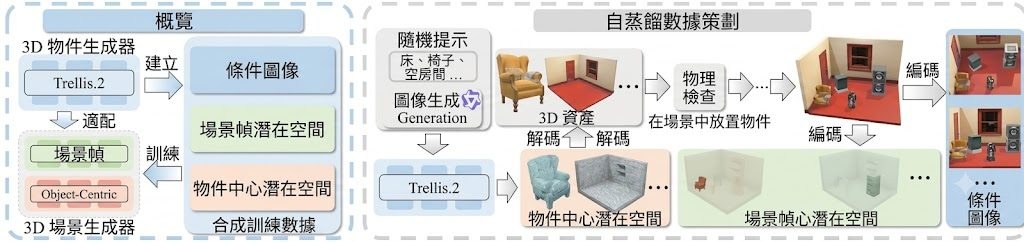
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

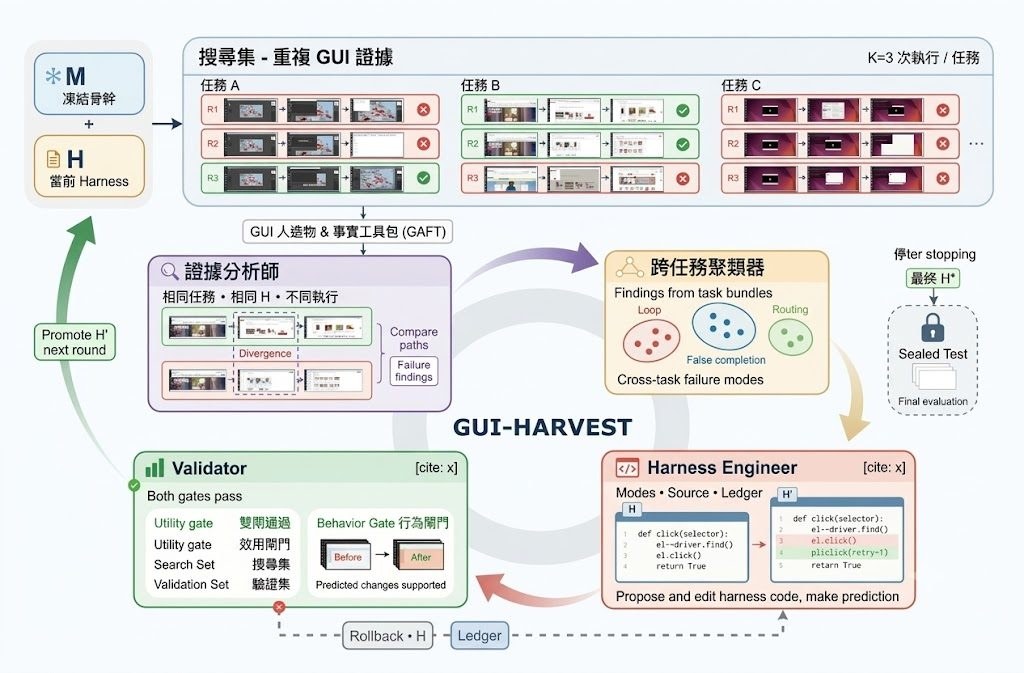
GUI-HARVEST overview

當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

HuatuoGPT-3 以單階段強化學習調整醫療語言模型

醫療模型通常要先經專門監督微調,再進行強化學習;HuatuoGPT-3 嘗試省去前一步,直接以 OnePO 適應醫療任務。

OnePO framework

想把語言模型調整到醫療問答,HuatuoGPT-3 嘗試減少一個訓練階段:它是以 One-stage Policy Optimization(OnePO)訓練的醫療大型語言模型系列,目標是在不先做領域監督微調(SFT)的情況下,透過單階段強化學習適應醫療任務。

OnePO 會先借助教師模型的回答提供指引,再按模型學習進度調整訓練方式。Adaptive Objective Evolution 協助模型學習原本較少選出的教師答案 token;當模型自己的回答所得 reward 已追上或超越教師,Teacher Retirement 便停止教師指引。這做法省去預先進行醫療 SFT 的要求,但訓練仍依賴教師回答、reward 設計和任務資料的質素。

模型系列包括 HuatuoGPT-3-9B 和 HuatuoGPT-3-27B,分別以 Qwen3.5-9B 和 Qwen3.8-27B 為基底;另有以 Qwen3-8B 為基底的 HuatuoGPT-3-Grader-8B。HealthBench Professional 分數方面,9B 版為 68.3,27B 版為 71.4;倉庫沒有列出 Grader 的同項分數,因此不能據此比較評分器表現。

  • 20,338 項 OnePO-Medical-20K 醫療強化學習任務,涵蓋選擇題和開放式回答。
  • 選擇題以答案是否完全吻合驗證,開放式回答則按多項臨床準則評分。
  • 提供模型、訓練程式碼、資料集及 rubric grader,適合研究醫療模型訓練的團隊檢視或重現流程。

模型可按 Qwen3.5 的方式使用,並透過 vLLM 或 SGLang 部署;訓練則需先按文件準備 GPU 環境。對醫療服務團隊而言,這些模型可作研究與評估起點,但倉庫列出的基準分數本身不足以證明模型適合臨床決策,仍需按目標用途進行安全性、準確度及臨床評估。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Medical醫學, 庫, 安全

CIA-minimal-repro:與思維鏈一致性改進模型訓練

CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

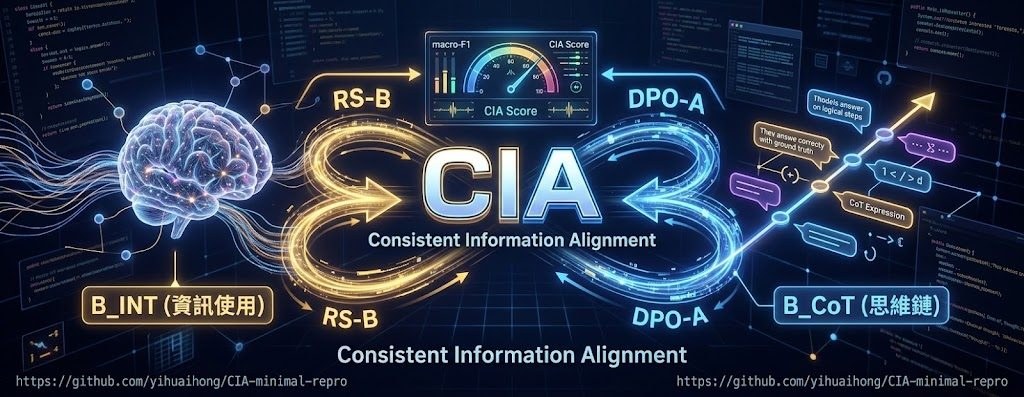
Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

RealtimeWAM 讓世界動作模型走向即時生成

LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

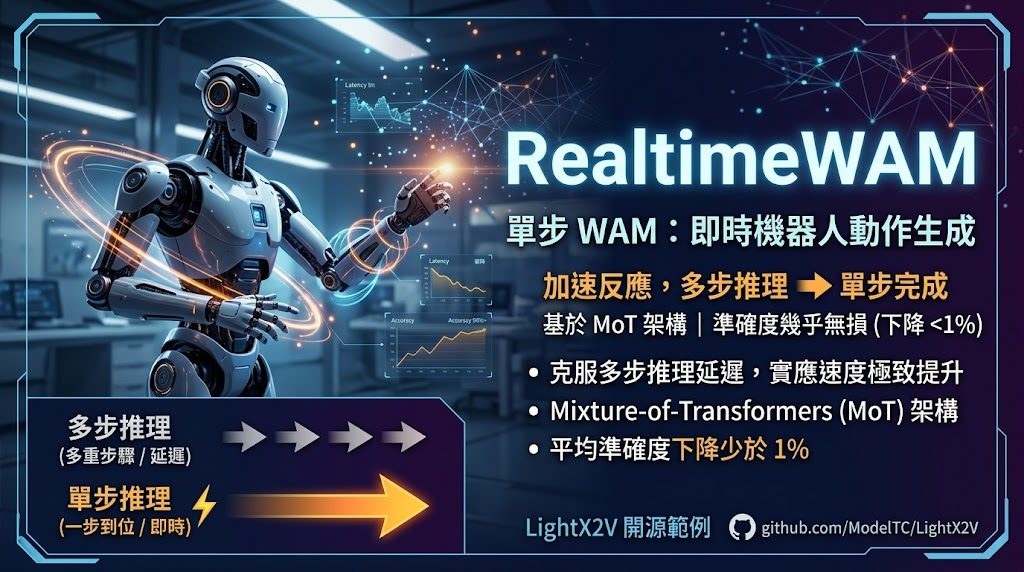
Og image

機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

xllm-loop:循環語言模型

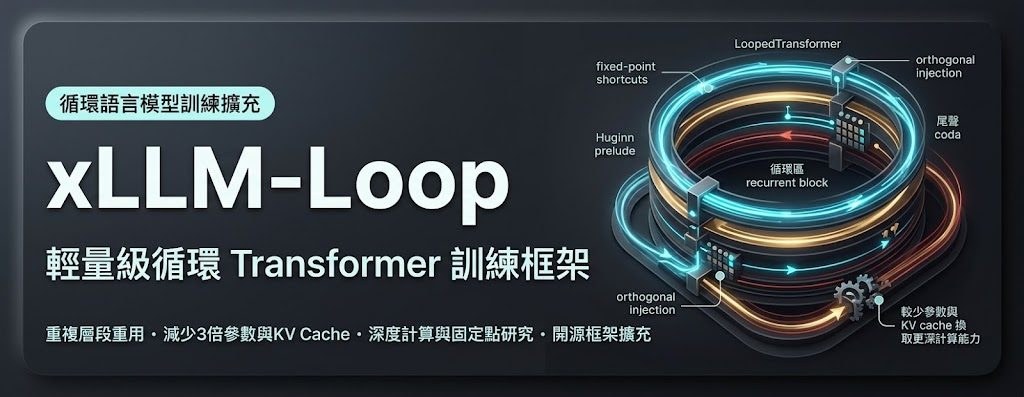
xLLM-Loop 把同一組 Transformer 層重複運算,探索以較少參數和 KV cache 維持語言模型能力。以更少參數換取更大推理深度。

Repository image for ifm-ai/xllm-loop

想用較少模型參數和 KV cache,換取更深的計算能力,xLLM-Loop 提供了一條可直接研究的路線。它屬於開源語言模型訓練框架擴充,處理的是循環語言模型如何重用層、控制深度,以及評估固定點帶來的效率取捨。

LoopedTransformer 會重複執行指定層段,Huginn 則把模型分成 prelude、recurrent block 和 coda,並支援單一或階層式 recurrent state。Part II 進一步研究 fixed-point shortcuts、learned depth prior 和 orthogonal injection,目標是在增加 FLOPs 時維持近乎固定的記憶體需求;相關說法包括較標準 Transformer 少約三倍參數和 KV cache,但不能視為所有任務都能達成的保證。

項目已接入 xLLM,提供兩篇研究工作的 training、evaluation 和 checkpoint 程式碼,並有 49 個 Hugging Face checkpoints。Part I 涵蓋 Dense 和 MoE 共 17 種 recipes、25 個 checkpoints;Part II 涵蓋 depth priors、input-injection variants 和 distilled prefill,共 24 個 checkpoints。

  • 適合研究循環架構、固定點推理和參數效率的模型團隊
  • 可比較固定、抽樣及 learned depth 的訓練方式
  • 支援 LoopedTransformer、Huginn 和 DepthControlledHuginn
  • 需要 PyTorch 2.11、CUDA 12.8、Python 3.12,實驗曾使用 NVIDIA H200

安裝方式沿用 xLLM,但硬件和軟件版本要求偏新,訓練成本亦不低,論文實驗是在 NVIDIA H200 上完成。對想在本地直接使用成熟聊天模型的人,它不是即裝即用的產品;對需要重現研究、載入 checkpoints 或改造訓練流程的團隊,程式碼、評估及 checkpoint 配套就更有價值。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, 框架, Python

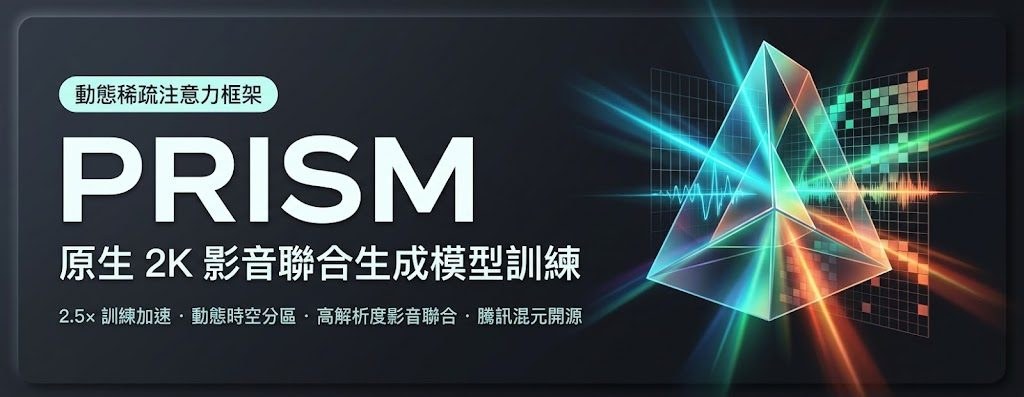
Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。
promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型
Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

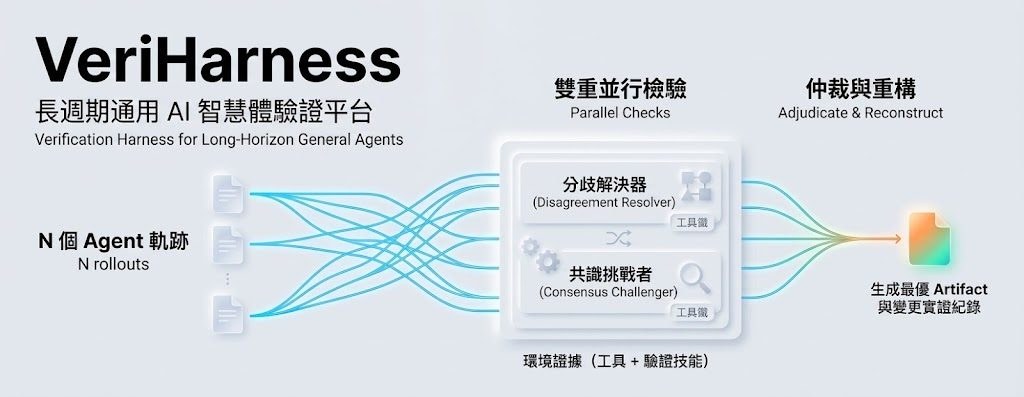
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

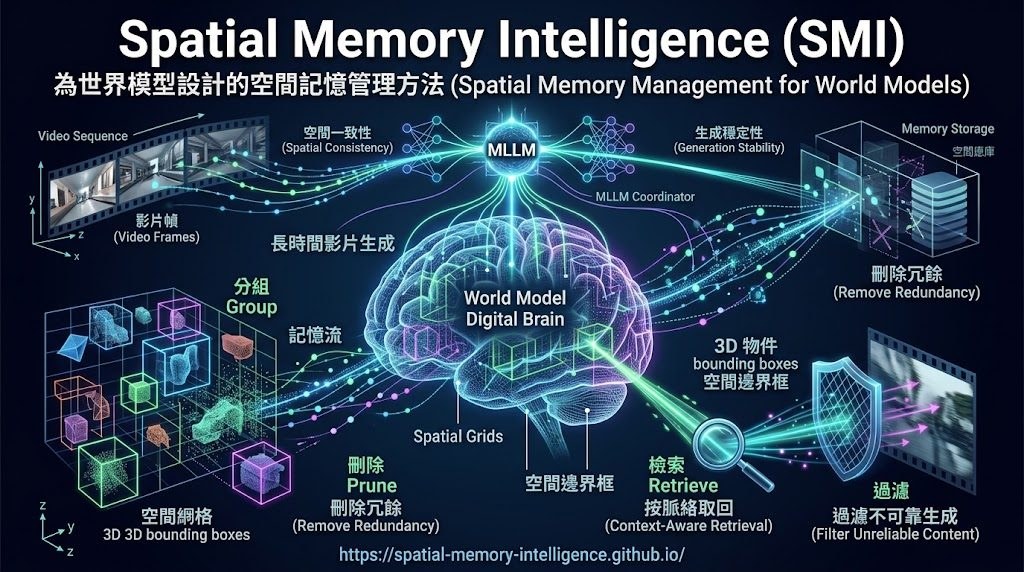
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

Page 12 of 55
1 … 10 11 12 13 14 … 55