影片生成最難取捨的地方,是壓低 latent tokens 後往往連細節和生成質素一併犧牲。GRACE 以開源模型項目的形式處理這個問題:壓縮預訓練 video autoencoder,讓原本已訓練好的 DiT 在不重新訓練的情況下,從更短的 latent 表示生成影片。
它同時壓縮空間和時間軸,比例分別為 16× 和 8×。模型保留一個 frozen base latent,維持 DiT 熟悉的表示空間,再用 learned residual latent 補回高壓縮率造成的細節;訓練時更在 frozen DiT 的 feature space 對齊壓縮結果,避免只追求 reconstruction quality,卻令生成質素下降。
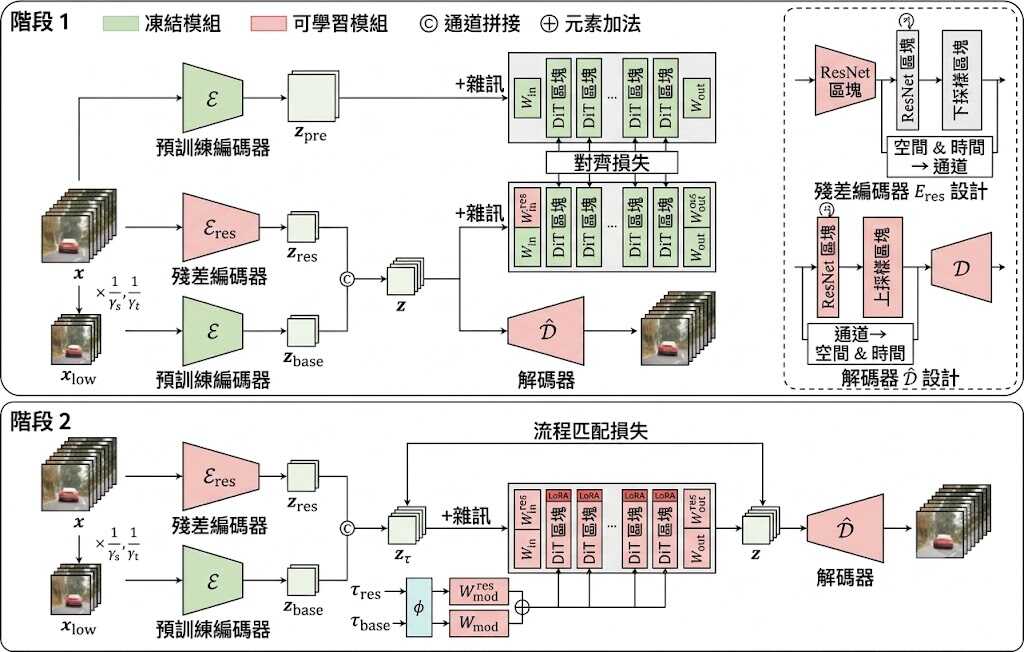
推理階段採用 asymmetric denoising,base 會比 residual 提前固定 δ=0.15 去噪,讓 residual 在內容穩定後補充細節。這套做法適合研究影片生成、影片模型加速,以及需要沿用既有 DiT 權重而不想從頭訓練的團隊。
- latent tokens 減少 8×,VBench 分數接近未壓縮模型
- 480×832×81 輸入的延遲降低 11.1×
- 736×1280×81 輸入的延遲降低 15.5×
- 需要按儲存庫提供的環境重現,樣本內容可一致,但不同環境不保證 byte-level 完全相同
安裝及測試時,應先依照項目提供的權重和依賴設定重現結果;提醒部分代理會阻擋指定 PyTorch wheel 來源,檢查 reproduction 時不應額外安裝 FlashAttention,因為 SDPA 已經使用 flash kernel。GRACE 的價值在於以較低推理成本延續既有 DiT 能力,但是否適合生產環境,仍要按硬件、影片尺寸和模型管線重新量度延遲與畫質。