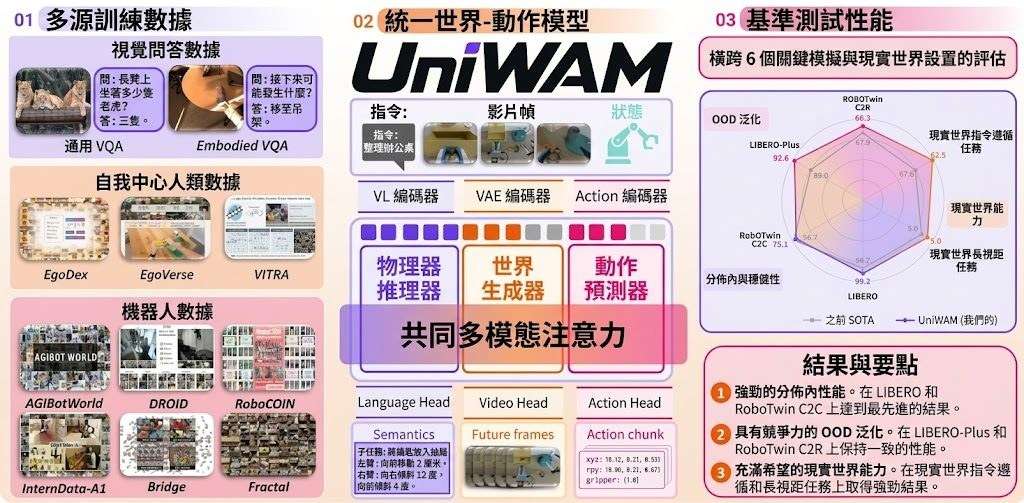
面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。
模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。
- 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
- 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
- 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
- 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時
GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。
項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。