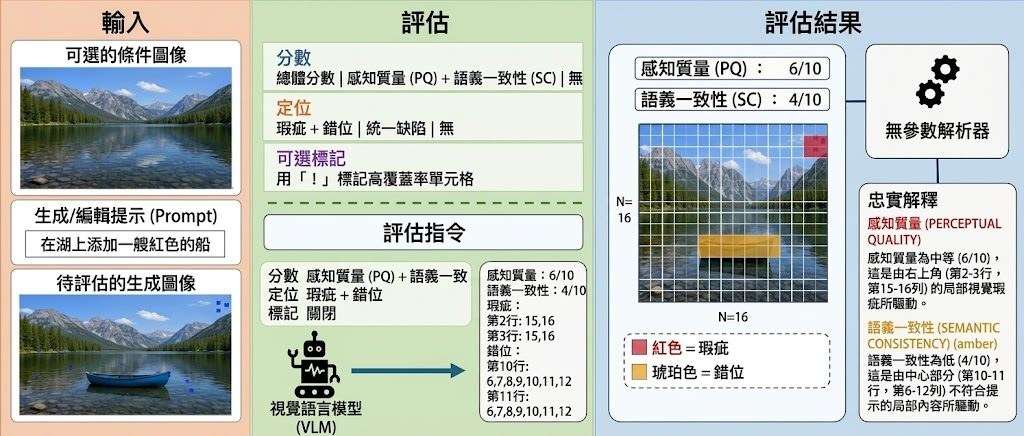
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。
Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。
相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。
GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。
- 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
- 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
- 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
- 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。