SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

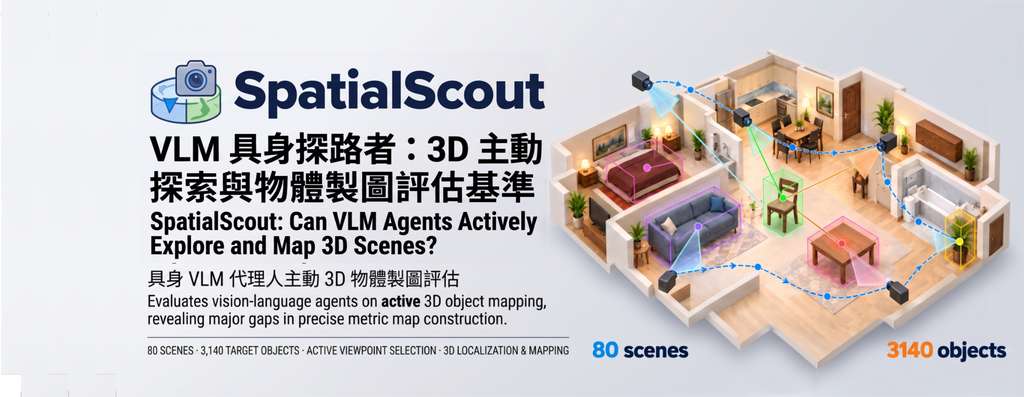
SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

Agent4Sci 把 AI 編程代理放進真實科學實驗場

AI 編程代理能否在有限算力、沒有人工協助的情況下,超越論文已發表的最佳結果?Agent4Sci 讓代理在真實機器學習科研任務中接受長時間測試,並檢查成果是否可信。

protocol

面對一篇研究論文、程式碼、訓練資料和指定指標,AI 編程代理能否在固定算力內推進結果?Agent4Sci 是一個長時間測試與評估工具,涵蓋 11 個科學領域的 20 個基準和 25 項任務,檢視前沿代理在沒有人工協助下能否超越已發表的最佳表現。

它不以排行榜為目標,而是讓代理在標準化環境中修改程式、執行實驗和提交成果。每項任務會先核對已發表的基準結果、修整資料切分,並封存測試集;代理只能查看訓練及驗證資料,避免直接利用測試答案調整結果。

評估分成三步:代理進行實驗並提交成果,另一個代理在封存的測試集上評分,第三個代理則審查過程有否選擇性呈報、測試資料污染、操弄指標或硬編碼輸出。這種分工有助分辨模型進步是否來自有效研究,而非鑽評測漏洞;但長時間實驗本身結果波動較大,作者也提醒應把結果視為研究能力的探測,而不是穩定排名。

  • 覆蓋 20 個基準、25 項任務及 11 個科學領域。
  • 以固定運算預算測量代理相對於已發表最佳結果的進步幅度。
  • 測試集封存,並由獨立階段評分及審查評測操弄風險。
  • 提供 research、experiment 和 checklist 工作流程,分別支援文獻引導構思、實驗安排及定期檢查研究方向。

研究團隊、AI 代理開發者及機器學習科研團隊,可用它檢查代理能否在真實程式碼和資料條件下完成持續實驗,而不只是產生看似合理的修改。儲存庫提供 agent4sci run 執行評估流程,另有後端與自建基準容器的說明;提供的資料未列出完整安裝及模型預設細節,因此無法據此判斷所需 API、算力配置或具體執行時間。

GitHub

Categories: 開源, Agentic, 模型, 模型訓練, API, 工具, 庫, 編程

PrismaCoder 的多模態生成

多模態程式碼智慧將程式的符號世界與其執行所產生的視覺世界連結起來。

PrismaCoder: Open Multimodal Code Intelligence

從文字或視覺輸入生成圖表、網頁、示意圖、文件和動畫,PrismaCoder 是一系列開放的多模態程式碼模型,處理的不只是程式能否執行,也包括輸出畫面是否符合要求。這對需要快速製作圖表、前端介面或科學文件的開發者和研究團隊,提供了涵蓋多種視覺程式任務的模型選擇。

它的訓練流程 PrismaForge 會為每項指令建立評分規準,分開檢查程式碼與渲染結果,再用相同規準篩選訓練資料及提供強化學習獎勵。這做法把「程式寫得對」和「畫面呈現得對」分開衡量,減少只靠整體印象評分所帶來的偏差。

模型以 Qwen3.5 為基礎,提供 9B 和 35B-A3B 兩種規模,並各有監督式微調(SFT)及強化學習(RL)版本。PrismaCoder-2M 資料集涵蓋圖表生成與重建、網頁介面、互動示範、向量圖像、科學文件及化學圖形等任務;評估工具包括 VisPlotBench 和 ChemDraw。

  • PrismaCoder-9B 的 SFT 與 RL 權重均可取得;35B-A3B 的 RL 權重仍在上載中。
  • 項目網站稱模型在圖表、前端頁面和半結構化文件任務中領先開放模型,並能匹敵或超越部分專有系統;具體分數需查看網站或論文。
  • 儲存庫已提供格式專屬執行與渲染檢查、多模態資料合成,以及 Python、SVG、HTML 的文字評分工具;PrismaForge 完整評分與資料篩選流程,以及 SFT、RL 訓練腳本仍未完成。

模型權重和資料集可經 Hugging Face 項目頁取得;不過,儲存庫目前未提供完整訓練流程,35B-A3B 的 RL 權重亦未上架。想先驗證生成品質的團隊,可參考 VisPlotBench、ChemDraw 評估程式和互動示例;若要自行重現訓練,則要留意腳本尚未開放。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 工具, Python, 庫, 動畫, Dataset 數據集, 強化學習

DONIC:基於人類示範的通用型靈巧雙手追蹤控制

DONIC 讓一個控制策略同時操作兩隻靈巧機械手,模仿人類雙手示範。模擬測試中,即使遇上訓練時未見的物件,也毋須微調便能完成追蹤。

banner

模仿雙手操作時,難處不止是讓每隻手跟上動作,還要同時配合物件的位置與接觸方式。DONIC 是一套靈巧雙手追蹤控制策略,讓同一個策略控制兩隻 Wuji 機械手,依照人類雙手示範操作物件,並嘗試泛化到未見軌跡和未見物件。

它以五個公開手部與物件資料集,以及 BiHOI 訓練。BiHOI 收錄 1,575 段雙手互動序列,涵蓋 229 件物件和 14.77 小時操作紀錄;研究團隊使用 32 部校準相機拍攝,再重建雙手與物件動作。對機械人研究團隊而言,這套資料處理流程有助把多視角人手示範轉成可供機械手學習的動作參考。

訓練方法亦針對雙手配合調整:每隻手按示範所要求的接觸方式獲得獨立獎勵,避免一隻手的進度掩蓋另一隻手的失誤;PPO(近端策略最佳化)則配合行為克隆,並把經回放驗證的成功操作加入示範資料,供後續訓練使用。這比只追蹤手部姿勢更重視物件與兩手接觸,但結果仍取決於示範資料和模擬環境能否涵蓋目標操作。

在 Isaac Gym 模擬測試中,DONIC 對未見軌跡的成功率為 86.79%,對未見物件則為 57.32%,均毋須微調。相較研究團隊以相同資料池訓練的 DexTrack 與 Dexplore 雙手改編版本,成功率分別高出 77.36 和 45.73 個百分點;加入 BiHOI 後,兩項成功率再升至 88.68% 和 59.76%。這些是模擬結果,不能直接視為真實機械人環境的表現。

現階段較適合把 DONIC 視為研究原型,而非可直接安裝運行的完整控制工具:訓練與評估程式碼、策略檢查點及 BiHOI 資料集尚未公開,已提供的是 BiHOI 處理流程。現有內容可讓研究團隊檢視資料建構方式與模擬結果,但要重現策略或在實體機械手上測試,仍需等待相關程式碼、模型及資料釋出。

  • 模型權重、MANO 資產和資料集不會在此處分發,並且仍受其原始許可的約束。
  • 單一策略同時控制兩隻 Wuji 靈巧機械手。
  • 訓練資料結合五個公開資料集與 BiHOI 多視角雙手互動紀錄。
  • 模擬中未見軌跡成功率為 86.79%,未見物件為 57.32%。
  • 加入 BiHOI 後,兩項成功率分別升至 88.68% 和 59.76%。
  • 訓練與評估程式碼、策略檢查點及 BiHOI 資料集仍未公開。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, 工具, Dataset 數據集

TextRIRO:修改文字內容並保留原始風格

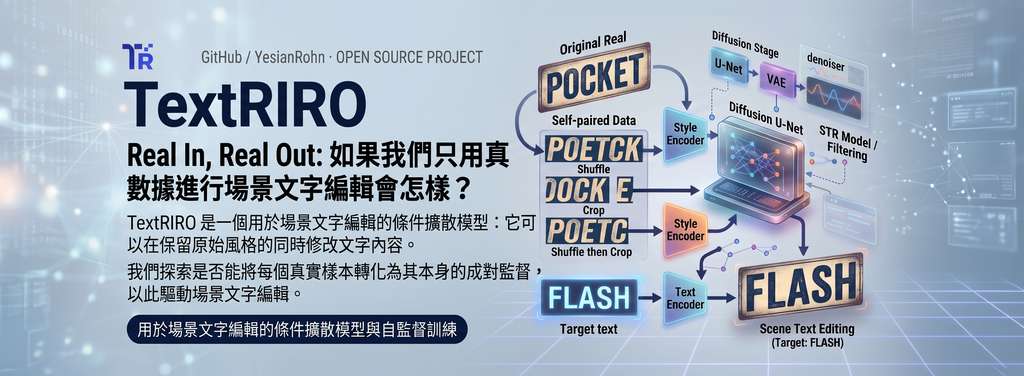
讓圖片中的文字換內容、留風格,但處理範圍限於裁切文字區域,項目暫時只是作為研究,因此生成解像度亦有限制。我仍為這研究有助 Diffusion Model 發展更多的應用

TextRIRO training, inference, STR-pretrained text encoder, and TextRIRO-3M construction pipeline

招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。

它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。

「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。

  • 可透過 Hugging Face Demo 試改文字。
  • 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
  • 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
  • RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。

文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。

GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Stable Diffusion, Image, Python, 庫, Dataset 數據集

Spectral-Spatial-Interpretation(SSI ) 讓多光譜模型看清每個通道的作用

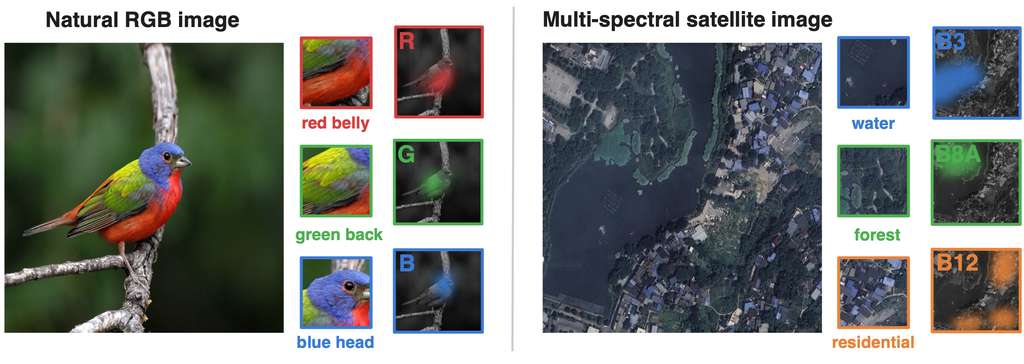
多光譜模型不只要知道哪個位置重要,還要分辨該位置由哪些通道推高或拉低分數。SSI 以 Shapley values 提供更細緻的解釋。

Figure 1: spatially varying channel relevance in RGB and multispectral images

面對多光譜影像,單一熱圖往往只說明哪裏重要,卻未能交代該位置的光譜通道如何影響結果。SSI(Spectral-Spatial Interpretation)屬於模型解釋工具,為每個空間 cell 和 channel 計算帶正負號的 attribution,拆解模型分數由哪個位置及哪個通道推動。

SSI 固定該 cell 以外的影像內容,只在 cell 內比較不同通道組合,再以 Shapley values 分配貢獻。所有通道貢獻會加總至該 cell 從遮罩狀態到原始狀態的分數變化,因此可分別彙整成 spatial map 或 spectral summary;正值代表推高分數,負值代表拉低分數。

項目提供獨立 NumPy 實作,支援 exact subset enumeration 和 sampled channel permutations,亦附有瀏覽器 Playground、Visual Atlas 及五分鐘互動教學。測試時可先用 Playground 觀察結果,再以 ssi.py 對自己的模型分數和遮罩 baseline 重現分析;通道數增加時,精確枚舉的成本亦會上升,抽樣排列是較可行的取捨。

與 Integrated Gradients (IG)、DeepSHAP、KernelSHAP 及 rank-1 RISE 比較,SSI 在三個資料集、兩種 masking baseline 下,三項指標的平均結果均居首;例如 mean-baseline HLS joint deletion 為 0.1545,KernelSHAP 為 0.2096。它較適合需要同時追蹤空間位置與光譜通道的遙感、農業或科學影像團隊,但要留意各 cell 的貢獻不一定能加總成整張影像相對 baseline 的總變化,因為 SSI 解釋的是條件式局部遊戲。

  • 同時回答「哪裏重要」與「哪個通道重要」
  • 保留正負貢獻,能分辨推高或壓低分數的因素
  • 支援精確計算及排列抽樣兩種方式
  • 可用 spatial map、spectral summary 和 deletion 指標檢查結果
  • 適合多光譜模型,但需留意計算成本及跨 cell 互動限制

項目主頁 · GitHub

Categories: 開源, 模型, Image, 影像處理, 教學, 工具

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

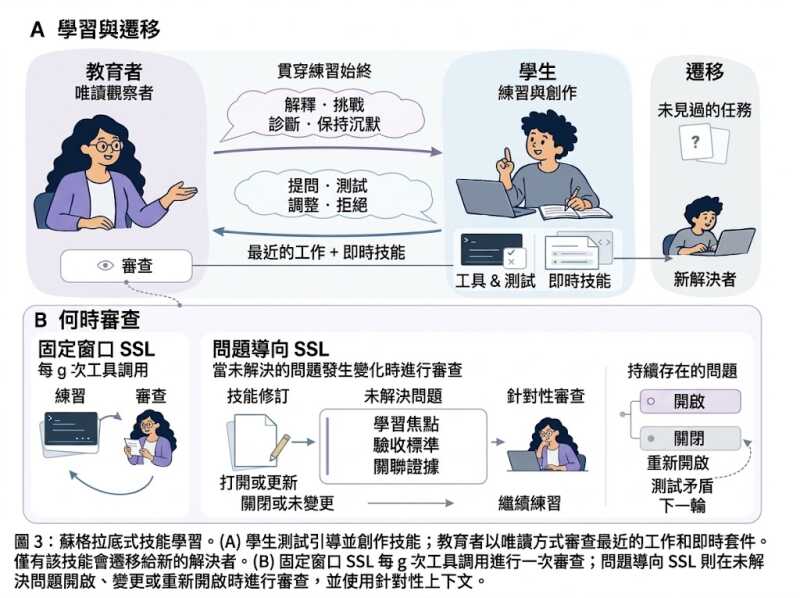
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

MOSS Image Edit:一句指令改圖兼支援四圖參考

把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

MOSS Image Edit — 用文字编辑图像

要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

三分鐘攪掂 PHP2Shell 漏洞

完全解決管方已停止更新的版本!PHP2Shell 可讓未驗證攻擊者接管伺服器。Ubuntu 管理員應停用舊版 mod_php,並將 PHP 升至已修補版本。

這方案 針對所有 Ubuntu PHP 舊版本已停止更新,能馬上修復 Ubuntu、Apache 與 mod_php 的網站。避免因 PHP2Shell 面臨未經身分驗證的遠端程式碼執行風險。這項問題涉及 CVE-2026-109618 及 CVE-2026-109619,CVSS v4.0 評分為屬嚴重級別 9.2。

問題是 PHP 8.1 及更舊版本已停止支援,而漏洞源自 PHP 核心記憶體管理,攻擊者可透過特定惡意請求觸發 Use-After-Free,並利用記憶體耗盡等而取得程式執行能力。當 Apache 透過 mod_php 與 PHP 共用行程及記憶體時,影響範圍可擴至整個網頁伺服器,遠端程式碼執行(Remote Code Execution,RCE)風險尤其直接。

安全處理方發是把執行環境切換至已修補版本。我們以 Ubuntu 22.04 為例,加入 Ondřej Surý PPA、安裝 PHP 8.3 及所需擴充套件,再停用 php8.1、啟用 php8.3,並重新啟動 Apache;實際環境亦要按原有版本及網站套件調整。

  • 受影響編號:CVE-2026-109618、CVE-2026-109619
  • 建議版本:至少 PHP 8.2.35、8.3.36 或 8.4.27
  • 高風險組合:Apache mod_php 加未修補 PHP
  • 關鍵動作:停用舊模組、檢查版本、重啟服務

驗證不能只看 CLI 輸出,也要確認 Apache 實際載入的新模組及網站依賴的擴充套件。涉及 PHP 8.1 的環境應先安排相容性測試;安全版本要求與頁面所示 PHP 8.3 範例亦應分開核對。

項目主頁

Categories: 軟件, 工具, Linux, 庫, 安全

RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

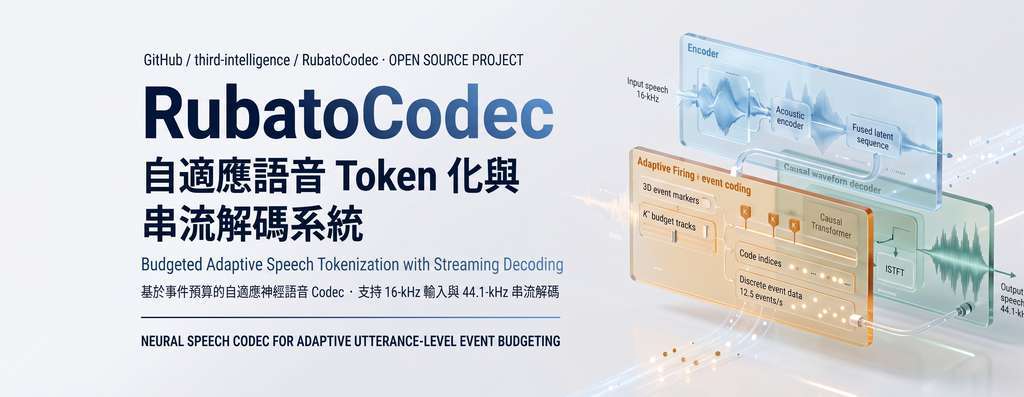
固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。

RubatoCodec architecture

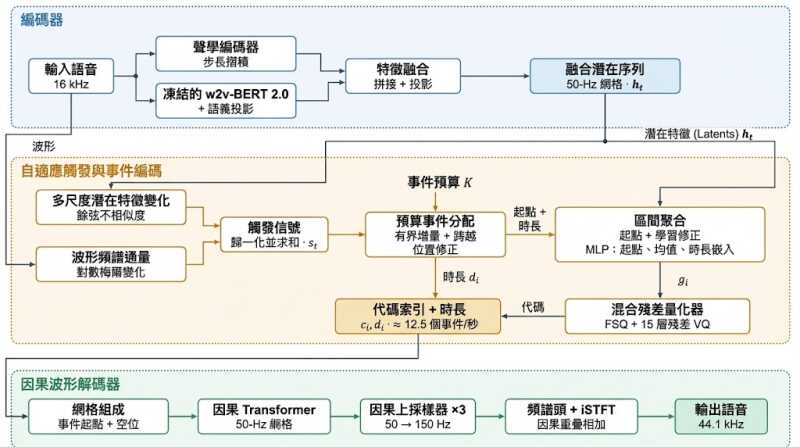
語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。

量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)

GitHub · 模型

Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

Page 7 of 183
1 … 5 6 7 8 9 … 183