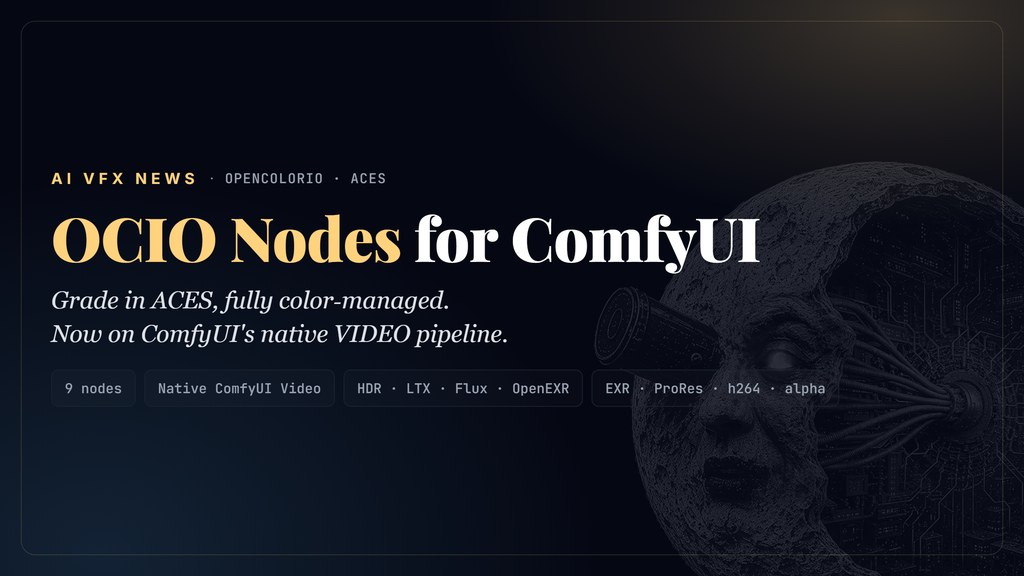
ComfyUI-OCIO:ComfyUI 直通 ACES 與 HDR 的色彩管理節點

由模型輸出到 ProRes、EXR 或 HDR 交付,ComfyUI-OCIO 保留更多影像色彩與亮度資訊。

OCIO Nodes for ComfyUI - by AI VFX NEWS, Slava Sexton

由 LTX、Flux 或其他影像流程產生的 HDR、Cineon 及 10-bit 影片,可以在 ComfyUI 原生 VIDEO wire 內完成色彩管理、ACES 調色及輸出。ComfyUI-OCIO 屬於 ComfyUI 自訂節點項目,處理的是模型解碼後容易被截斷、降位深或轉成 4:2:0 的影像資料。

核心差異在於 OCIO VAE Decode 以 float32 解碼,而且不會把數值夾到固定範圍;低於 0 的值亦會保留,讓超出工作色域的顏色和場景線性動態範圍交由 OpenColorIO 轉換。普通 SDR 生成不會因取消 clamp 自動變成 HDR,素材本身沒有相關範圍時,收益亦會有限。

LTX-2.5 可經由 ACEScct 路徑接入其 HDR path,補足 ComfyUI 原生流程未能直接觸及的部分。輸出可包括 32-bit float EXR、ProRes 4444 10-bit 4:4:4、DPX log,以及 Rec.2100 PQ/HLG;FFV1 才能做到無損保存,ProRes 讀回則以 12-bit 處理並承載 10-bit 資料。

ComfyUI-OCIO 提供的單一 LTX-2.5 測試中,模型浮點母片有 2304 個亮度級別,該項目的 ProRes 4444 版本保留 3520 個可辨識級別,與母片可辨識差異為 0.0001%;原生 10-bit 流程則為 882 級,出廠流程只有 220 級。安裝所需依賴包括 OpenColorIO、OpenCV、tifffile、Pillow、numpy 及 FFmpeg,但資料未提供完整圖形化操作步驟;較適合熟悉 ComfyUI、ACES 和影片編碼的 VFX、影片生成及後期團隊。

  • 保留 float32 解碼結果,不強制限制亮度範圍
  • 支援 ACES、HDR、Cineon、LTX、Flux 及 10-bit 影片流程
  • 可在原生 VIDEO graph 內讀取序列、調色及寫出影片
  • LTX-2.5 可經 ACEScct 進入其 HDR path
  • FFV1 適合無損保存,ProRes 4444 適合交付

GitHub

Categories: 開源, ComfyUI, AI productions, Video, LTX

UI-Venus:多平台介面的高性能代理

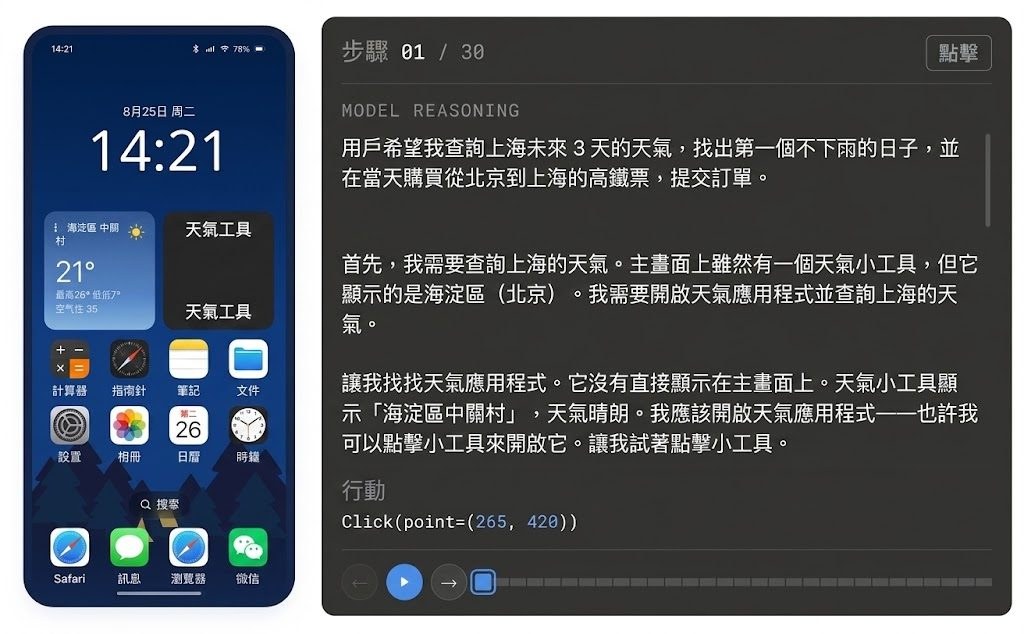
UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

[教學影片] Seedance 2.5 逼近寫實 AI 影片生成

Seedance 2.5 走向超寫實 AI 影片生成,重點放在畫面真實感同創作效率。這類工具適合想快速做出貼近真人拍攝效果嘅內容製作者。

Og image

Seedance 2.5 透過影片生成能力,主打把 AI 片段做得更貼近真實拍攝感,適合內容創作者、短片製作同需要快速試片嘅工作流。片段描述雖然唔多,但方向好清楚:重點唔係花巧效果,而係提升畫面可信度同整體觀感。

對一般創作者嚟講,呢類模型最有用之處係可以縮短由構思到成片嘅時間,尤其係要做概念片、廣告草稿、社交平台短片,或者先行測試視覺風格嘅時候。它強調 ultra realistic,代表畫面一致性、材質細節同動態自然度會係主要賣點。

不過,原始資料只提到示範與推廣用途,未有交代訓練細節、評測指標、輸入限制或實際可否隨意下載使用,所以唔適合自行推斷佢嘅開放程度。現階段較合理嘅理解係:Seedance 2.5 係一個面向高寫實影片生成嘅模型/服務,重點在於實用視覺效果,而唔係提供完整技術規格。

  • 主打超寫實 AI 影片生成
  • 適合短片、概念片同視覺草稿
  • 核心價值係提升真實感同創作效率
  • 原始資料未交代下載、開放程度同技術細節
  • 內容明確偏向影片模型與線上服務場景

項目主頁

Categories: Video, 提示詞, 教學

Breeze TTS 2 即時語音生成

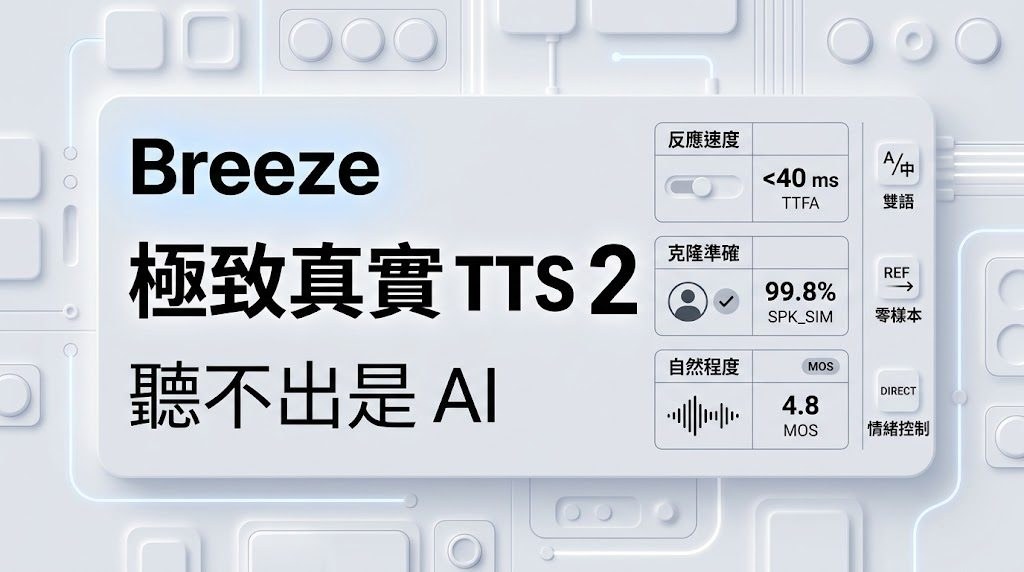
Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

StudentSim:為每個學生建立模擬器,令輔導教學更準

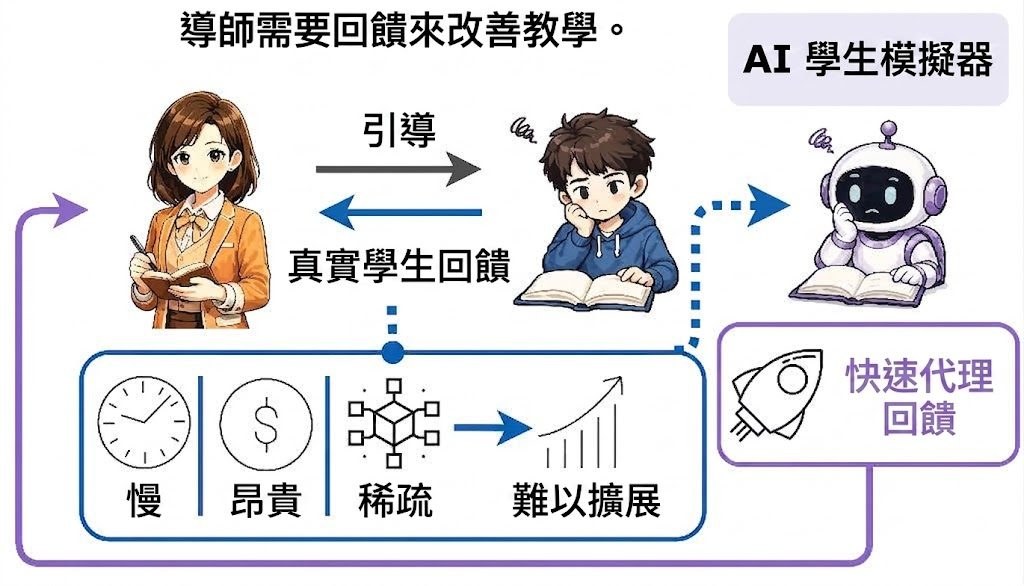
StudentSim 把稀疏的學生紀錄轉成個人化模擬器,用來測試哪種提示或輔導真正改變答案。它同時處理答題相似度與對指導的反應,適合做教學策略比較。

fig motivation

StudentSim 是一個由 Microsoft 研究的工具套件,核心是替每位學生建立獨立模擬器,解決「真實學生回饋太慢、太少、太貴」這個輔導優化難題。它先從多名學生的資料做 pooled training,再針對單一學生做 specialization,讓模擬器不只答得像,還要在收到指導後出現和原學生相近的變化。

它涵蓋 chess、second-language English writing (L2) 和 middle-school mathematics 三個場景,安裝時可按需要選擇 chessl2mathinferencetutor_rlbaselines 等 extras。訓練與評估可以在本地按模組跑起來,若要做 tutor reinforcement learning,還需要 libcairo 供棋盤繪製;涉及語言模型的步驟則要設定 AZURE_OPENAI_ENDPOINTAZURE_OPENAI_API_KEY

和一般只模仿答案的做法相比,StudentSim 更重視兩件事:一是 behavioral fidelity,二是 guidance responsiveness。前者看模擬器有沒有保留學生的能力層次與弱點,後者看學生收到輔導後會不會像真實紀錄那樣改變答案;在 chess 裡,它還示範了把 student simulator 當成 reward 來源,直接訓練 AI tutor 產生更有效的指導。

  • 可用來比較不同輔導語句對同一學生模型的影響
  • 適合教學科技、學習分析和 AI tutor 研究團隊
  • 支援多領域資料,方便觀察模型在不同學科的差異
  • 提供 closed-model baselines,方便和角色扮演式提示做對照
  • 評估不只看答對率,也看指導後是否真的改變行為

項目主頁 · GitHub

Categories: 開源, 模型訓練, 微軟

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Image, Python, Dataset 數據集

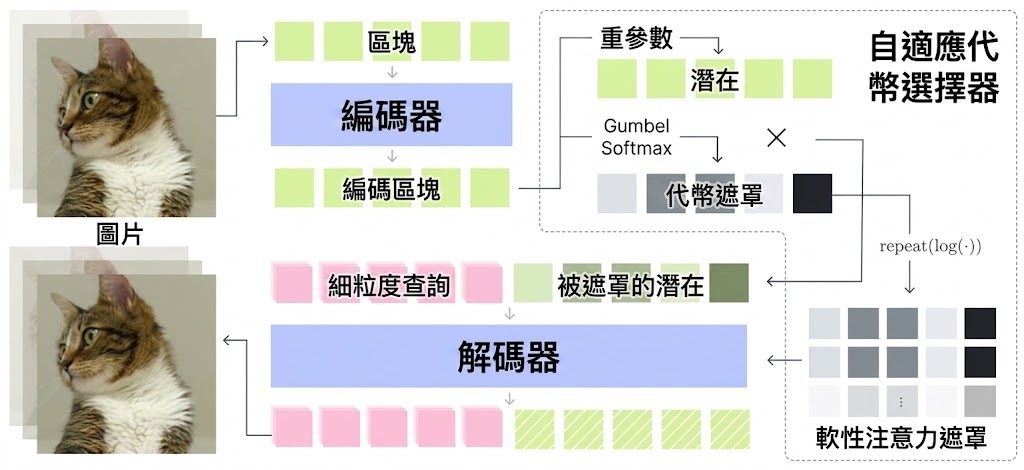
KATok 教影片 VAE 自己丟 Token 減運算量

Kakao 開源 KATok,一個會根據內容自動決定保留多少 token 的影片 VAE,靜態畫面用得少,動態場景留得多,省下的算力直接交給下游擴散模型。

Repository image for kakao/KATok

KATok 處理嘅係影片生成入面一個常見但少有人拆開嚟解決嘅問題:傳統影片 VAE 用固定壓縮比,無論係一張幾乎唔郁嘅定鏡,或者主體快速移動嘅場面,每段都會被切成同一個 token 數。呢種做法喺靜態片段上明顯浪費頻寬,令擴散模型要做好多無意義嘅工作。

佢嘅做法係喺 transformer VAE 嘅 latent bottleneck 加一個可學習嘅 keep-or-drop 決策,對每個 token 估計要唔要保留,仲會一齊學 latent 表示。遮罩同時控制 latent 值同 decoder 嘅注意力,decoder 用 coarse-to-fine 結構由稀疏 token 重建細節,因此 token 數變成內容嘅結果,而唔係預設參數,亦唔需要推理時搜索。

喺 Panda-70M 256²×16 設定下,平均 366 個 token 就可以達到 31.24 PSNR 同 5.12 rFVD;喺 UCF-101 嘅稀疏生成實驗中達到 61.53 gFVD,比 dense transformer tokenizer 訓練快 6.9 倍。代價係當 token 被丟棄後空間佈局會被打亂,所以佢哋仲設計咗 cascaded mask prior 同 joint content–position 變體,幫下游擴散模型補返結構。

值得留意嘅重點:

  • 自適應 token 化,內容決定 token 數,無需推理時搜索或人手調參
  • 喺 Panda-70M 用 366 個 token 達到 31.24 PSNR / 5.12 rFVD
  • UCF-101 稀疏生成快 6.9 倍訓練速度,質素達 61.53 gFVD
  • 提供 inference code 同權重(仍在內部審核),訓練碼暫未開源
  • 直接用 PyTorch SDPA 即可行,安裝簡單

如果你嘅團隊需要處理大量冗餘嘅影片片段,又想慳運算量畀下游生成模型,呢種由內容決定 token 數嘅做法比起單純壓解像度更貼近問題本質。

項目主頁 · GitHub

Categories: 開源, Image, 推理引擎

Skill Router:讓 Agent 自己揀技能,毋須死記名稱

Agent 工具愈多愈難揀?Skill Router 在主 LLM 之前先用確定性規則分類請求,只選出一個主技能加必要輔助技能,仲會擋住高風險操作。

Repository image for luxurylifestyleco/skill-router

工具愈裝愈多,Agent 執行前最頭痛的往往係「到底應該召喚哪一個 skill」。這個名為 Skill Router 的開源項目正正針對這個痛點:它在主 LLM 介入之前,先以一套確定性(deterministic)方式把用戶請求分類,再揀選一個主技能配搭必要的輔助技能,最後輸出一份可供審計嘅裁決結果,而唔會將本地整份技能清單外洩。對管理大量工具嘅 Agent 開發者來說,這層路由令請求與執行之間多了一道可控嘅分流閘。

路由背後嘅結構相當直接:請求會先落入 8 個 action bucket(sense、understand、decide、create、operate、verify、learn、govern),再對應到 4 個 purpose bucket(data-enrichment、orchestration、utility、verification),然後再評估風險同依賴。分類完成後,系統會套用技能 manifest 內嘅 bucket、agent 同 skill 政策,只回傳最終被選中嘅配對。如果偵測到無效 manifest、缺失證據或依賴未就緒,路由會 fail closed 而唔係硬揀一個;如果請求涉及治理或具物質影響,就會觸發 Human Gate,將決定權交返俾人。

同坊間常見嘅「LLM 自己揀工具」做法相比,Skill Router 嘅取捨係將選擇權交給預先定義嘅規則,LLM 只負責執行被揀中嘅技能。犧牲咗一定靈活性,但換來可預測性同審計能力,亦避免將內部技能清單完整暴露俾模型。公開版本唔打包私有目錄、不打遠端服務、不收集遙測數據,運行環境只需要 Node.js 18+,零第三方依賴,並支援 Windows、macOS 同 Linux。

對於需要管理十幾甚至幾十個 skill、又要顧及合規同可審計性嘅團隊,例如內部 Agent 平台、企業自動化流程或帶敏感操作嘅助手,這層路由可以作為統一入口。對一般開發者而言,佢亦提供咗一個清楚嘅分類同風控範式,幫助避免「LLM 亂叫工具」嘅常見問題。

重點摘要

  • 請求先分流、後執行:8 個 action bucket 對應 4 個 purpose bucket,喺主 LLM 之前完成分類。
  • 只回傳必要技能:一個主技能加最少輔助技能,避免將整份本地目錄暴露。
  • 高風險自動擋住:治理或具物質影響嘅請求會觸發 Human Gate,由人手把關。
  • 缺資料就 fail closed:無效 manifest、缺失證據或依賴未就緒會直接 blocked,唔會硬猜。
  • 零依賴、易部署:Node.js 18+ 即可運行,公開包不含私有目錄或遙測,跨平台可用。

GitHub

Categories: 開源, Agentic, Mac, Linux, Skill 技能

LightNav-0:一句說話驅動四種機械人零樣本導航

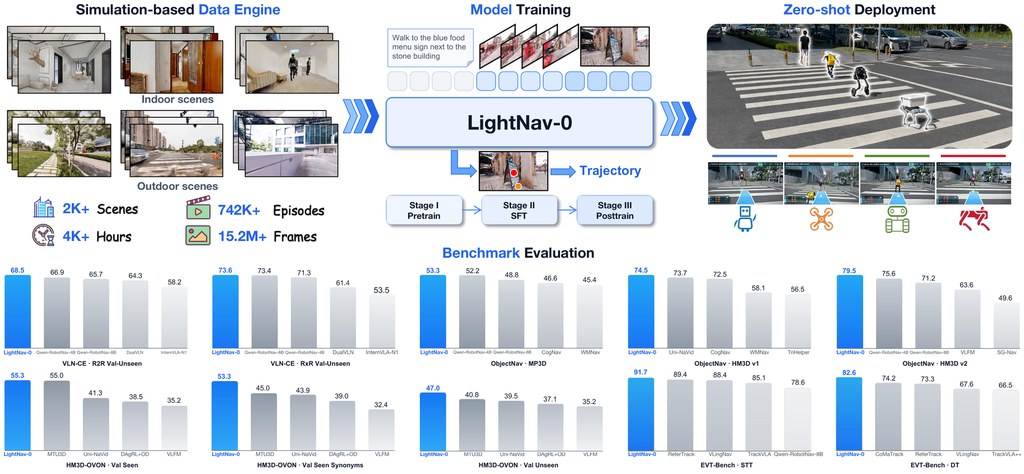
LightNav-0 是一個通用導航模型,把預訓練視覺語言模型 Qwen3-VL 的空間認知能力對齊到導航任務,無需任務專用頭即可同時處理指令跟隨、開放詞彙物件導航與視覺追蹤,並零樣本遷移到人形、四足、輪式及空中機械人。

LightNav-0 overview: a simulation-based data engine, three-stage model training, zero-shot deployment onto four robot em

你叫一部機械人「去到公園入口嗰張長椅」,佢就要自己搵到、避開障礙、仲要處理自己對眼睇到嘅畫面——LightNav-0 就係針對呢類跨場景、跨形態嘅導航需求。佢屬於模型類項目,核心想解決嘅問題係:傳統導航系統每換一種機械人或場景就要重新訓練或加任務頭,零樣本泛化能力薄弱。LightNav-0 選擇唔加 waypoint predictor、唔加任務專用動作頭,淨係擴展詞表,加入雙通道指向 token 同 RVQ 動作 token,等空間推理同動作編碼都直接由 Qwen3-VL-4B-Instruct 原有嘅自回歸 LM head 解碼。

要做到呢點,訓練數據係關鍵。項目用咗一套 Real2Sim2Real 數據引擎,將 2,000 幾個互聯網收集嘅真實場景轉成可重複使用嘅模擬環境,產生 4,000 幾個鐘嘅視覺語言動作經驗,再分三階段訓練:Embodied Reasoning 中訓練、Embodied SFT、Online RL。呢種做法繞過咗真實遙操作收集速度慢、成本高嘅瓶頸。

同典型做法比,差異在於用模擬合成代理真實經驗,再透過統一 token 介面讓指令跟隨、開放詞彙物件導航、視覺追蹤共享同一模型,部署時直接零樣本落地到四種機械人形態,唔需要逐個微調。結果方面,官方指 LightNav-0 喺十個模擬設定上取得 state-of-the-art,並喺人形、四足、無人機同輪式機械人上完成真實遷移測試。

做機械人通用導航研究嘅團隊、要做具身 AI 落地嘅初創,或者關注 Physical AGI 路線嘅研究者,會最容易從中受惠。對一般開發者嚟講,理解入口係 Hugging Face 上嘅模型權重、論文同項目頁提供嘅模擬評測結果。

重點摘要:

  • LightNav-0 係以 Qwen3-VL-4B-Instruct 為骨幹嘅通用導航模型,無任務專用預測頭
  • 用統一 token 介面同時覆蓋指令跟隨、開放詞彙物件導航同視覺追蹤
  • Real2Sim2Real 數據引擎將 2,000+ 真實場景轉化為 4,000+ 小時訓練經驗
  • 三階段訓練流程:Embodied Reasoning 中訓練、Embodied SFT、Online RL
  • 零樣本遷移至人形、四足、輪式及空中機械人,喺十個模擬基準宣稱達到 SOTA

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, Qwen, World-Action Model, Robotic, AGI

CogEvol-4B 離線模型在手機筆電直接生成完整互動課程

CogEvol-4B 把一句課程大綱變成結構化投影片 JSON 加可獨立運行的互動 HTML,全程在筆電離線完成,無需 API 或雲端。

BF16 slide render

一般提到 AI 自動生成教材,多半還是要連雲端 API 才能輸出 HTML,但 CogEvol-4B 的做法是把整個流程壓進一個 2.4 GB 的 Q4_K_M GGUF 檔案。它以 Qwen3.5-4B 混合架構(48 層 GDN 線性注意力 + 16 層全注意力)為底,經過五萬多筆生產驗證樣本的 SFT,再做投影片 RL 與 HTML RL 兩階段強化,結果是單次前向傳遞就能同時吐出結構化投影片和自包含的互動式 HTML,不需要任何外部依賴。

在 MacBook Pro M2 Pro 16 GB 上,模型跑出約 33 tok/s 生成、470 tok/s prefill,整份互動課程約六分鐘完成。對教師、培訓設計師或自學者而言,這意味著斷網也能把一行大綱擴展成可互動的學習素材,不用排隊等雲端,亦沒有 API 成本。

項目可整合 OpenMAIC 與評測工具,權重放在 HuggingFace,並已整合到開源平台 OpenMAIC,透過 .env.local 切換本地 provider,再加上一個 runtime brief expander 補丁即可在斷網環境下渲染所有 widget。

重點摘要:

  • 離線可用:模型、應用、素材全部本地,關 WiFi 仍能完整跑
  • 極輕量部署:單一 2.4 GB GGUF 檔,Apple Silicon、CUDA、CPU 皆可
  • 一鍵生成:一句大綱直接變投影片 JSON 加可互動 HTML,無需 agent loop
  • OpenMAIC 原生整合:本地 provider 設定加上補丁,斷網渲染 widget
  • 雙重授權:程式碼 MIT、權重 Apache 2.0,可商用且易於二次開發

項目主頁 · GitHub模型

Categories: 開源, Agentic, 模型, Qwen

Page 8 of 153
1 6 7 8 9 10 153