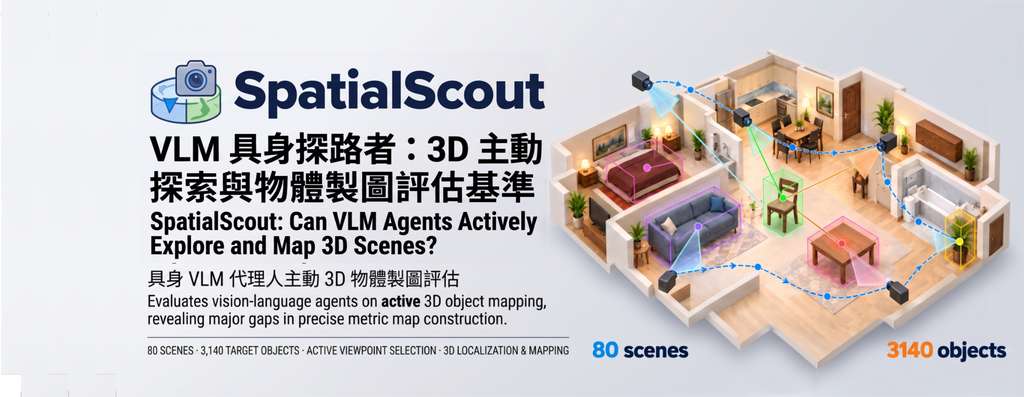
要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。
每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。
結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。
- 基準涵蓋 80 個室內場景及 3,140 個目標物件。
- 每項任務最多 100 回合,模型需主動選擇觀察視點。
- 評分同時考慮定位準確度與物件完整度。
- 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。
研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。