Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

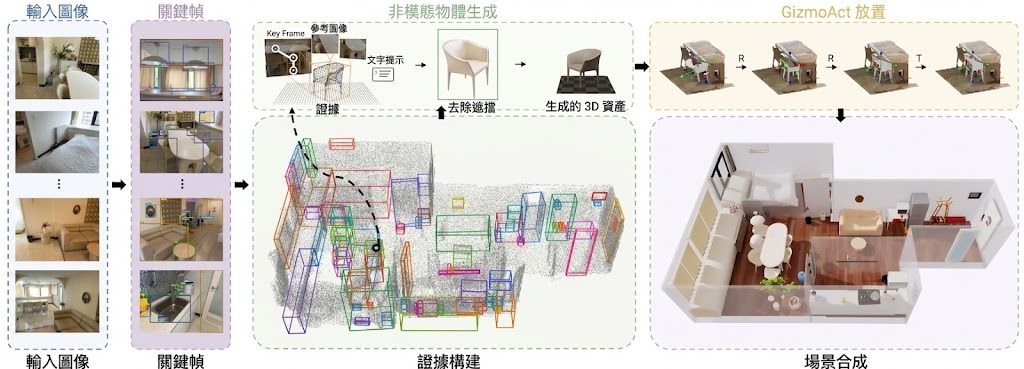
整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進
項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

VLA 模型只學動作不夠,INDI 把「意圖」蒸進解碼器

POSTECH 提出的 INDI 框架,將行為意圖從凍結的教師視覺語言模型蒸餾到 VLA 動作解碼器,讓機器人部署時不需教師也能自主推斷行為目標。

Repository image for Leesangoh/INDI

機械人模仿學習長期面對一個老問題:VLA(Vision-Language-Action)模型靠行為克隆訓練時,往往只學到「要做出什麼動作」,卻忽略了「為什麼要做這個動作」。POSTECH 團隊提出的 INDI(Intention Distillation),正正想修補這個缺口。

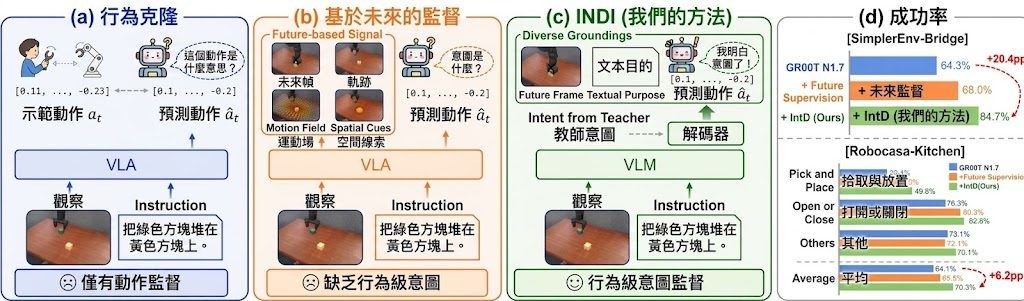
做法上,訓練期間會有一個凍結的教師視覺語言模型(VLM),負責將示範片段解讀為意圖表徵;動作解碼器則在中間層同時學習還原這個意圖與預測動作。部署階段不需要帶著教師模型,策略網絡自己就能從標準 VLA 輸入還原意圖並執行。對比傳統行為克隆或加入未來幀、軌跡這類「未來監督」做法,INDI 蒸餾的是行為背後的共同語義目標,而非某一種可能的實現。

實驗結果顯示,INDI 將 GR00T-N1.7 在 SimplerEnv-Bridge 的成功率由 64.3% 提升至 84.7%,在 RoboCasa Kitchen 也由 64.1% 升至 70.3%,π0.5 兩個基準皆有穩定增長。真實機械人任務平均成功率由 62.0% 提升至 68.7%,長時序任務最高有 12 個百分點的改善。研究團隊亦驗證還原出的潛在變量確實被解碼器使用,並能捕捉行為目標與執行進度。

對從事機械人基礎模型、VLA 微調,或關注長時序操作任務的團隊而言,INDI 提供了一條不增加部署成本、只改訓練目標的改良路徑。

INDI 重點摘要:

  • 意圖蒸餾而非動作模仿:用凍結教師 VLM 把行為意圖蒸進解碼器中間層
  • 部署零負擔:推理階段不需要教師模型,策略網絡自行還原意圖
  • 跨基準穩定提升:GR00T-N1.7 與 π0.5 在 SimplerEnv-Bridge、RoboCasa 皆有增長
  • 真實場域驗證:真機任務平均成功率提升約 6.7 個百分點,長時序任務最高 +12pp
  • 潛在變量可解讀:還原出的中間表徵與行為目標、執行進度高度相關

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, VLA, Robotic, 框架

LayerRecall 讓長影片生成記得返之前嘅角色

長影片 AI 最怕隔咗一段就認唔返角色同場景,LayerRecall 用記憶路由加選擇性注入,只喺敏感層補返歷史 K/V,效果贏過 MemoBench 同 MovieBench。

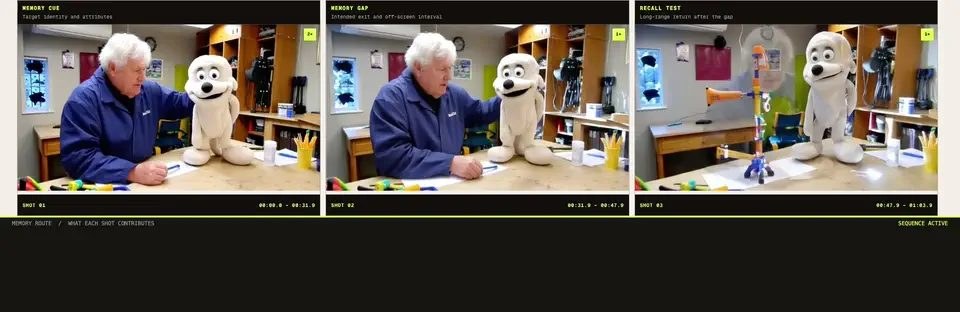
Memory Cue Recall animated preview

用 autoregressive 方式逐段砌長片,視窗一滑過去就會連角色同場景都一齊唔見——LayerRecall 就係針對呢個痛點。佢屬於記憶路由模組,唔係新模型,定位係加喺現有影片 DiT 上面做補強。當一段 chunk 入面出現需要回憶嘅元素(例如主角、服飾、場景)時,佢會用 current-conditioned 嘅方式去 historical candidate pool 做 cosine retrieval,搵到相關嘅 K/V state 之後再注入返去揀過嘅記憶敏感層,例如 4、9、10、12、13、15、16、17、18、26 等。其餘本地 attention 就照舊行,唔會因為補歷史資料而擾亂局部連貫性。

想理解點解要分層注入,研究發現唔同 layer 對「當下」「近期」「遠距」context 嘅依賑差好遠,所以亂餵歷史 token 反而會害咗本地一致性。配合嘅 KV cache budget 大約係 80 個 latent frames,本地 attention 32 幀,當中 8 幀做 sink、8 幀做 current chunk。訓練上仲用咗 Cross-Horizon Prediction Matching(CHPM),由一段長 context reference 喺 prediction space 監督呢個有界嘅 router,等佢喺稀缺長片數據下都學到幾時去 recall 乜嘢。

100 條多 shot prompt 評估入面,LayerRecall 喺 MemoBench 同 MovieBench 攞到最佳綜合結果,VBench-Long 維持返 backbone 水準,可見長距離回復做得好而本地連貫無受犧牲。論文仲展示咗 memory-guided self-correction,模型會主動糾正返之前嘅錯處。

重點摘要

  • 屬於記憶路由模組,設計上要喺現有影片 DiT 上加掛
  • 只喺 memory-sensitive 層注入歷史 K/V,其他層保持本地 attention
  • 訓練用 CHPM,用長 context reference 喺 prediction space 監督 router
  • MemoBench 同 MovieBench 綜合表現領先,VBench-Long 維持 backbone 水準
  • 適合做多鏡頭、跨時間角色同場景一致性嘅長影片生成工作

呢類工具對做長片創作、廣告分鏡或者角色需要反覆出場嘅團隊會幾實用;研究人員亦可以睇佢點樣將「selective injection」呢個取捨由啟發式變成可學習路由。

項目主頁 · GitHub

Categories: 開源, 香港大學, 視頻模型, 香港

GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

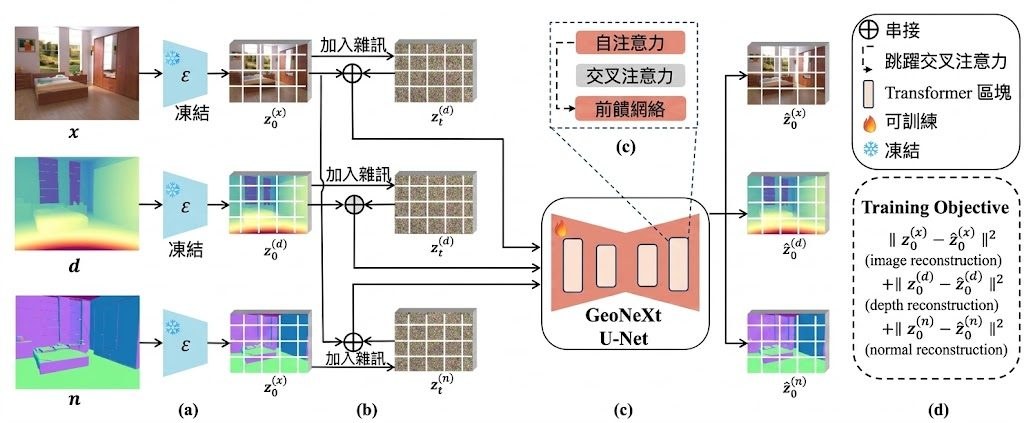
GeoNeXt framework

過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

H3 分鏡技能:分鏡及表情提示

這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然

GitHub

Categories: 開源, ComfyUI, Anthropic, MiniMax, Skill 技能

ABot-Recon 用 12 幀極簡局部記憶重建 3D

AMAP CVLab 提出的 ABot-Recon 放棄複雜的長程記憶機制,改用固定的 12 幀局部上下文,逐步拼接出穩定的長影片 3D 重建結果。

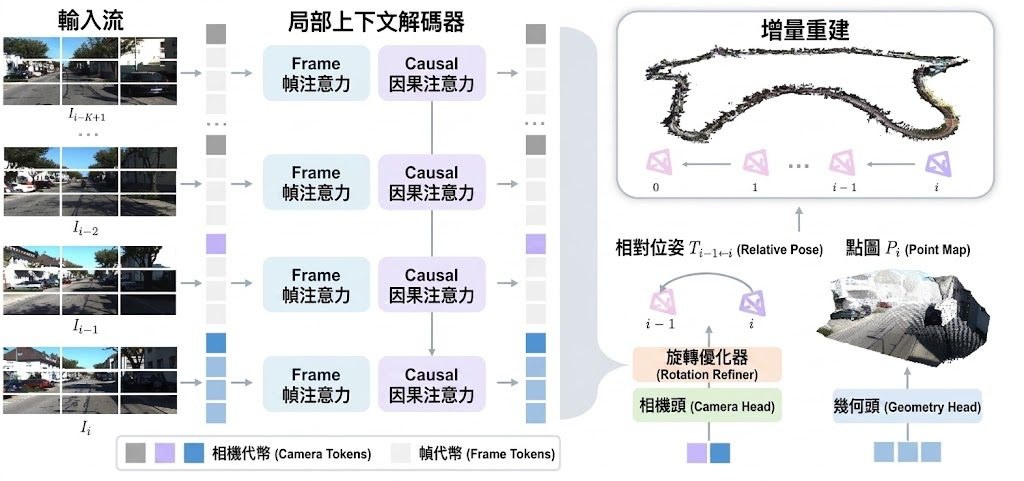
ABot-Recon long-horizon reconstruction teaser

ABot-Recon 是一款專為長影片流(streaming)設計的 3D 重建框架,來自阿里 AMAP CVLab。它選擇了一條反潮流的路線:不堆疊長程記憶模組,而是用固定的 12 幀局部上下文,邊看邊重建。對於自駕車、機器人或 AR 導航這類需要持續處理長影片的場景,直接解決了「序列越長、記憶越爆」的核心痛點。

運作上,模型每一幀只參考前 11 幀的 KV 特徵,預測當前幀的點圖(point map)與相鄰幀的相對位姿,再透過位姿串接逐步還原出全域軌跡與點雲。這意味著模型狀態記憶與單幀計算量都不會隨影片長度增長,硬體門檻更容易控制。

與傳統做法相比,ABot-Recon 刻意避開了持久學習式長程記憶,用一個輕量的 motion-visual rotation refiner 和 composition-aware pose loss 來壓制位姿累積誤差,把「記憶」的責任還給幾何拼接本身。

這套做法適合需要長時間穩定重建、又不想被龐大 GPU 記憶體綁架的團隊,例如自駕資料處理、機器人 SLAM 或城市級掃描項目。Hugging Face 與 ModelScope 已有現成 Demo 可即時試玩,模型權重同步開源;訓練代碼與完整訓練方案預計於 9 月 30 日前釋出。

重點摘要:
– 固定 12 幀局部上下文,拒絕堆疊長程記憶
– 記憶與單幀計算量與序列長度解耦
– 以位姿拼接 + 旋轉優化抑制長距離誤差累積
– Hugging Face / ModelScope 提供線上 Demo
– 訓練代碼與配方預計 9 月 30 日前開源

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 世界模型, Robotic, 3D

OpenClaw 2.0 重建介面與記憶連續性

OpenClaw 2.0把入門流程、對話延續同穩定性一併重做。對長時間使用 AI agent 的人,差別會先體現在找回上下文同減少中斷。

用得久嘅 AI agent,最怕唔係功能少,而係中途斷線、記唔住之前做過乜,或者想翻查舊對話時搵唔返內容。OpenClaw 2.0 針對呢類問題重做咗網頁體驗,亦加強咗 memory 同 session continuity,令長流程互動唔使成日由頭開始。

今次版本另一個直接影響體驗嘅改動,係 onboarding 變得更簡單。新手由安裝到開始使用嘅門檻降低,而舊用戶就會更在意 reliability pass 帶來嘅穩定性提升;更新說明同時提醒先備份 configuration 同 state,亦提到自動更新失敗時,可以用本地 coding harness 幫手完成更新、排錯同確認 Gateway 正常啟動。

文件列出咗一個幾實用嘅新能力:可以用完整字詞或片語搜尋可見對話內容,之後直接打開相符結果附近嘅訊息。對要追查工作脈絡、整理多輪討論,或者長時間同 agent 協作嘅人,呢個改動比單純加模型選項更有感。

  • 重做 web 體驗,介面與流程更貼近持續使用情境
  • 強化 memory 同 session continuity,減少對話中途斷層
  • 新增對話文字搜尋,可由結果跳回相關訊息位置
  • 做咗大規模 reliability pass,重點放在穩定運行
  • 更新時仍有 migration 要求,Plugin SDK compatibility 亦有保留與修補

OpenClaw 2.0 今次唔係靠單一新模型吸引注意,而係集中修補 AI agent 項目最常見嘅摩擦位:入門、延續性、搜尋同可靠度。對已經把 OpenClaw 放入日常工作流嘅團隊或個人,呢次更新代表系統更接近可長時間依賴嘅狀態;不過升級前後仍要留意 migration 與相容性檢查。

項目主頁

Categories: 開源, Agentic, OpenAI, API, OpenClaw, Anthropic

Code as World: 用於物理推理的智能體

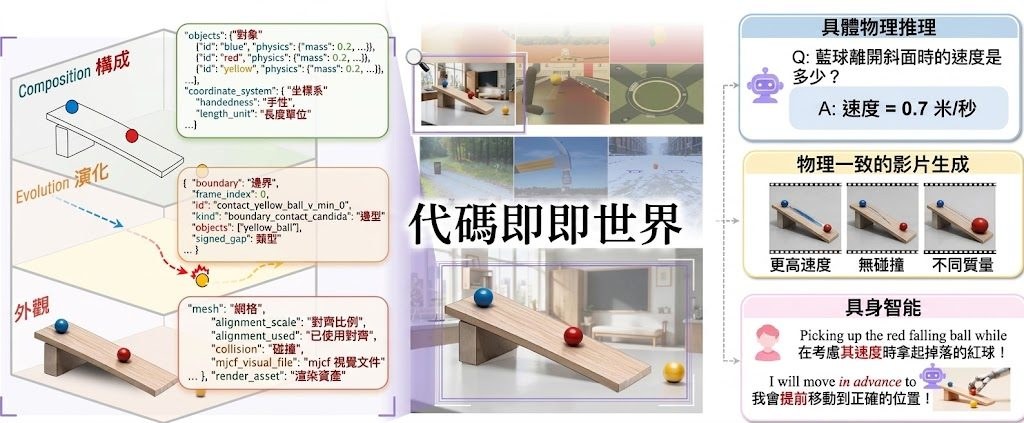
它把物理世界拆成可執行的程式表示,再用代理式流程反覆驗證與修正。你可以把它理解成一套把影像觀察轉成可推演世界模型的方法。

MirroS logo

Code-as-World 是一個面向物理推理的研究項目,核心做法不是直接死記像素,而是把世界整理成可執行的程式表示。這樣做的目的很直接:讓模型不只看見畫面,還能整理出物件、狀態、動態規則與彼此關係,方便後續推演和檢查。

它的做法帶有明顯的工具與模型結合味道,提供 Code-as-World-VL-4BCode-as-World-VL-9B 的本地推理與 QuantiPhy 評估。倉庫也提到可用 Python 3.10 或 3.11 在 CUDA 主機上安裝,代表它比較像研究團隊可重現實驗與推理流程的發佈形式,而不是單純示範頁。

和一般只靠像素特徵做判斷的做法相比,這個項目更著重可執行、可驗證、可調整的世界表示。代價是系統會更複雜,因為它要同時處理抽象、組合、模擬與一致性檢查,但換來的是更適合做反事實推演、診斷與物理場景理解。

  • 把物理世界表成程式,方便模擬和驗證
  • 支援本地推理與 QuantiPhy 評估
  • 4B、9B 版本已釋出,方便比較尺度效應
  • 適合做物理推理、世界模型與多模態研究
  • 量化結果顯示,較大模型的平均 MRA 有提升

對做多模態模型、世界模型、機械推理或具身智能的團隊,這類方法會比較有吸引力,因為它把感知和可執行結構連起來。若工作重點是要從影片或觀測中抽出可重用的物理表示,而不是只做單次辨識,這個項目提供了一條相當具辨識度的路線。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, NVIDIA, Dataset 數據集

FreeLLMAPI V2 模型整合成單一 API

想同時試多個免費模型,但唔想逐間服務商處理金鑰、路由同管理介面,呢個項目就係針對呢個痛點而來。它用 OpenAI-compatible API 包住多家供應商,方便你用同一套接法測試與切換。

Repository image for nglmercer/freellmapiV2

同一個應用想接 Google、Groq、Cerebras、SambaNova、NVIDIA、Mistral、OpenRouter、GitHub Models、Cohere、Cloudflare 同 Z.ai,最煩通常唔係呼叫模型本身,而係供應商差異、可用模型變動,同埋管理方式分散。FreeLLMAPI V2 屬於開源 API 工具,用 Rust 寫後端,將多個免費層模型整合成 OpenAI-compatible API,旁邊再配一個 React/Vite 管理介面,處理查詢、切換同基本營運資訊。

它不只是做 API 轉發。crates/getmodelsapi 會負責 model discovery、scraping、filtering、enrichment、caching 同 serialization,代表項目本身會整理不同來源可用模型;crates/server 就接手 provider adapters、routing、SQLite persistence、health checks、analytics 同 graceful shutdown。呢個分工幾實際,因為你唔需要自己再砌一層模型清單同步服務。

項目比較像自架本地服務:後端預設監聽 127.0.0.1:3001,管理介面可另外用開發模式啟動,也可先 build client 再由伺服器提供內容。另有 desktop tray launcher,會喺本機啟動 server,再用瀏覽器開 dashboard;它唔內嵌 webview,亦唔依賴 Tauri。金鑰保護亦有交代,供應商憑證會用 AES-256-GCM,加密金鑰需用 64 個十六進位字元提供。

取捨同樣明顯。它集中火力解決「多供應商免費模型統一接入」呢件事,對於想快速驗證工作流、建內部工具、或者做模型切換測試的團隊會幾有幫助;但模型可用性本身受外部平台影響,所以 network-dependent provider smoke tests 不會放入一般測試,要另外開 GETMODELS_NETWORK_TESTS=1 驗證。換句話說,API 介面可以統一,免費模型是否穩定供應,仍然要跟住各家服務狀態走。

  • 用 Rust 包辦後端與 model discovery,重點放在穩定服務、路由同資料持久化
  • 提供 OpenAI-compatible API,較容易接入原本已支援 OpenAI 介面的應用
  • 內建 React/Vite 管理介面,唔使自行補一套後台
  • 支援 SQLite,較適合本地測試、小型團隊或輕量內部項目
  • 免費模型來源多,但供應商連線與可用性仍需獨立驗證

GitHub

Categories: 開源, API, 工具

ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

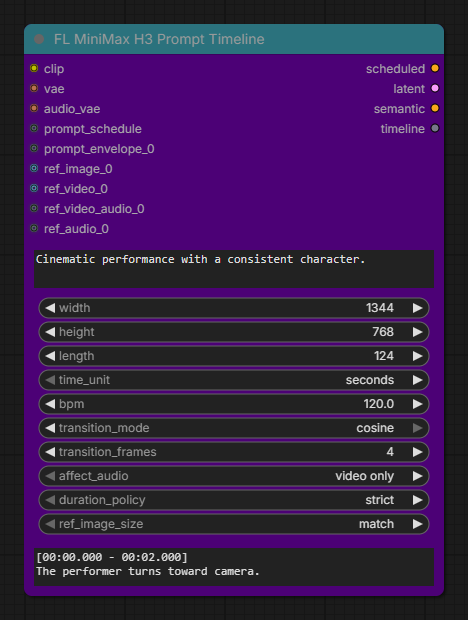
想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。

FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

Page 9 of 153
1 7 8 9 10 11 153