RealMe:從稀疏多鏡頭畫面重建 2K 沉浸式 4D 影片

拍攝角度和畫面清晰度有限,也能為新視角補出細節並維持跨鏡頭、跨時間的一致性。RealMe 以影片擴散模型輔助重建體積影片,但程式碼仍未公開。

RealMe

用稀疏、低解像度的多視角影片製作沉浸式內容,難處不只在補清楚每一格,也要避免不同鏡頭和時間點的畫面互相矛盾。RealMe 是一項體積影片重建研究項目,目標是把 720p 多鏡頭拍攝素材轉成 2K、具 4D 一致性的影片,適合需要從有限拍攝資料重建人物與場景的研究及製作團隊。

流程先由輸入畫面建立粗略的 4D 表示,再從新視角渲染結果和原始畫面裁切出輔助影片,交由高解像度影片擴散模型增強;生成結果會與原始拍攝一同用來細化最終表示。模型以 ControlNet 注入輔助影片條件,並在 DiT 中分開處理時間與視角方向的注意力,讓去噪過程能交換跨影格、跨視角資訊;頻率引導則用來恢復細節。

相比只提升單張影像清晰度的做法,RealMe 同時處理新視角品質與 4D 一致性。研究團隊表示,它在 RealVV 和 DNA-Rendering 兩個資料集的新視角合成品質及 4D 一致性上勝過當時的先進方法;與 STAR、FlashVSR 比較時,示範結果呈現更細緻的面部、頭髮和衣物細節。這些結果來自研究展示,未提供可供讀者自行重現的效能數字。

RealVV 是團隊自行拍攝的多視角資料集,涵蓋不同人物、動作、場景、相機基線和焦距設定,目標是測試較具挑戰性的拍攝條件。現階段 GitHub 程式碼仍在內部審查,資料亦標示為即將提供,因此目前可透過論文、項目網站及示範影片了解方法,尚未能按公開指引安裝或重現流程。

  • 輸入為稀疏、低解像度的多視角影片,輸出目標為 2K 4D 體積影片。
  • 影片擴散模型負責生成增強視角,再與原始拍攝共同細化重建結果。
  • DiT 的時間與視角注意力設計,用來維持跨影格、跨視角一致性。
  • RealVV 涵蓋多種人物、場景及相機設定;程式碼和資料目前尚未公開。

對多鏡頭人物捕捉、自由視角影片和 4D 重建研究而言,RealMe 展示了以生成模型補足稀疏拍攝細節的方向;但在程式碼與資料釋出前,製作團隊仍難以判斷其運算成本、所需拍攝條件及融入現有流程的難度。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, Video, Image, 中國, Dataset 數據集

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

StreamingSwap 把影片換臉推向 20 FPS 即時串流

StreamingSwap 針對長片換臉的身份穩定與速度取捨,透過較短上下文支援單卡即時處理。

StreamingSwap

長時間影片換臉最難維持的不是單幀效果,而是身份一致、原有動作和畫面細節能否一路穩定。StreamingSwap 是一個參考圖像引導的影片換臉模型框架,處理把來源身份轉移到目標影片、同時保留目標人物屬性與動態的問題。

它分兩個階段改善速度與穩定性。Face-RoI Generation 只集中處理臉部區域,配合按噪聲程度調整身份與重建比重的 Joint Rec-ID Loss;其後以 Short-Context Rollout Training 使用模型生成的歷史畫面,減少串流生成中的誤差累積。這套方法針對換臉只改變身份、其他視覺內容大致不變的特性,補足單靠 flow-matching supervision 對身份差異不夠敏感的問題。

提供的結果包括:
– 單張 NVIDIA RTX 4090 達到 21.174 FPS 的端到端吞吐量
– 評估影片最長達 10 分鐘,並展示 19 分鐘、20 FPS 取樣的直播串流測試
– HumanFaceVid 包含 1,000 小時電影風格訓練資料,以及各 200 段短片和長片評估集
– 研究結果在身份轉移和視覺質素之間取得具競爭力的平衡,但資料建構程式和訓練資料仍標示為準備中

電影後期、直播特效和長片角色替換等情境,較能受惠於這種空間與時間上下文都較節省的做法;單卡 RTX 4090 的測試結果亦令即時串流更接近可行範圍。項目提供的是研究模型與展示資料,原始資訊未交代完整安裝指令、未有直接下載的模型權重或訓練資料,因此不宜當成已可隨意下載使用的成品。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 框架, Dataset 數據集

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

FocusGUI 自動揀對的訊息做 GUI 代理

南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

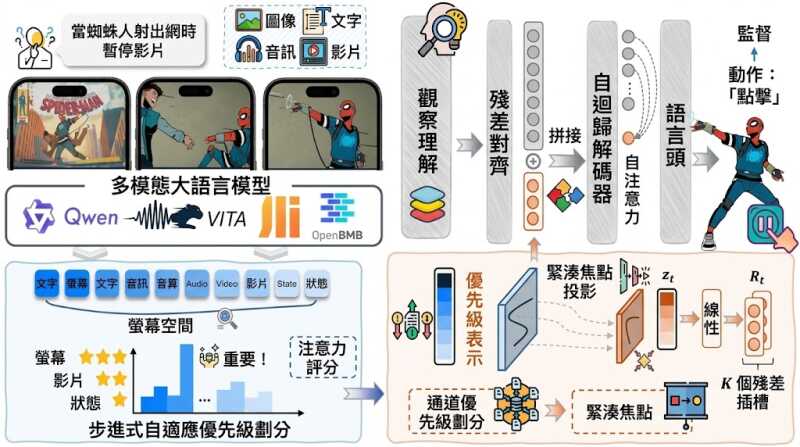
FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

yomado:給 Agent一個虛擬螢幕

yomado 讓 Agent 在虛擬螢幕操作 Blender、Marvelous Designer 等桌面程式,毋須為每款應用另接 MCP。實體屏幕可以保留給自己的工作。

yomado night-window icon

需要代理透過截圖、滑鼠和鍵盤操作 Blender 或 Marvelous Designer 時,桌面程式仍要有圖形桌面和顯示畫面。yomado 是一款 Mac 虛擬顯示器工具,讓代理使用獨立工作屏幕,毋須為每款應用另接 MCP;代理負責觀察和操作,yomado 則提供顯示空間。

它會按桌面排列顯示實體與虛擬屏幕,並在屏幕示意圖中標出應用程式。你可以拖曳圖示移動視窗,也可以手動移動;功能表按顯示器分組,並支援個別關閉視窗。隨附的 yomado skill 可引導 Codex 建立工作屏幕、移入指定視窗、確認畫面可見,並在任務完成後移回視窗。

  • 可為不同代理建立各自的虛擬屏幕,將工作視窗分開管理。
  • 可從 Finder 將正在執行的 .app 拖入,移動該應用的一般視窗。
  • 虛擬屏幕存在期間,程式會要求系統和圖形桌面保持喚醒。
  • 目前版本為實驗版,使用 macOS 14 或以上的 Apple Silicon Mac,並使用 macOS 私有 API。

這做法補足顯示空間,而非代理本身的視覺理解或操作能力;截圖、判斷和輸入仍由 Codex 或其他代理工具處理。對需要代理操作可視化介面、又想讓自己的實體屏幕保持原有工作的 Mac 使用者,分屏管理有實用價值。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, Google, API, Video, 工具, Mac, 蘋果, Skill 技能

WorldCast 預測並生成世界狀態

WorldCast 把視覺生成拉到多步推演:模型要交代世界如何逐步變化,而不只是交出一張合理終局圖。

(a) The four-level capability tree of visual generation. (b) The WorldCast benchmark and overall results.

當任務要求模型根據觀察、物件參照和操作示範,預測一個過程接下來會怎樣發展,單張圖片的合理性已經不夠。WorldCast 屬於視覺生成基準測試,實際處理的是多模態模型如何理解不同參照在何時生效,並生成一連串有因果關係的世界狀態。

它把能力分成 L1 至 L4:由靜態 text-to-image,推進至編輯、主體參照和 text-to-video,再進入複雜限制、物理合理性及把現實情境轉化為行動。WorldCast 聚焦較少被量度的 L3、L4,涵蓋 320 個人工設計案例、1,352 個視覺狀態及 8 類任務,並同時測試 unified systems、multi-reference image models 和 video models。

• 評分把 grid、interleaved 和 video 輸出視為有次序的狀態序列
• 參照內容可以是觀察狀態、目標、規則、物料特性或示範程序
• 12 個代表性模型接受同一套評估協議及 Judge rubrics
• GPT-Image-2.5 System 取得 72.8 分,反映前沿模型已出現早期世界狀態預測能力

可從 Hugging Face Dataset 取得資料測試,配合項目提供的 evaluation toolkit 和 Evaluation Guide 重現評分;模型亦可輸出逐格圖像、交錯圖像或影片。結果差距會在較高層次任務擴大,interleaved generation 對圖像模型有幫助,但評測仍集中於人工設計案例,未等同於真實環境中的長期規劃能力。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 視頻模型, Video, Image, txt2img, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

Page 4 of 32
1 2 3 4 5 6 … 32