WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。
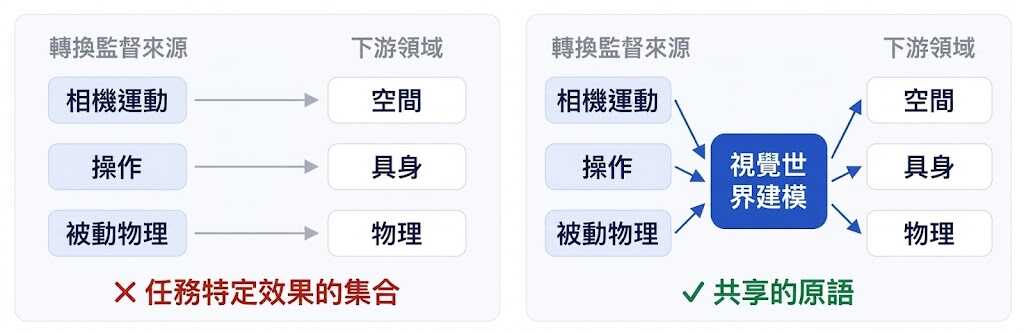
WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

VIS-Ground 讓互動影片真正記住前文與要求

觀眾暫停影片後提出要求,VIS-Ground 會把來源、已播內容與指令整理成可驗證的生成約束。

VIS-Ground teaser

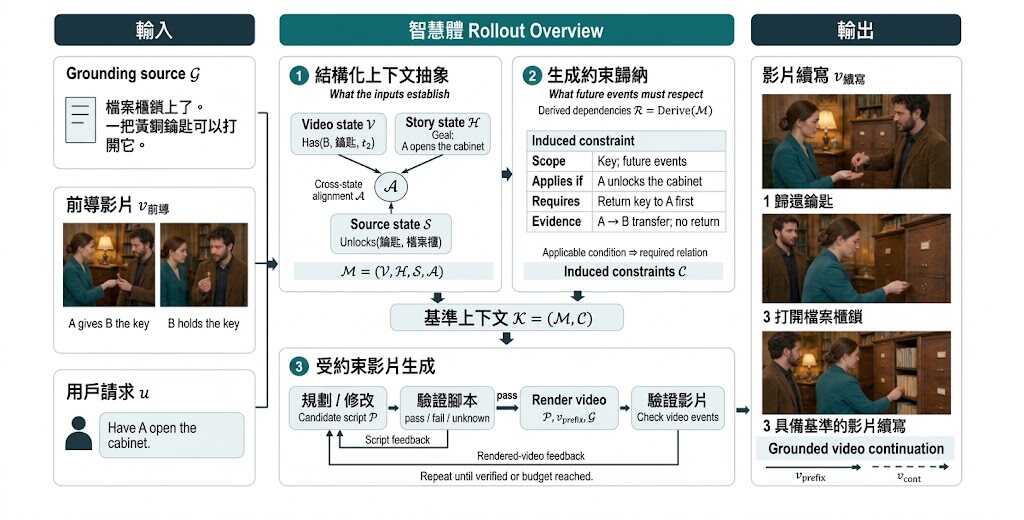
觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。

它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。

  • 以可執行 constraint model 連接文字來源、影片內容與互動指令
  • VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
  • 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
  • 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score

Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。

適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。

項目主頁 · GitHub

Categories: 開源, AI productions, 多模態模型, Video, 提示詞, 框架, Dataset 數據集, MiniMax

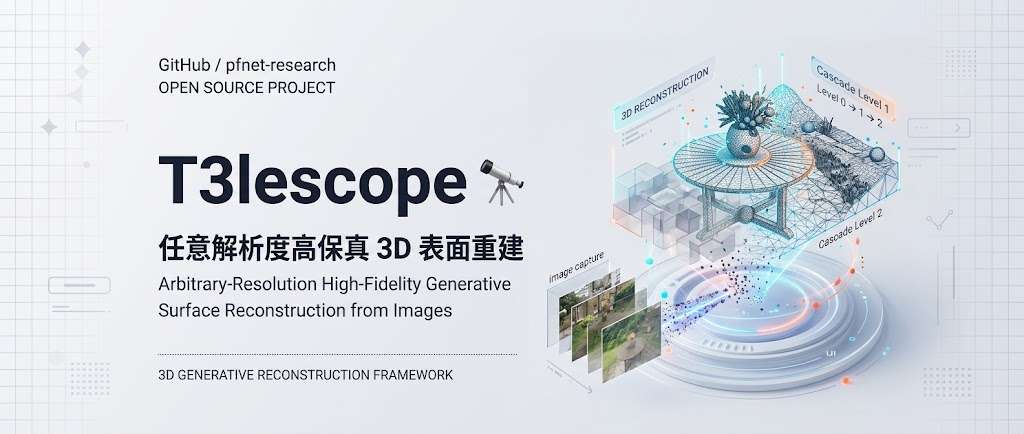
T3lescope 把多視角影像變成高質 3D 場景

由單一物件到城市級戶外場景,T3lescope 嘗試以生成模型兼顧整體幾何、細節,以及玻璃和鏡面表面重建。

T3lescope teaser

面對影像稀疏、表面反光或透明等情況,T3lescope 仍嘗試由已標定相機姿態的多視角影像重建高保真 3D scene mesh。它屬於生成式 3D 重建模型,處理的是大型場景難以同時維持覆蓋範圍與局部細節的問題。

模型以 mesh flow models 直接生成高解析度網格,並在推理階段採用 coarse-to-fine cascade:先用較粗層級建立全局布局,再於更細的 spatial cells 內擾動、去噪和補回幾何細節。各層共用同一個 fixed-resolution generator,訓練時以不同尺度的 cells 學習,因此層級數量、cell 尺度和位置都可於推理時調整。

這做法減少把大型場景切成多個獨立重建區域後出現的接縫和全局不一致風險,也不需要逐個場景進行 per-scene optimization。代價是重建品質仍取決於輸入影像數量、視角覆蓋和模型推理配置,而 README 未提供硬件要求、速度或完整操作流程。

T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
  • 支援由單一物件、室內環境延伸至戶外和城市級場景
  • 可在推理階段選擇 cascade 層級與網格細緻程度
  • 針對稀疏觀測、細小結構、glossy 及 transparent surfaces 提供生成式補全
  • 在室內、戶外及城市場景測試中勝過 feed-forward 和生成式基線,並達到或超越部分 per-scene optimization 方法

適合需要多視角影像轉 3D 資產的視覺研究、數碼孖生、機械人感知和場景製作團隊,較容易受惠於這種跨尺度重建能力。不過 GitHub 項目目前只標示 Code is coming soon,尚未提供可安裝程式碼;現階段可參考 arXiv、項目網站和示範影片理解結果,未能按儲存庫直接測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 3D, 庫

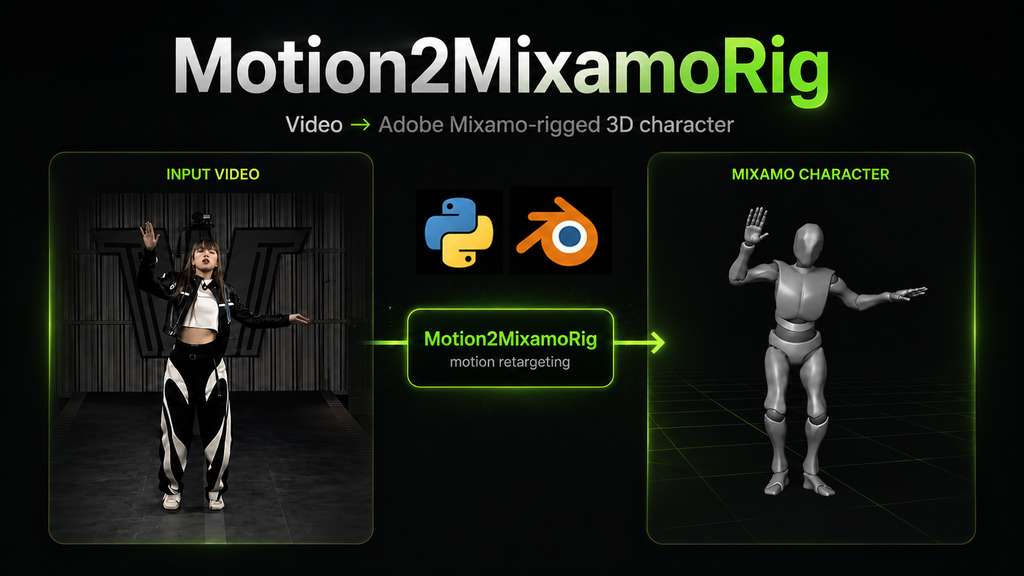
Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

Work2Skill 把人手 GUI 操作變成可重用 Agent 技能

Work2Skill 將人手操作錄成多模態證據,再整理成 Computer-use agents 可重用的工作技能。

Work2Skill overview: human GUI demonstrations, multimodal recording, action-linked evidence, agentic skill induction, an

面對陌生桌面軟件,單靠任務描述往往不足以交代按鈕位置、操作次序及完成後應有的狀態。Work2Skill 屬於 GUI 操作記錄、數據集與 Agentic skill induction 項目,處理的是如何把人手示範轉成可供 Computer-use agents 重用的程序指引,而不是另一個獨立基礎模型。

WorkRecorder 將螢幕影片、關鍵影格、滑鼠鍵盤事件及可用的無障礙資訊放在同一條時間線,讓每個動作同時保留畫面背景和介面狀態。WorkDemo-350 收錄 350 個桌面示範、約 8.48 小時錄製內容,包括 64 個 MyPCBench 任務及選出的 286 個 OSWorld 任務;AgenticSkillInduction 則提供基於 NexAU 的技能歸納範例,將流程整理成可執行時參考的技能。

它和只保存點擊座標或純文字步驟的做法不同,保留了操作前後的多模態證據,較適合處理介面改變、控制項含義不明或需要驗證結果的工作。不過,項目目前仍有清晰限制:macOS 錄製器及 Linux X11 AT-SPI 服務已提供,跨平台現場驗收仍待完成;下游評估整合亦尚未完成。

網站列出的結果以 0 至 100 分的 MyPCBench 平均分計算,四個執行模型在加入技能後最高提升 10.54 分。對需要累積桌面工作流程、研究 Computer-use agents,或希望以共同示範數據比較技能歸納方法的團隊,這套資源較有參考價值;資料集與錄製資料放在 Hugging Face,完整錄製及技能流程則要按各子目錄指南處理,原始資料未提供單一即用安裝流程。

  • 核心價值: 把人手 GUI 經驗連同畫面、輸入及介面證據保存。
  • 資料規模: 350 個示範,涵蓋 MyPCBench 與 OSWorld 任務。
  • 技術組成: WorkRecorder、WorkDemo-350 及 NexAU 技能歸納範例。
  • 主要取捨: 證據更完整,但跨平台驗收和評估整合仍未完成。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 軟件, Mac, Linux, 中國, Dataset 數據集, Skill 技能

Video-RSI:不改模型權重,讓影片代理自行進化

Video-RSI 透過改寫提示詞、工具、記憶與執行邏輯,提升影片理解代理的準確度及取樣效率。

Video-RSI framework: Solver execution, active video investigation, and cost-aware harness evolution.

影片理解代理遇到答錯問題時,未必需要重新訓練模型。Video-RSI 是一個開源框架,讓代理重新檢視影片,補充視覺、字幕及 OCR 證據,再把失敗原因轉化為可重用的程式修改;模型權重則保持不變。

項目由 Solver 和 Editor 配合:Solver 執行影片問答,Editor 調查失敗案例,並演化 prompts、tools、memory 及 execution logic。相比只調整模型參數,這種做法把改善集中在可執行 harness,較適合需要快速反覆修正工作流程的研究團隊。

  • 透過額外視覺、transcript 及 OCR 證據分析錯誤
  • 以 accuracy 和 visual-frame cost 共同篩選修訂版本
  • 提供 Initial harness、final harness、inference 及 evolution framework
  • 預設支援 DeepSeek-V4-Pro 和 Qwen3.6-Plus 等 OpenAI-compatible service 模型

評測會在私有 Gate set 以答案準確度及視覺影格處理成本配對選擇版本。項目資料所述結果指向更佳的 accuracy–efficiency trade-off:演化後 harness 在維持競爭力準確度的同時,處理較少影格,但未有公開具體分數或基準逐項差距。

要測試項目,需要 Linux、Python 3.12、兼容 API 服務,以及本地 RapidOCR 3.9.2 PP-OCRv6 small detection and recognition models;影片輸入採 JSONL,包含問題、選項、片長及絕對路徑,也可載入 faster-whisper large-v3 產生的 transcript。需要留意,允許 provider calls 會使用付費模型 API,因此成本控制和本地 OCR 準備是部署前的重要取捨。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Qwen, DeepSeek, API, Video, 提示詞, 框架, 工具, Linux, Python

SepGen 讓影片生成同時輸出獨立聲軌

SepGen 把影片生成與聲音分離放進同一模型,讓每種聲音獨立輸出,方便重混及空間音效製作。

SepGen overview

影片生成不再只產生一條混合音軌:SepGen 是一個多模態生成模型,處理影片畫面、完整配樂,以及按描述分開的聲音 stem。你可以描述場景和各種聲音生成新片,也可以交給它現有影片,抽取指定聲音。

SepGen 建基於 LTX-2.5,在同一次運算加入兩條由文字控制的音訊軌;原有完整 soundtrack 保持不變,每條 stem 只根據自己的描述生成。相同模型同時支援 generation 和 separation,分離後的聲音亦可配合場景位置,延伸至 4D video 和 spatial audio 工作流程。

  • 生成影片、完整 soundtrack 及獨立聲軌
  • 以文字指定要抽取的聲音
  • 同一組 weights 支援兩種任務
  • 可配合移動視角重新呈現聲音位置

項目適合影片後期、遊戲場景、互動媒體及需要重新混音的研究團隊。README 提供 Linux、ffmpeg 及單張 48 GB NVIDIA GPU 的執行條件;模型 weights 約 72 GB,每段影片在 RTX A6000 上需數分鐘,長片則要啟用 VAE tiling,且 num-frames 必須符合 8k+1。

SepGen 的取捨在於硬件及模型容量要求不低,README 亦未提供低記憶體替代方案。gen-3k checkpoint 可用於 generation,分離能力約相近;項目同時提供模型與 SepGen-Dataset,但目前資料未交代更廣泛硬件的性能比較,較適合作為研究原型或具備 NVIDIA 工作站的製作項目。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, NVIDIA, Video, Audio, Linux, LTX, Dataset 數據集

VisionWeave 讓多模態模型按畫面分配細節

VisionWeave 按內容保留重要視覺細節,減少冗餘視覺 tokens,兼顧長影片理解效率與任務質素。

VisionWeave logo

長影片、圖表和文字密集畫面不需要每個位置都用同樣精細度處理。VisionWeave 屬於多模態模型(MLLMs)效率優化項目,讓模型按視覺內容決定保留細節或壓縮表示,處理視覺 tokens 過多所造成的成本與延遲問題。

VisionWeave 不是固定比例刪減 tokens,而是把 fine-grained 與 coarse-grained representations 編織起來,讓重要區域保留較多資訊、背景使用較緊湊的表示。項目針對 dense Qwen3.5 提供影像及影片 inference,評測則涵蓋 Qwen3.8-27B 與 Qwen3.5-4B,並比較 FastV、VisionZip 等固定預算方法。

Qwen3.8-27B 在八項 benchmark 平均節省 43.0% visual tokens,同時保留 98.9% 原生模型表現。於 SGLang、兩張 A100-80GB 和 BF16、TP=2 條件下,LongVideoBench throughput 由每分鐘 0.90 個請求升至 2.07 個,平均 TTFT 亦由 169.90 秒降至 77.54 秒。

  • 按畫面內容自動調節視覺表示粒度
  • 適合長影片、自然場景、圖表及文字密集影像
  • 在多項任務與不同輸入解析度下衡量效率與質素取捨
  • README 提供的 checkpoint 需另行取得,完整安裝流程在目前資料中未交代

研究團隊同時提供 image/video inference,但儲存庫資訊未列出下載連結、硬件最低要求或完整測試步驟,因此較適合作為研究評估和 SGLang serving 實驗起點。對需要處理長影片、多張影像或高解析度輸入的模型團隊,VisionWeave 提供了比固定 token 預算更靈活的壓縮方向;代價是要配合指定 Qwen 模型與額外 checkpoint,未必能直接套用到其他架構。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Video, Image, 庫, Dataset 數據集

StereoBind 讓生成聲音跟隨畫面移動

StereoBind 不只同步影片與聲音,還嘗試讓聲音方向跟隨畫面中的發聲物體移動,為沉浸式生成補上空間感。

StereoBind logo

當畫面中的車輛、人物或物件移動,聲音不應只在時間上同步,還要讓聽者感覺聲源位置一同改變。StereoBind 屬於聯合影片與音訊生成模型的研究項目,處理的正是立體聲與可見聲源之間的動態空間對應問題,面向 AR/VR、互動遊戲及沉浸式內容製作較有價值。

StereoBind 在預訓練的 joint audio-video generator 上加入視覺來源的 motion tracks,將畫面中的移動軌跡傳給音訊生成流程。Simple Summary Tokens 壓縮來源內容與動態資訊;Spatial Track Encoder(STE)編碼每個時間點的標準化 2D 位置;ResidualTrackRoPE 則把相對軌跡變化加入 temporal attention,令模型同時理解聲源所在位置及移動方向。

  • 以軌跡連接視覺來源與 stereo audio
  • StereoWorld-29K 提供附帶 motion tracks 的立體聲影音資料
  • StereoWorldBench 用來量度聲音是否跟隨可見聲源
  • 目標是改善空間對齊,同時保留整體影音品質

StereoWorld-29K 不只是訓練資料,亦包含由真實影片及軌跡控制合成場景整理而成的幾何監督;StereoWorldBench 則針對聲音與畫面來源在時間上的空間一致性作評估。項目資料稱實驗能大幅改善立體聲生成的空間對齊,但目前提供的資訊未列出具體分數、基準模型或延遲數據,因此未能判斷它在不同場景的實際優勢幅度。

GitHub 儲存庫目前仍屬公開發布前狀態,inference code、training code、設定檔、checkpoints、StereoWorld-29K 及評估套件尚未提供,亦沒有可照做的安裝流程。研究團隊、影音生成模型開發者,以及需要聲音方向隨畫面移動的 AR/VR 和遊戲製作流程,可以先把它理解成一套待公開的 trajectory-conditioned 聯合生成框架;現階段較適合閱讀研究概念及等待後續資源,而不是立即部署。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Video, World-Action Model, Audio, 框架, 庫, Dataset 數據集

Google Foresight:會議筆記與個人資料留在 Mac

Foresight 在 Mac 本地聆聽會議、整理筆記,亦能按你的檔案即時回答問題。

開會時只需記下零碎提示,Google AI Edge Foresight 便可配合本機轉錄內容整理成較完整的會議筆記。工具支援 Google Meet、Zoom,以及面對面或離線對話,音訊和文字都在 Mac 處理,不必上傳雲端。

Foresight 亦能連接本地項目資料夾、Google Drive、參考文件、圖表、網頁連結和日曆,建立與工作相關的背景資料。對話期間,它可透過聊天檢索內容;Live Assistance 更會聆聽問題,在相關資料出現時主動顯示附有引用來源的 context cards,減少會議前準備和反覆確認資料的時間。

技術核心包括 740M 參數的 EmbeddingGemma 2。這個 on-device multimodal embedding model 會把文字、圖片、影片和音訊映射到同一向量空間,支援跨模態語意檢索;配合 Gemma 4,可在裝置上建立即時的 Retrieval-Augmented Generation(RAG)流程,避免網絡延遲。

  • 會議轉錄、音訊與檔案留在 Mac
  • 支援影片會議、面對面及離線對話
  • 可把速記提示整理成完整筆記
  • 支援跨文字、圖片、影片和音訊檢索
  • 具備聊天及 Live Assistance 兩種取用資料方式

頁面提供 macOS 下載入口。需要高度重視資料私隱、又經常在多個本地檔案之間切換的人,較容易感受到這種本機 AI 工作流的便利。

項目主頁

Categories: AI productions, RAG, Embedding, 多模態模型, Google, Gemini, Video, Image, Audio, 工具, Mac

Page 6 of 32
1 … 4 5 6 7 8 … 32