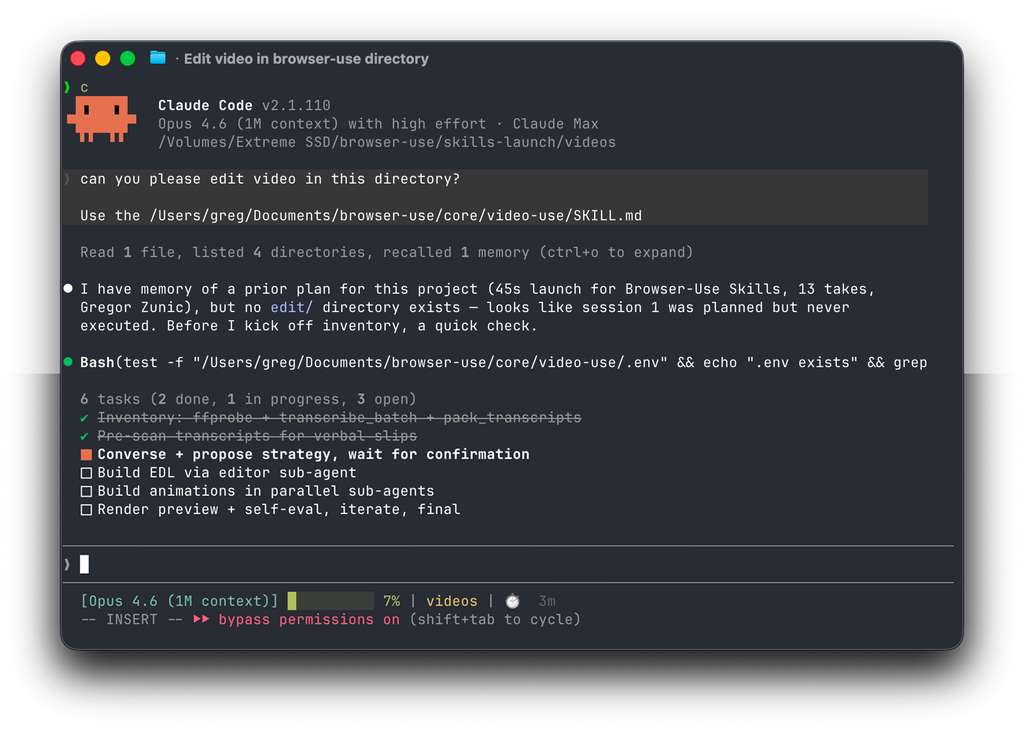
video-use:一句指令把素材剪成 final.mp4

video-use 將 Claude Code、FFmpeg 與 AI 動畫工具串成影片剪輯流程,適合需要快速製作短片的創作者與內容團隊。

video-use

剪片最花時間的往往不是逐格拖拉,而是刪去口誤、停頓、重拍,再處理字幕、調色和動畫。開源項目 video-use 將這些工作整合到 Claude Code 對話中:把原始素材放入資料夾,提出剪輯要求,確認方案後便可取得 final.mp4。

它屬於 Agent 影片剪輯工具,依賴 FFmpeg、ElevenLabs API,以及支援 shell access 的 Agent;Claude Code、Codex、Hermes、Openclaw 等均可按技能方式整合。Agent 會先盤點素材並提出策略,待你確認後才進行剪輯,亦可用 project.md 保存跨次工作的記憶。

  • 自動移除「umm」、「uh」、重試開頭及拍攝間的空白
  • 支援預設或自訂 FFmpeg 調色,並在剪接點加入 30ms 音訊淡出
  • 預設以每兩字一個大寫單元燒錄字幕,樣式可自行調整
  • 可並行呼叫 HyperFrames、Remotion、Manim 或 PIL 製作動畫疊層

這種做法省去大量重複剪輯操作,也毋須在預設項目與選單之間來回切換。代價是成果會受素材品質、Agent 判斷、FFmpeg 設定及 ElevenLabs 服務影響;影片內容、關鍵 API 費用與電腦運算資源仍要由團隊控制。它適合對話式影片、教程、旅遊片段、訪談及社交媒體短片,但複雜敘事和高度精準的專業後期仍需要人工覆核。

影片輸出前,工具會逐個檢查剪接點,協助發現突兀轉場或音訊爆音;然而自我評估並不等同真人審片。採用這個項目時,重點不在追求完全自動,而在讓 Agent 先處理機械而重複的工序,把最後一輪節奏、內容與品牌審校留給創作者。
GitHub

Categories: 開源, Agentic, AI productions, API, Video, Audio, 工具, Content Creator, OpenClaw, Anthropic, 動畫, Skill 技能

video-shotcraft:用一張產品圖製作可編輯的宣傳片

video-shotcraft 將 Claude Code 或 Codex 接到影片製作流程,以 Remotion 排版真實產品截圖,交付可編輯 MP4。

video-shotcraft logo

只要向 Claude Code 或 Codex 提出「替產品製作宣傳片」,video-shotcraft 便會擷取產品真實頁面,選取鏡頭、編排故事線,再以 Remotion 動畫化。最終輸出 MP4、瀏覽器編輯器 Motion Workbench,以及剪映可編輯草稿,方便後續修改。它不是端到端影片生成模型,而是一套整合截圖、動態配方、節拍與音效的 agent skill。

  • 以真實截圖及文案作畫面素材,保留品牌外觀與文字清晰度
  • 提供 124 張 recipe cards,涵蓋 150 種鏡頭及預覽
  • 流程涵蓋 storyboard、Remotion 動畫、節拍同步、聲效及逐格檢查
  • 可交付 MP4、Motion Workbench 與剪映草稿

這種做法與文生影片模型的分別,在於每一幀都由程式碼繪製,而不是生成抽象影像;代價是成品取決於頁面素材、shot recipe 的覆蓋範圍及 Remotion 排版,創意空間主要來自鏡頭選擇和動態組合。36.2 秒的 ready template 可供快速改稿,但較長或講解密集的產品影片仍需要重新編排內容。

產品團隊、獨立開發者及需要反覆製作版本宣傳片的 marketing 部門,都可從「保留可編輯性」中受益。工程師可用現有網站截圖建立視覺稿,內容團隊亦可沿用剪映草稿調整節奏,省去由錄屏再逐段重做動畫的時間。

一行 “幫我安裝這個 skill:https://github.com/Vincentwei1021/video-shotcraft” 便完整安裝。適合希望將影片製作納入 coding agent 工作流、而非直接生成寫實片段的團隊。

項目主頁 · GitHub · 作品展示

Categories: 開源, Agentic, AI productions, Video, Image, Vibe Coding, 編程, Anthropic, 動畫, 聲效, Skill 技能

AI Toolkit 把擴散模型訓練搬上消費級硬件

將多種新式圖像與影片模型放入同一套訓練工具,兼顧 GUI、CLI 與本地環境管理。

AI Toolkit UI

想在家用硬件微調 FLUX、Qwen-Image 等模型,過往往往要自行處理環境、依賴與介面;Ostris AI Toolkit 把這些繁複步驟整合成一套擴散模型訓練工具。官方資料未提供完整安裝指令,但建議透過儲存庫內建的 AI Toolkit Manager 啟動。

AI Toolkit Manager 會偵測硬件並配置合適的 PyTorch 版本、建立 Python 環境,以及下載 Node.js 和 FFmpeg,所有檔案留在 ai-toolkit 資料夾內,不會系統級安裝。啟動時亦會檢查更新;若本機檔案經修改,更新會跳過並發出警告,減少覆蓋自訂設定的風險。

它屬於開源訓練套件,可透過 GUI 或 CLI 操作,涵蓋圖像及影片模型訓練。模型支援範圍頗廣,包括 FLUX.1、FLUX.2、FLUX.2-klein 4B/9B、Lumina-Image-2.0、Qwen-Image-2512、SDXL,以及 Chroma、HiDream、OmniGen2、Z-Image、ERNIE-Image 等新式架構。

  • 以消費級硬件為主要目標,縮低本機訓練門檻
  • 同一套工具支援多種新舊擴散模型
  • GUI 與 CLI 並存,兼顧互動操作及批次流程
  • 依賴與模型資源集中管理,減少系統污染
  • 保留本機修改,並在更新衝突時給出警告

相較只針對單一模型或只提供訓練腳本的做法,AI Toolkit 的優勢是將模型選擇、環境配置與操作介面放進同一工作流。不過,原始資料沒有交代各模型的訓練速度、記憶體需求或量化設定,硬件是否足夠仍要視模型大小與訓練配置而定。

這套工具較適合需要建立角色、產品或風格資料的設計團隊、內容創作者,以及想在本地微調開源模型的開發者。模型及環境檔案仍佔用大量磁碟空間,影片模型亦可能帶來更高記憶體與運算負擔,部署前宜先核對個別模型的條件。

GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Stable Diffusion, Video, Image, 工具, Content Creator, Python, 庫, 百度

FilmFlow: 虛擬電影攝影機代理

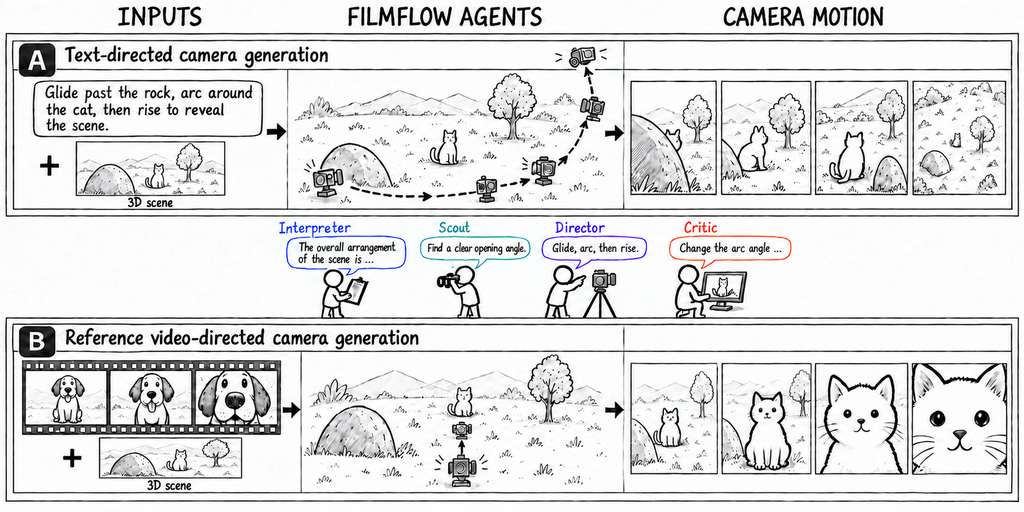
FilmFlow 讓創作者用文字指示或參考影片,為 3D 場景生成鏡頭移動。它會結合場景理解與渲染後的視覺回饋,逐步修整鏡頭位置、方向和構圖。

FilmFlow accepts text or a reference video and a 3D scene. Interpreter, Scout, Director, and Critic agents refine camera motion through visual feedback.

想為 3D 場景安排推鏡、環繞或特定構圖,FilmFlow 可將文字指示轉成可執行的鏡頭軌跡,也能把參考影片中的運鏡轉移到另一個場景。這套電影攝影代理系統面向動態 3D 環境,處理的是如何把拍攝意圖落實成有時間安排、能在場景中執行的鏡頭動作。

FilmFlow 由四個代理協作:Interpreter 理解場景並整理鏡頭意圖,Scout 尋找合適的起始視點,Director 安排鏡頭操作及其時間和參數,Critic 則檢視渲染結果並提供修正方向。Director 可同時組合多項基本操作,控制鏡頭平移、旋轉和取景;整個流程會根據畫面回饋反覆調整,而非只輸出一段抽象描述。

兩種輸入方式適合不同工作流程:文字導向生成讓創作者直接描述鏡頭動作與構圖要求;參考影片導向生成則適合借用既有片段的運鏡,並套用到另一個 3D 場景。這可用於虛擬場景分鏡、動畫預演及 3D 鏡頭設計,但生成效果仍取決於指示能否表達清楚,以及場景是否提供所需的視覺條件。

研究團隊同時推出 CinemaBench,涵蓋 150 個 Blender 場景、750 項文字導向任務和 60 段參考影片,用來評估文字導向與影片導向的鏡頭生成。提供的資料沒有列出基準測試成績,也未交代安裝或使用流程,因此目前可確認的是系統設計與評估集規模,不能據此判斷其性能表現。

  • 支援文字指示與參考影片兩種鏡頭生成方式。
  • 以四個代理分工處理場景理解、起始視點、鏡頭規劃和畫面檢視。
  • 可組合平移、旋轉與取景操作,並以渲染結果反覆修整。
  • 適合 3D 場景的鏡頭設計、分鏡及動畫預演。
  • CinemaBench 收錄 150 個 Blender 場景、750 項文字任務及 60 段參考影片。

項目主頁

Categories: 開源, Agentic, AI productions, Video, 框架, Content Creator, 3D, 動畫

AnyGameRenderer 把粗糙遊戲錄影變成可玩風格畫面

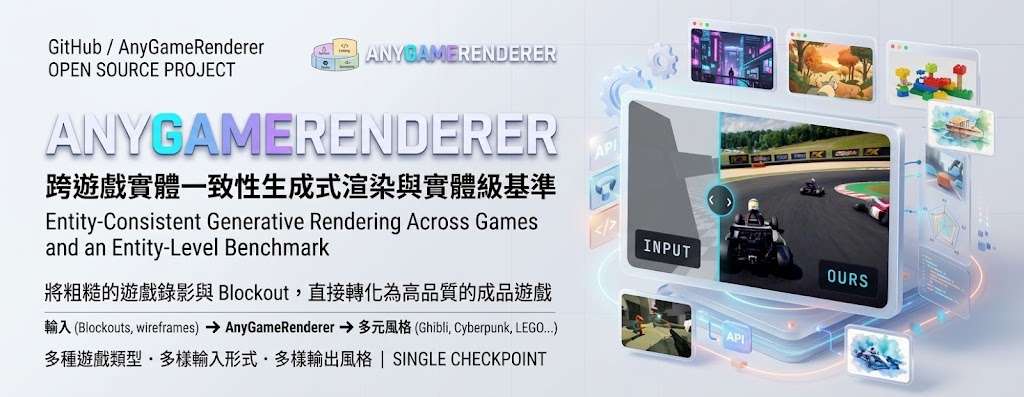
由灰色方塊與代理色組成的遊戲錄影,配合文字提示即可重繪成不同風格,同時保留角色、物件數量與動作時間。

genre trenchfire

遊戲原型仍是灰色方塊、彩色幾何體,AnyGameRenderer 就能把一段 24 fps、2 至 15 秒的普通影片,重繪成 AAA 寫實、LEGO、Ghibli、蠟筆或 synthwave 等風格。它屬於生成式影片模型,處理的是「畫面變漂亮後,角色位置、數量和出現時間仍要對得上」的問題。

輸入不需要逐物件標籤、引擎掛鈎或固定遊戲引擎格式,wireframe、semantic map、粗略 3D mockup、彩色 primitive 和 engine whitebox 都可作為來源。單一 checkpoint 已涵蓋 tower defense、kart racing、shooters、survivors-like 和回合制戰鬥等類型,適合 AI 遊戲生成工具、原型展示和美術風格探索。

  • 保留 entity correspondence,細小及遠距離物件較不容易消失
  • 文字提示可改變整體美術風格,同一段輸入可產生多種世界觀
  • 以 entity-level benchmark 評估,而非只看逐幀畫面相似度
  • LoRA 訓練尺寸為 1344×768、124 frames;更長影片可執行,但未按該長度訓練

59 個測試案例、753 個 ground-truth entities 中,temporal match 由 zero-shot base 的 50.9% 升至 62.9%,position match 由 57.1% 升至 61.9%;未渲染率由 4.1% 降至 2.9%,hallucination rate 由 52.1% 降至 46.0%。提升仍未代表每個物件都能穩定對齊,長片段和高密度場景仍需檢查輸出。

需要 Python 3.10、PyTorch 2.9.1+cu128 等環境資訊,以及 setup_env.sh 和權重下載流程;完整執行仍需要相應 GPU 環境。項目同時公開模型與資料集連結,較適合希望把可玩原型快速轉成視覺樣片的開發者和研究團隊。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Video, 工具, 3D, Python, 編程, Dataset 數據集, LoRA

Verus-Insight 分析可見瑕疵:影片真假判斷有跡可尋

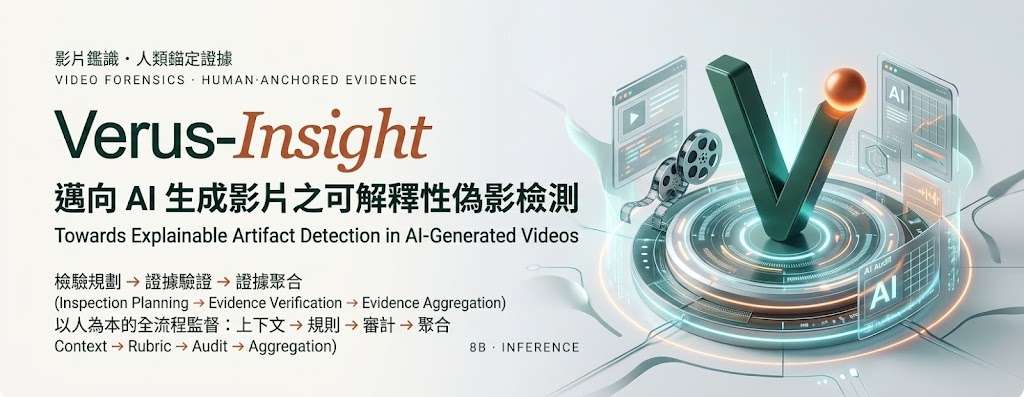
Verus-Insight 不只判斷影片是真還是假,亦會逐步規劃檢查項目、核實畫面證據,再整理成結構化結論。這套開源模型適合研究影片偽造分析及可解釋檢測的團隊評估。

Verus-Insight — Towards Explainable Artifact Detection in AI-Generated Videos

檢查 AI 生成影片時,單有真假標籤未必足以說明判斷依據。Verus-Insight 是一個影片瑕疵檢測模型,會按影片內容制定檢查準則、核實畫面中是否看得到相關瑕疵,再把觀察結果整合成真假判斷,讓分析不只停留在分類結果。

模型建基於 Qwen3-VL-8B-Instruct,採用「檢查規劃、證據核實、證據整合」流程。訓練方法以人工標註作錨點,涵蓋 Context → Rubric → Audit → Aggregation;這套流程旨在讓模型按影片內容提出檢查項目,並以可見證據支持結論。程式庫提供的是推理版本,並非可直接執行的訓練套件。

Verus-Bench 包含 192 段真實及 AI 生成影片,各佔 96 段,另有 320 項人工標註瑕疵,分屬 17 個類別。資料集可用來檢視模型能否找出細節瑕疵,但目前提供的資訊沒有列出具體評測分數,因此不宜據此判斷它比其他模型準確多少。

程式庫支援 Transformers、vLLM 推理,亦提供影片、圖片或影格序列輸入,以及批次推理與結果續跑功能。使用者可按文件準備 Linux、CUDA 環境並下載模型;Transformers 測試配置使用一張 H100 80GB GPU,但這只是已驗證配置,並非最低硬件要求。程式庫沒有提供訓練指令或訓練配方。

  • 適合研究影片偽造、視覺瑕疵分析及可解釋檢測的團隊。
  • 可由單一輸入測試,也可批次處理已整理的資料清單。
  • Verus-Bench 提供人工標註,方便檢視瑕疵定位與影片層級判斷。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Video, Image, Linux, 庫, Dataset 數據集

從影片理解世界:統一 Video World Models 的四種能力

一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

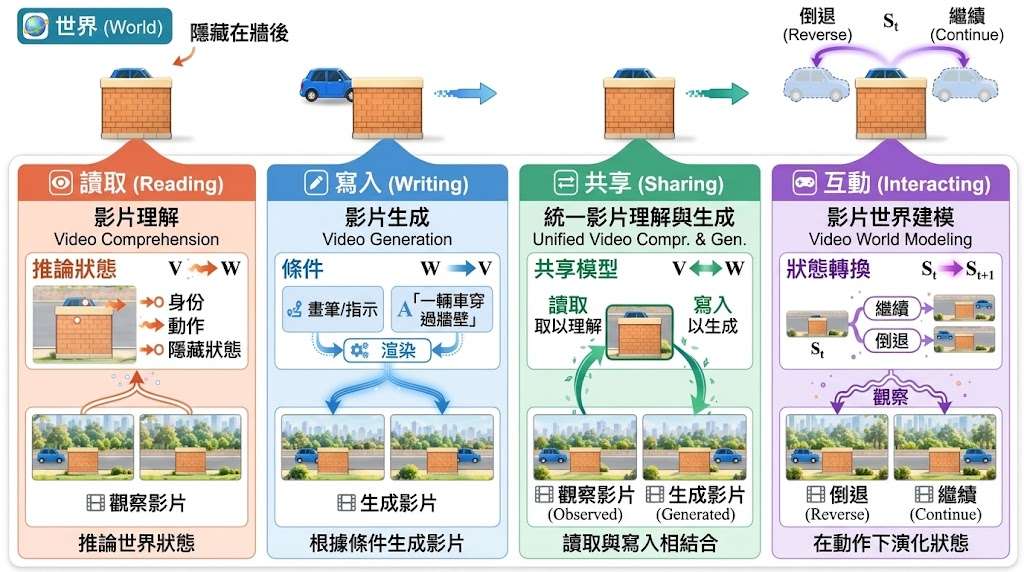
當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

LaLa-World 用自然語言連接機械人規劃

以文字描述動作,模型便可從模擬、機械人、圖片和影片學習並預測未來畫面,讓規劃不必為每個任務各自訓練世界模型。

NAVER AI Lab

只用文字描述動作,就能讓同一個世界模型從模擬、機械人、圖片和影片學習,並預測行動後的視覺變化。LaLa-World 是語言條件式潛在世界模型,目標是減少不同領域各自訓練模型的需要,支援跨場景規劃;它亦可微調成 LaLa-Policy,同時預測機械人動作和未來表徵。

關鍵做法是把自然語言當成共通的動作介面,再於潛在空間預測未來視覺表徵,而不是直接生成完整影片。研究結果指,加入圖片和影片資料可改善規劃能力,亦令模型較能適應不同動作措辭;這讓研究團隊可以把多種來源的資料納入同一套規劃流程。

  • 在平均 MPC 規劃 LaLa-World 優於按領域或任務分開訓練的潛在世界模型。
  • 與採用相同條件的 RAEv2 影片生成模型相比,規劃表現相若,訓練成本低 6 倍,規劃速度快 13.9 倍。
  • LaLa-Policy 在 LIBERO 和 RoboCasa 的結果可與 Cosmos Policy 比較,推理速度最高快 5.5 倍。
  • 跨模態資料可提升規劃表現及對動作措辭的穩健性,對需要跨模擬與真實機械人資料研究的團隊較有吸引力。

這些結果令項目適合用作機械人規劃與政策學習研究,尤其是希望整合影片資料、減少逐個任務訓練成本的團隊。不過,GitHub 儲存庫目前仍在補齊內容:環境設定和資料準備程式已提供,LaLa-World 訓練及規劃評估程式、預訓練檢查點和解碼器則尚未公開,因此現階段未能按完整流程重現結果。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 庫

ShotVerse2.0:讓影片生成更有電影感

從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

FAPL training framework

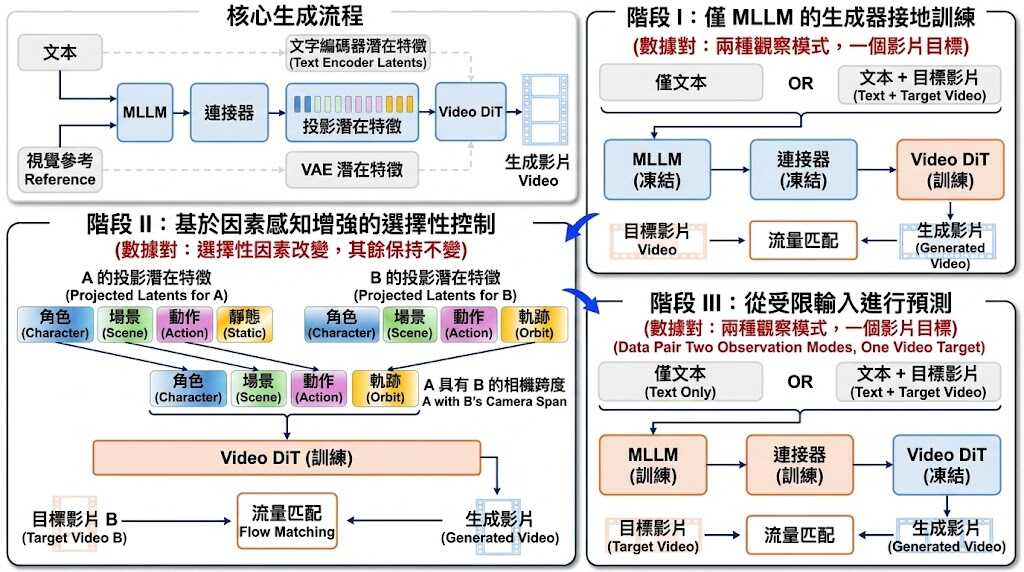
文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。

研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

Code2Video-Compass:程式碼生成影片點樣評?2,104 項任務比較 15 個多模態模型

Code2Video-Compass 把文字、圖片和影片輸入納入同一套程式碼影片生成基準,讓團隊比較模型能否產生可執行、貼合指示的影片。

Code2Video-Compass logo

由文字描述出發,或提供圖片、原有影片作參考,模型都要生成可執行程式碼,再經 Remotion 渲染成影片。Code2Video-Compass 是一套評估基準及評測程式,聚焦比較不同多模態模型在程式碼生成影片時的能力,而非提供一個直接生成影片的模型或服務。

它涵蓋文字轉影片(T2V)、圖片轉影片(I2V)和影片轉影片(V2V),支援 HTML/CSS、SVG、Canvas 與 Three.js 等程式碼方式。基準共有 2,104 項任務,分布於 10 個影片類別和 24 個子類別;其中 1,719 項任務配對 573 段來源影片,方便在不同輸入形式下比較模型如何保留參考內容及回應指示。

評測納入 15 個多模態大型語言模型,並以 12 項客觀指標和 5 項主觀指標檢視執行成功率、效率、影片品質、指示吻合度及參考內容保真度。相比只看成片觀感,這套基準亦檢查程式碼能否執行及生成流程的效率;不過,評測結果仍受任務設計、指標定義和主觀評分影響,不能單憑總排名推斷模型適合所有影片工作。

研究團隊可用它比較不同模型在特定輸入形式或影片任務上的表現,亦可檢查系統瓶頸是在程式碼執行、視覺品質,還是參考內容對齊。儲存庫提供評測程式,任務提示、標註、品質檢查清單及參考媒體資料則放在 Hugging Face;提供的資料未列出安裝步驟或完整執行流程,採用前需查看相關程式碼與資料集說明。

  • 支援 T2V、I2V、V2V,並涵蓋獨立任務與來源影片配對任務。
  • 模型以 HTML/CSS、SVG、Canvas 或 Three.js 產生程式碼,再由 Remotion 渲染影片。
  • 以 12 項客觀指標及 5 項主觀指標,評估執行、效率、品質和指示吻合度。
  • 適合模型研究及影片生成系統團隊作比較;它本身不是影片生成模型。

項目主頁 · GitHub · 數據集

Categories: 開源, AI productions, 模型, 多模態模型, Video, Image, 庫, Dataset 數據集

Page 3 of 32
1 2 3 4 5 … 32