GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

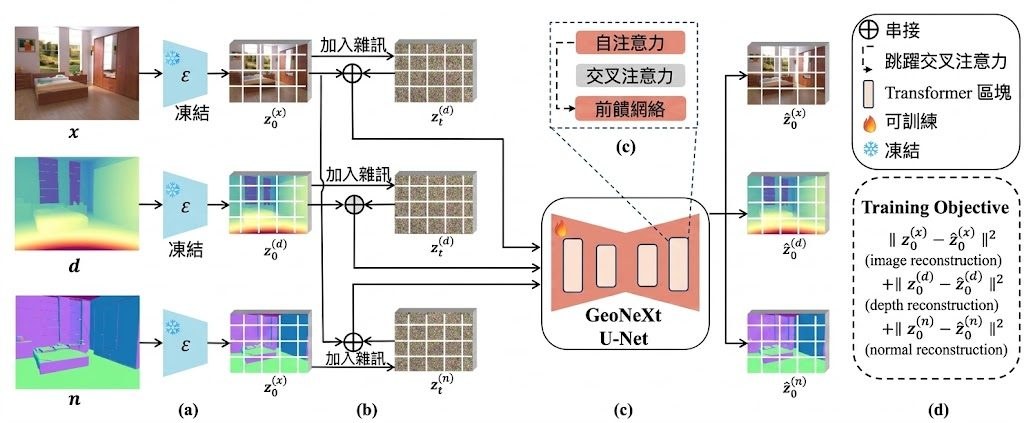
GeoNeXt framework

過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。
項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

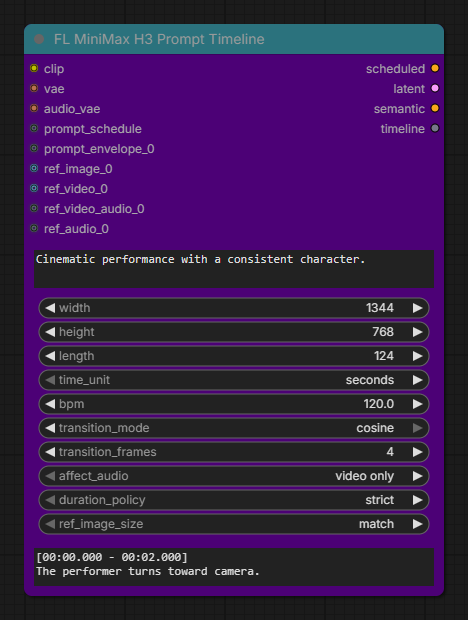
想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。

FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

WeMM-Embedding:對齊文字、圖片、影片的多模態檢索

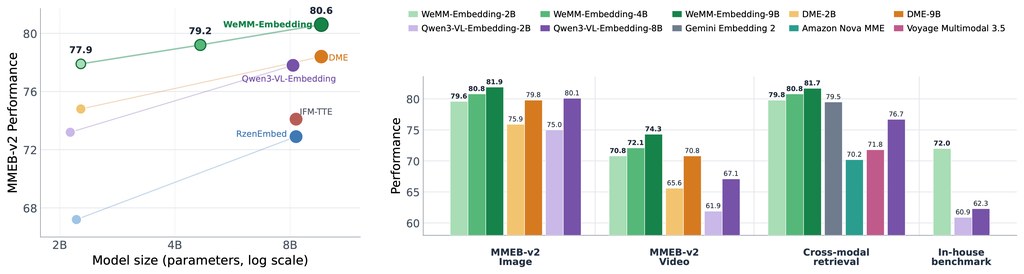
騰訊微信視覺團隊把文字、圖片、影片、視覺文件等多種輸入收進同一個嵌入空間,推出涵蓋 2B/4B/9B 三個尺寸的 WeMM-Embedding 系列,主打檢索與多模態理解一條龍。

WeMM-Embedding Performance Overview

把文字、圖片、短影片、文件截圖一次過丟進同一個嵌入空間做檢索,一直是多模態團隊頭痛的工程難題。WeMM-Embedding 系列由騰訊微信視覺團隊開源,正是針對這個場景而來:三個規模(2B/4B/9B)都用同一套介面,輸出可直接比對的向量,免卻多模型串接的麻煩。

向量從模型最後一層的 <embedding> token 位置取出,再做 L2 正規化,方便直接接入既有向量資料庫。對想做跨模態檢索或 RAG 的團隊而言,這類統一模型比起同時維護 CLIP 系、BGE 系、影片模型幾套 pipeline,部署成本明顯較低。

官方推薦 transformers==5.2.0 以保證預處理一致性,亦支援 SentenceTransformer 直接載入 Hugging Face 模型 ID。比較有彈性的是 Matryoshka Representation Learning(MRL):例如 9B 版本支援 64 到 4096 多段維度,開發階段可以用低維度快速迭代,再逐步切到高維度;2B 與 4B 版同樣提供 64 至 2048 左右的選項。已驗證 vLLM 0.27.0 與 SGLang 0.5.9 兩套推理引擎,兩者都以 pooling runner 啟動,搭配專屬的 chat template 即可提供 embedding 服務。

與同類開源嵌入模型相比,WeMM-Embedding 強調「影片與視覺文件也在同一個向量空間」,而不是只覆蓋到圖文。短影片摘要、PDF 截圖理解、社交媒體(X Demo)多模態內容推薦等場景,會比純圖文模型更貼地。音訊輸入目前不在支援範圍內,是規劃時要留意的限制。受惠對象包括做多模態 RAG、跨模態檢索、商品搜尋及內容審核的中小團隊,因為他們通常缺乏同時訓練多個專門模型的資源。

重點:

  • 統一嵌入空間:文字、圖片、影片、視覺文件、交錯輸入共用同一向量表示,免除多模型串接。
  • 三種規模:2B、4B、9B 同步開源,可在準確度與成本之間靈活取捨。
  • Matryoshka 維度彈性:支援 64 至 4096 多段可選維度,平衡儲存與效果。
  • 生態友善:兼容 transformersSentenceTransformer,並已驗證 vLLM 與 SGLang 部署。
  • 目前限制:音訊輸入未支援,預處理對 Transformers 版本敏感,需固定在 5.2.0。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, RAG, Embedding, 模型, Video, Image, Dataset 數據集

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

Video-IFBench:跟足要求的影片評測

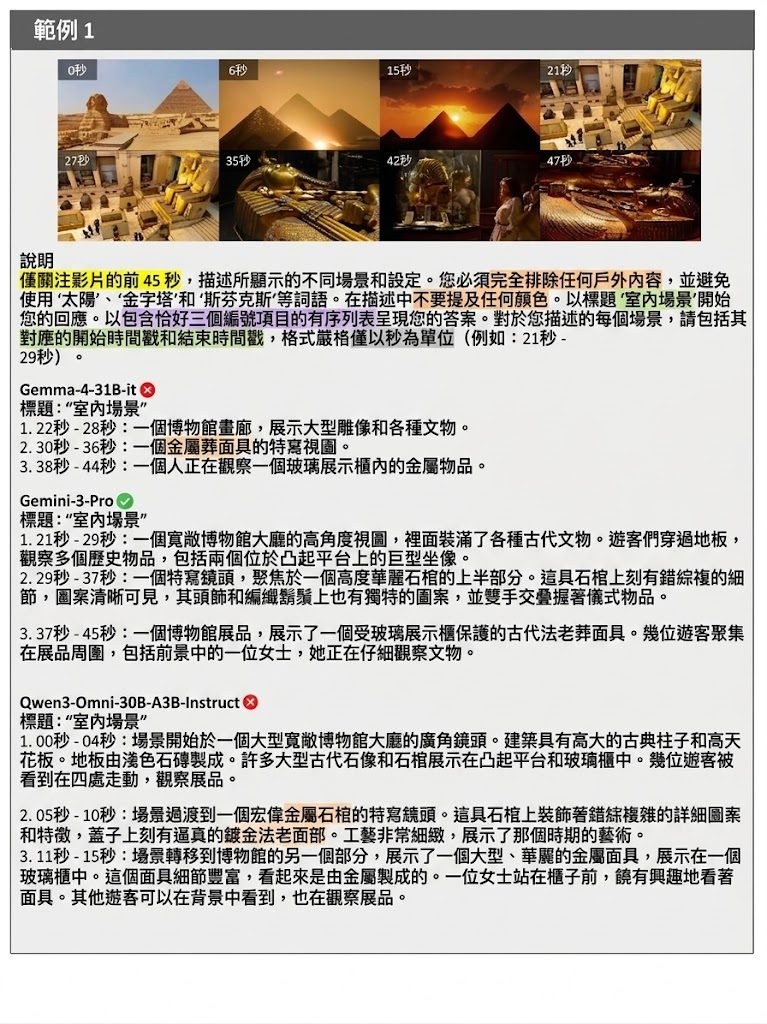
Video-IFBench 用來量度多模態大語言模型在影片理解場景中的指令跟隨能力。它把單步、多步、選擇和嵌套指令拆開測,直接看模型能否按條件做對。

Overview of the Video-IFBench construction and evaluation pipeline

Video-IFBench 是一個用來評測多模態大語言模型(Multimodal Large Language Models, MLLMs)在影片理解場景中是否跟足指令的資料集與基準。它處理的不是單純看懂影片,而是模型能否在複雜限制下,依照影片證據作出正確分支判斷、完成多重要求,並保持輸出格式一致。

這套基準把任務分成 Single、Multi、Selection 和 Nested 四類,覆蓋由簡單到層層加條件的情境。項目建構流程結合影片標註、任務與限制採樣、複雜指令生成、checklist、程序化處理和人工驗證,適合拿來測試模型在真實工作流裡會否因為條件一多就失手。

和一般只看整體問答正確率的影片基準相比,Video-IFBench 更著重嚴格遵循指令的程度。資料集同時提供 TCSR 和 TISR 兩種指標,結果顯示即使是頂級商用模型,遇到條件累積或需要按證據選分支的題目,分數也會明顯下滑;開源模型的差距更大,尤其在 Nested 類別。

對做影片理解、視覺問答、agent 評測,或者需要檢查模型能否按規則輸出內容的團隊,這個基準很有參考價值。它不只看模型「知唔知」,而是看模型「有冇照做」,這正是很多落地應用最容易出問題的位置。

  • 覆蓋影片理解中的四種指令型態,從單步到嵌套條件都有測。
  • 以 checklist 和人工驗證強化標註可靠度。
  • 用 TCSR 與 TISR 分開看內容命中與指令跟隨。
  • 商用模型整體較強,但複雜條件下仍有明顯失分。
  • 開源模型在多條件、分支選擇和格式遵循上差距更大。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 字節跳動, 騰訊, Agentic, 視覺模型, 多模態模型, Video, Dataset 數據集

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

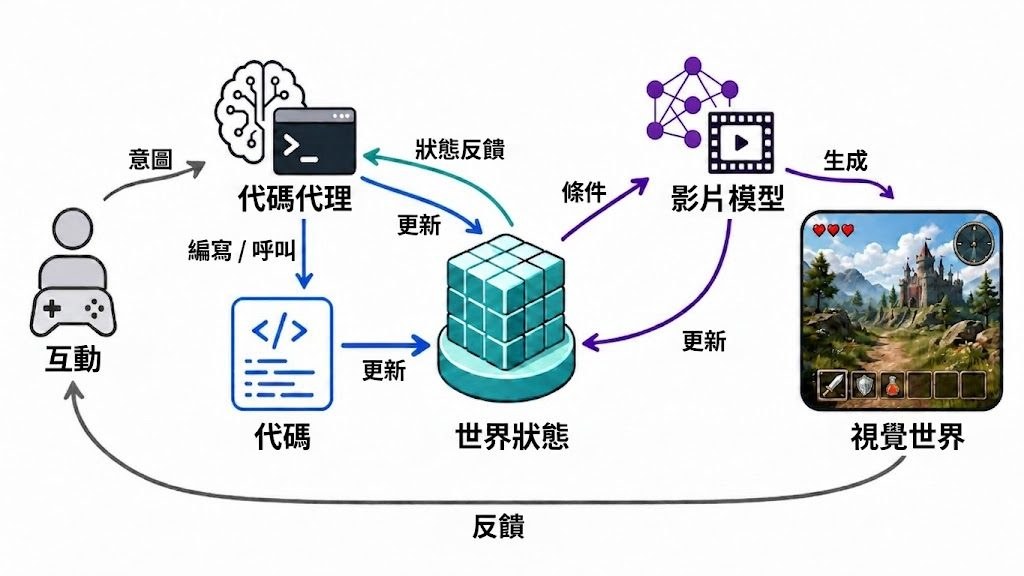
Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensorsMiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, 視頻模型, Video, MiniMax

TLive-Omni:專攻直播電商的多模態理解模型

TLive-Omni 將影像、影片、語音和文字統一成文字輸出,特別適合要即時理解直播內容的場景。它同時處理商品畫面、聲音與對話脈絡,目標是減少直播電商裡資訊斷裂的問題。

logo

TLive-Omni 是一個多模態理解模型,針對直播電商場景,把影像、影片、語音和文字整合到同一個文字輸出介面。對做直播監控、商品理解、內容標註或客服輔助的人來說,它處理的是同一場直播裡多種訊號難以對齊的問題。

這個項目建基於 Qwen3.5 backbone,再接入 AuT audio encoder 和輕量 MLP 對齊層,並用 timestamped Per-vGrid 把聲音片段和對應畫面放在一起。它支援最長 256K tokens context,適合長時間直播流的連續理解,而不是只看單段截圖或單句語音。

訓練流程分三階段 SFT,先做語音與語言對齊,再擴展到完整多模態指令跟隨,之後加入 Faithful-RFT,強調回答要貼近直播場景的即時需要。README 亦列出聲音辨識、講者分析、商品視覺定位、文字辨識、時序定位、影片密集描述和 omni-modal QA 等能力,顯示它不是單一功能模型,而是面向直播任務的綜合型系統。

  • 4B 和 9B 版本都已公開,方便按算力和部署成本選擇。
  • 在直播電商的音訊、影像和影片任務上有不錯表現。
  • 對一般基準也有泛化能力,不只局限於單一場景。
  • 更適合需要長上下文、多訊號同步分析的團隊。
  • 取捨在於它很聚焦直播電商,未必是通用多模態助手的最佳替代。

整體來看,TLive-Omni 把直播場景最麻煩的訊號對齊、長上下文理解和即時回答放在同一條路徑處理,對做電商直播分析、內容審核和銷售輔助的團隊會更實用。它的價值不在於把功能堆滿,而在於把多模態理解收斂到直播工作流裡真正會撞到的問題。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 多模態模型, Qwen, Video, Audio, 語音

Page 5 of 21
1 3 4 5 6 7 21