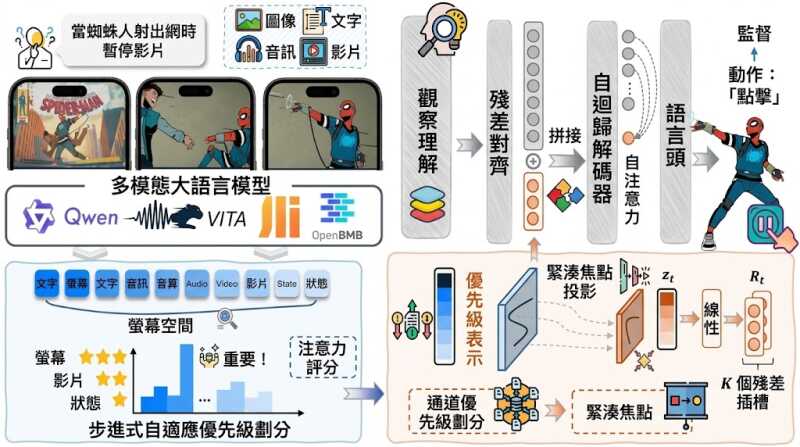
南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。
它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。
對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。
項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。