MiniMax-H3 Orbit LoRA 360° Bullet Time 環繞鏡頭

一張相片配合同一張首尾關鍵幀,鏡頭可繞主體 360°移動,場景保持凝固並回到原始畫面。

Og image

想把靜態相片製成可循環播放的環繞鏡頭(Bullet Time),MiniMax-H3 360° Orbit LoRA 針對的正是首尾畫面難以對齊、場景容易變形的問題。它是基於 MiniMaxAI/MiniMax-H3、FL2VA variant 的 LoRA adapter,配合同一張圖片作為 first frame 與 last frame,令鏡頭完成連續 360°orbit,而人物和物件維持原本位置、姿勢及形狀。

模型的 instance prompt 明確要求只移動相機,利用 camera parallax 產生視覺變化;模型不應加入縮放、切鏡、變形或新物件。影片末端回到開始畫面,因此多段 orbit 可以串接,減少循環接點出現跳變。

  • 適合產品展示、人物定格、場景掃視,以及需要無縫循環的短片項目。
  • LoRA 屬於附加權重,不能單獨取代 MiniMax-H3;頁面未提供參數規模、上下文長度或訓練細節。
  • MTP draft speculation、v2 更新、檔名變更及 chat template 注意事項亦未有資料,不能據此推斷推論效能或資源需求。

結果比較採用相同 seed、prompt、解析度和 step count,但展示內容仍屬範例,未有量化的畫質、穩定性或速度指標。對需要精確幾何還原、長片一致性或非環繞運鏡的項目,頁面資料不足以證明效果。

模型

Categories: AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 3D, MiniMax, LoRA

WorldPlay2 即時控制互動世界模型

WorldPlay2嘗試令世界模型在多樣場景中持續演化,同時保留即時反應與細緻控制,代價是系統仍未準備好供外部重現。

Repository image for WorldPlay2/WorldPlay2

想令場景隨鏡頭、角色動作和語意事件持續發展,世界模型往往要在即時反應、控制彈性與長時段一致性之間取捨。WorldPlay2 屬於互動世界模型,處理的正是這個矛盾:它可以跨越不同場景與角色生成連貫內容,並回應多種控制訊號。

模型把控制拆成兩層:一層是與影格對齊的連續動作,例如相機俯仰;另一層是結構化語意控制,分開處理場景外觀、角色身份和動態語意事件。這樣做比只依賴單一動作介面更容易表達複合指令,但亦令控制學習和資料整理更複雜。

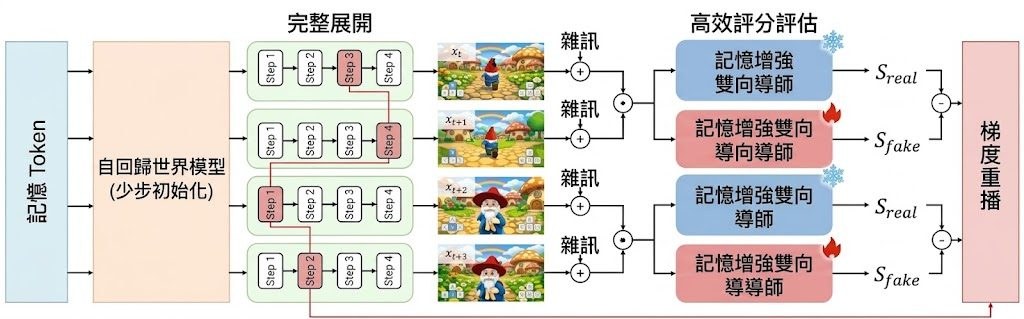
長時段生成由壓縮記憶和 Stable Forcing 支撐。歷史影格會被壓成緊湊的 memory tokens,供自回歸 student 與雙向 teacher 共用,蒸餾時改以分片、受記憶條件約束的分數評估,避免每次都處理整段 rollout;Stable Forcing 則先以少步策略初始化 student,再透過完整 rollout replay 維持長序列品質。

  • 可跨多樣場景與角色保持較長時間的一致性
  • 同時支援影格對齊動作與結構化語意控制
  • 以壓縮記憶降低長時段蒸餾開銷
  • 實驗聲稱整體表現優於既有方法,但未提供可核對的詳細指標

研究者、互動遊戲原型團隊和需要可控視頻生成的開發者較容易從中受益,尤其適合研究鏡頭控制、角色持續性及長期世界演化。儲存庫仍在整理程式碼與權重,README 沒有提供安裝、下載或測試流程,現階段較適合先觀看展示影片和研究方法;正式重現仍要等待相關檔案公開。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, 庫

一個 LoRA 同時做卡片自轉與 360 度環繞

MiniMax-H3 的 rank-32 LoRA可按提示詞切換卡片自轉與正常鏡頭環繞,適合製作具指定運鏡效果的短片。

Og image

相片會像按提示詞改為圍繞靜止主體作順時針 360 度運鏡。這個影像轉影片模型配接器基於 MiniMaxAI/MiniMax-H3,並針對 MiniMax-H3 Ref2VA 微調,屬於rank-32 LoRA,並非獨立的完整基礎模型。

模型以提示詞選擇兩種行為:ORB360_CARDSPIN 會讓畫面在5.125秒後準確回到原始相片;ORB360_CW 則維持一般順時針環繞效果。適合產品相片、人物肖像、寵物影像及需要固定鏡頭路徑的短片製作,同一個 LoRA 檔案可以因應不同鏡頭意圖重用。

頁面提供的示例使用單張參考圖,輸出尺寸為1024 x 768,共124幀,以20 steps 及指定 seed 生成。示例亦指出,加入卡片自轉能力後,原有的360度環繞效果仍能正常運作;不過頁面沒有提供系統化基準測試、失敗率、硬體需求或速度數據。

  • LoRA 權重為 rank-32,基於 MiniMax-H3 Ref2VA
  • 以ORB360_CARDSPIN及ORB360_CW切換兩種運鏡行為
  • 卡片自轉片段固定為5.125秒並回到起始畫面
  • 標籤列出 ComfyUI、musubi-tuner及camera-control等相關工具或方向
  • 頁面未提供GGUF檔案、量化版本、mmproj、上下文長度、v2更新或檔名變更資料

頁面展示了 MP4 示例及提示詞檔案,但沒有交代完整安裝流程、推論框架設定或MTP draft speculation支援。

模型

Categories: ComfyUI, AI productions, Video, Image, MiniMax, LoRA

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

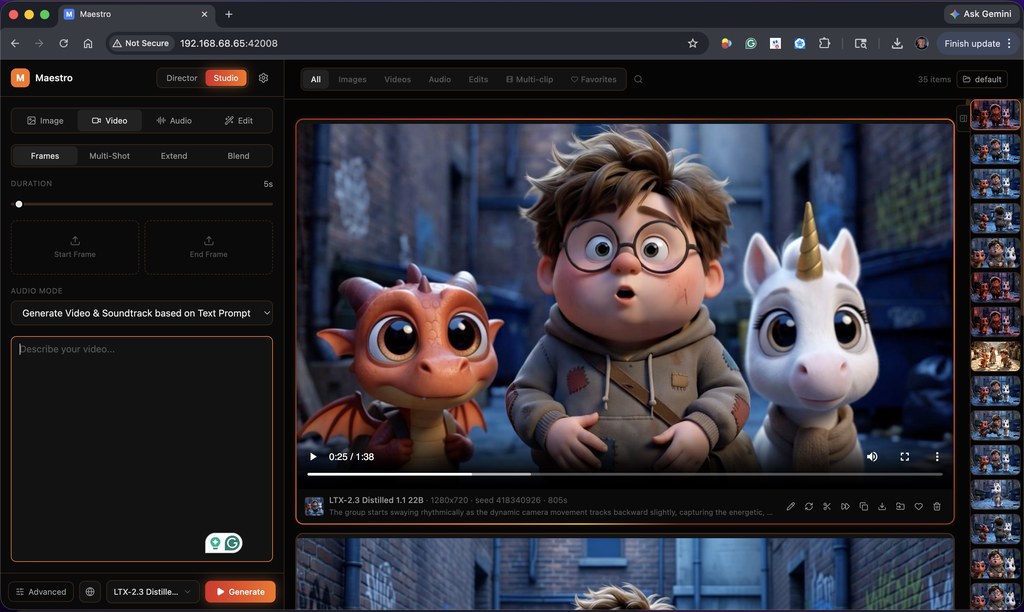
Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

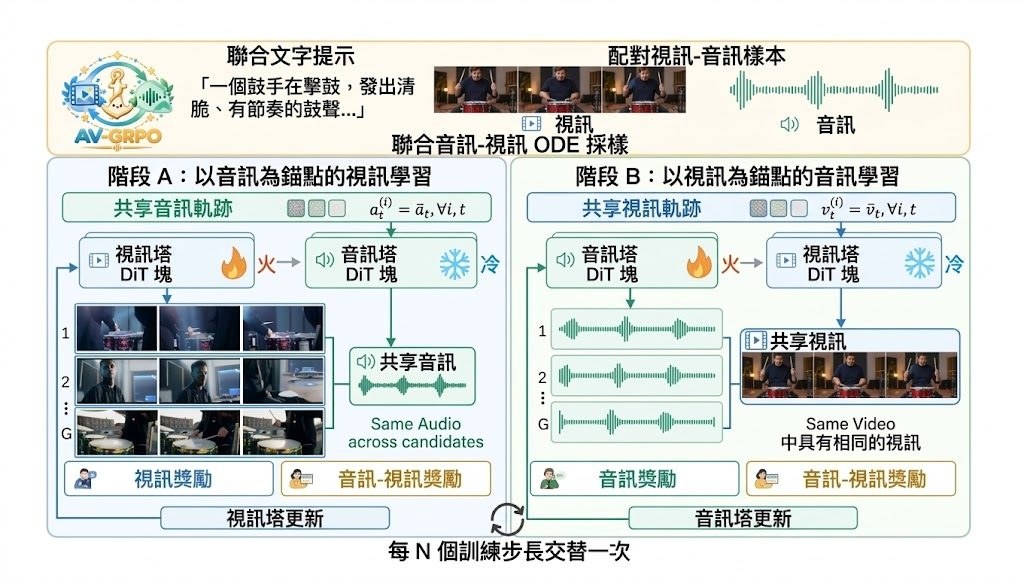
這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

InternW0 讓機械人邊預測未來邊靈活操控

面對接觸、受力和環境變化,InternW0把未來視覺預測與連續動作控制結合,提升機械人完成操作任務的穩定性。

Shanghai Artificial Intelligence Laboratory

機械人處理實驗室器具、液體轉移或其他需要接觸感知的工作時,往往要同時理解下一刻會見到甚麼,以及當下應該施加甚麼動作。InternW0屬於 Physical World Model,透過非對稱 video–action 架構,把未來視覺預測與連續控制放進同一套流程。

它採用 mixture-of-transformers backbone,由高容量 video expert 預測較長時間範圍的視覺變化,再由較輕量的 action expert 根據最新觀察調整動作。Observation-conditioned context routing 會隨視覺和物理回饋更新上下文;force 與 tactile channels 則在 contact-aware post-training 中加入,協助處理接觸場景。

訓練部分以 joint video–action flow matching 學習未來動態與控制策略,Wan VAE 負責影片編碼,DINOv3 encoder 提供當前視覺觀察。七個數據集合共提供 7,233.5 小時資料,涵蓋真實機械人軌跡、模擬操作,以及 EgoLab 的實驗室第一身影片。

  • LIBERO 四個任務套件平均成功率達 98.6%
  • RoboTwin 2.0-Full 平均成功率為 93.12%
  • Clean2Random 平均成功率為 75.60%
  • RTX 5090D 上每次動作更新需時 60.73 毫秒,模型端策略更新率為 16.47 Hz

InternW0較適合需要長程預測、即時反應和接觸控制的機械人研究與實驗室工作流。資料未有提供完整安裝或下載使用流程,讀者應按官方提供的 Paper、GitHub、Hugging Face 或 ModelScope 資源確認可用版本與存取方式。

項目主頁

Categories: 開源, 上海人工智慧實驗室, 模型, 世界模型, 模型訓練, Video, Robotic, Dataset 數據集

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

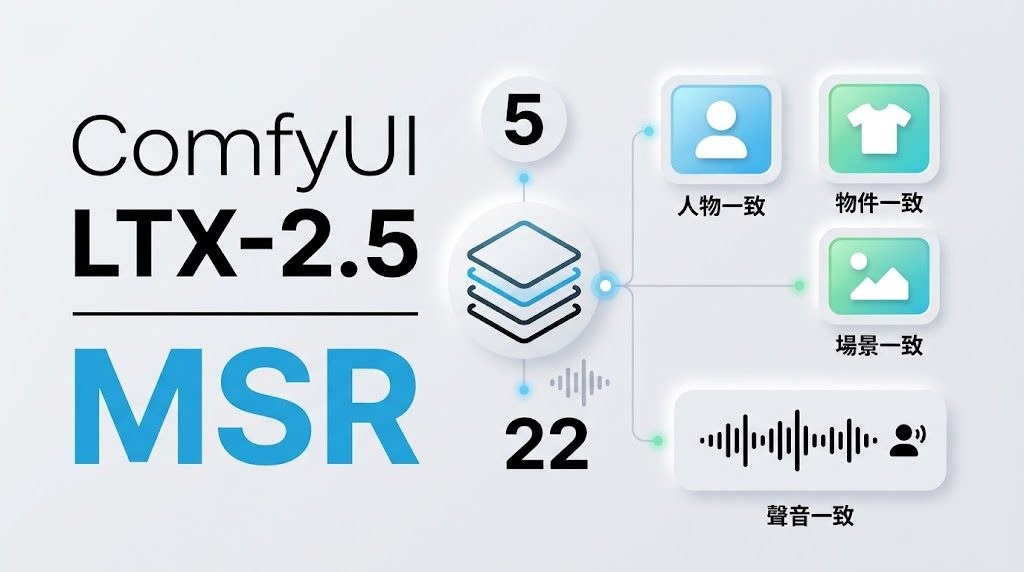
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

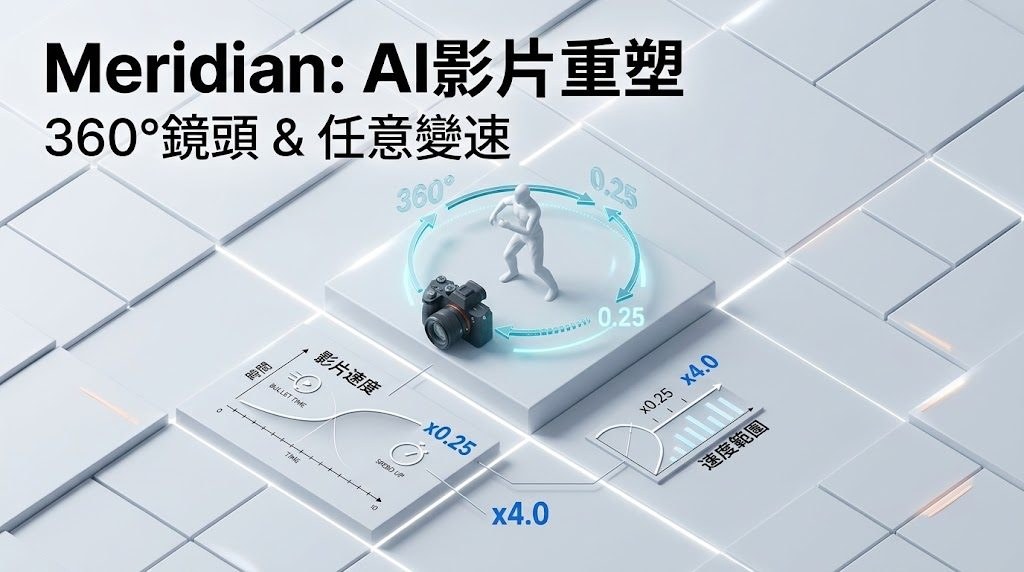
Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

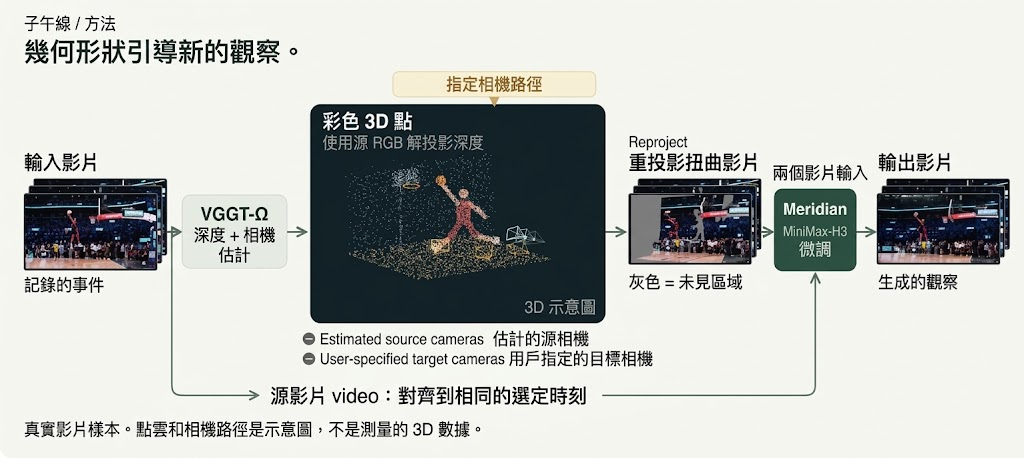
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

Page 10 of 32
1 … 8 9 10 11 12 … 32