Calliope:由故事到成片 : ComfyUI 本地工作流

Calliope 將故事拆成劇本、鏡頭片段,再交由本機 ComfyUI 生成影片,兼顧創作流程與資料私隱。

Repository image for benjiyaya/Calliope

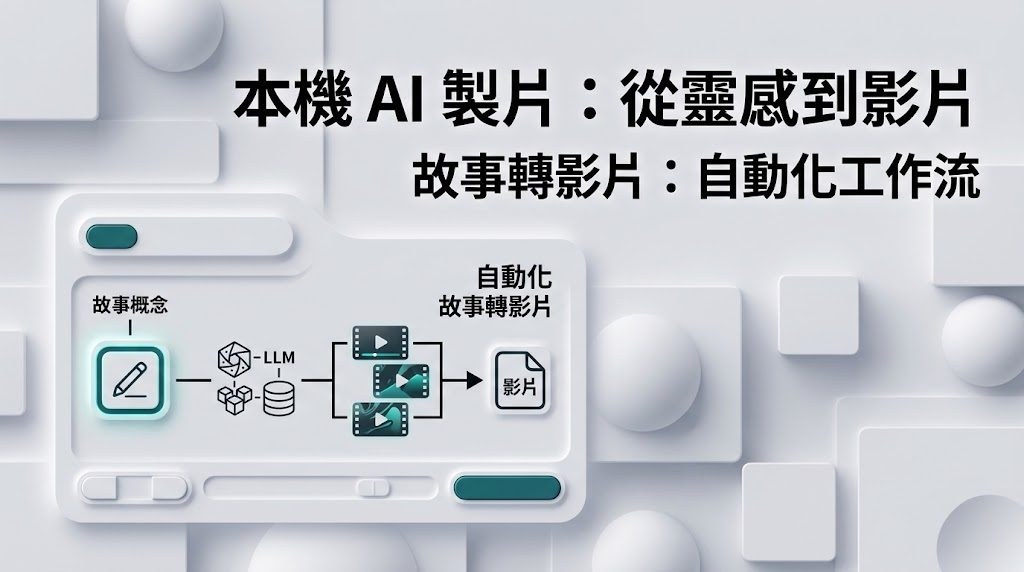
由一個故事構想開始,Calliope 會整理情節節拍、角色與場景,再按場景寫出貼近劇本的內容,拆成多個鏡頭片段交給 ComfyUI 生成影片。它屬於本地優先的 story-to-video 工具,處理的是文字創作與影片生成之間需要反覆整理、分鏡和合成的工作。

LLM 負責故事結構及逐場景腳本,ComfyUI 則按既有 workflow 和模型逐個產生片段,兩者分工清楚;完成後再由 ffmpeg 加入 crossfade、匹配音量並串成完整影片。項目資料放在 SQLite,媒體保存在本機資料夾,只有你指定的 LLM endpoint 可以是雲端服務,因此私隱程度和可控性較依賴本身的模型及 ComfyUI 配置。

Make AI Micro Dramas From Script to Video Locally Using Calliope 1.5

使用前需要 Python 3.11+、Node.js 18+、已安裝模型的 ComfyUI、OpenAI-compatible LLM endpoint,以及可從 PATH 呼叫的 ffmpeg。前端是 SvelteKit,後端採用 FastAPI;啟動兩者後,在 Settings 設定 LLM、ComfyUI URL 及可選的 agent 分工,亦可調整並行工作數、輪詢間隔和等待上限,長時間影片工作可把預設 30 分鐘 timeout 延長,或設為無限等待。

適合需要保留素材在本機的個人創作者、小型製作團隊,以及已經建立 ComfyUI workflow、想加入故事編排層的使用者。Dry-run 只會產生佔位結果,不能用來判斷真正的影片效果。

  • 流程完整:由故事、劇本、分鏡到片段合成集中處理
  • 本機優先:項目資料與媒體不必上載到雲端
  • 依賴明確:需要自行管理 ComfyUI、模型、LLM endpoint 和 ffmpeg
  • 可調整佇列:支援並行數、輪詢設定及長任務 timeout
GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, API, Video, 工具, Content Creator, Python

VideoGen-Agent 讓影片生成懂得規劃、驗證與修正

影片生成不再只靠一次輸出,VideoGen-Agent會分步使用工具,檢查結果後再修正畫面與內容。

VideoGen-Agent logo

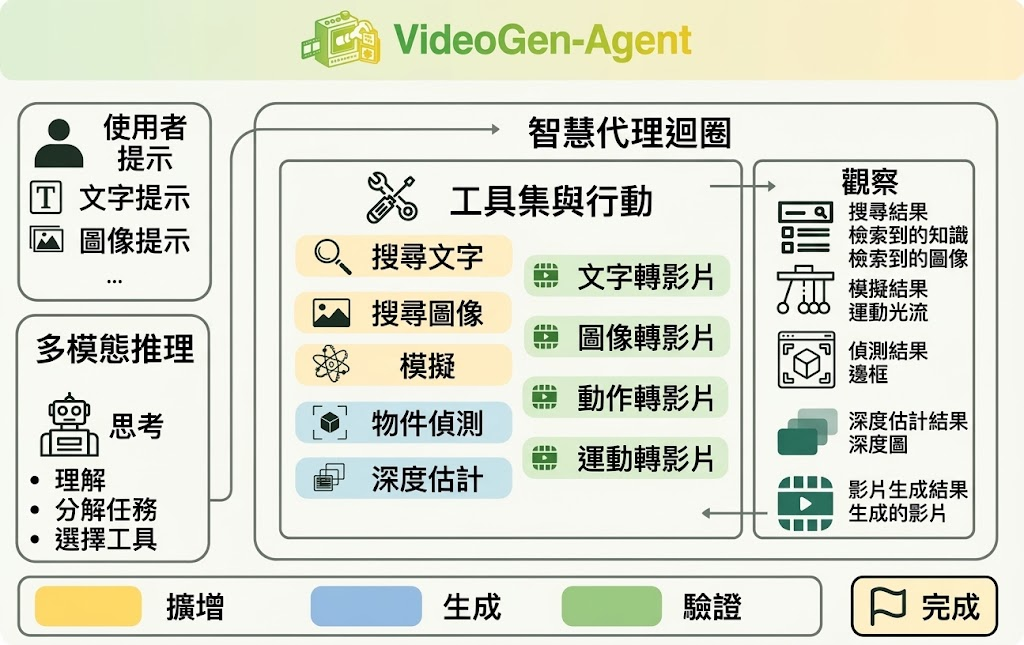
面對需要維持人物身份、物理關係、場景構圖或事件次序的提示詞,一次生成往往難以兼顧所有要求。VideoGen-Agent以多模態代理配合強化學習,讓影片生成流程加入規劃、工具操作和視覺驗證,逐步處理這些容易出錯的部分。

代理會在多輪互動中協調 augmentation、generation 和 verification 工具,根據提示詞及中途觀察結果決定下一步行動。訓練先以教師生成的工具使用軌跡建立基本行為,再透過 multitask agentic reinforcement learning 改善工具選擇和生成品質,並以混合獎勵同時評估工具呼叫有效性、任務配合程度及影片效果。

VABench 包含600個提示詞,涵蓋程序知識、單一及多個實體的身份保持、物理一致性、場景構圖和多鏡頭時間結構。以 Seedance 1.0 T2V 作為基礎生成器時,VideoGen-Agent分數由56.5提升至75.6;推理時換用 Toolset 2,即使不重新訓練代理,分數仍升至86.1,人類評審在雙選比較中有84.3%偏好升級後的配置。

• 以多步驟代理流程取代單次影片生成
• 結合 augmentation、generation 和 verification 工具
• 針對身份、物理一致性及事件順序等難題作出驗證
• VABench涵蓋600個多類型提示詞
• 程式碼及資料集當時仍標示為即將推出

這種做法較適合需要精準遵循複雜提示詞的影片創作、研究評測及工具驅動工作流。它仍依賴可用的生成與驗證工具,代理表現亦會受基礎模型、工具能力和評估方式影響,不能把分數提升直接視為所有影片場景都能獲得相同效果。

項目主頁

Categories: 香港中文大學, Agentic, AI productions, Video, 提示詞

physics:拆解 Wan2.1 的物理失誤

籃球彈跳變成半空漂浮,問題可能早在去噪頭幾步由注意力決定。這個研究以 RoPE 調整改善影片動態。

teaser

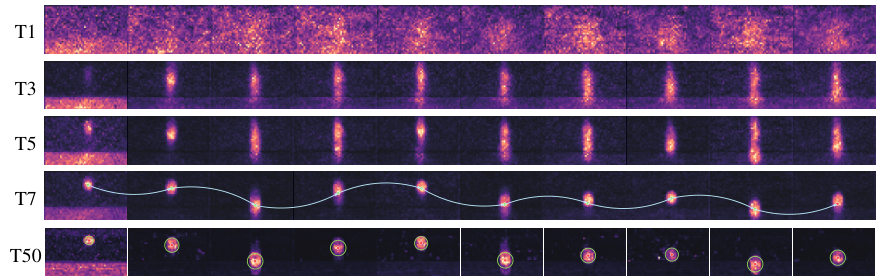
一個籃球由半空跌落後,理應撞地再彈起,Wan2.1-T2V 卻可能生成漂浮、突然停頓或半空反彈。這個 GitHub 項目屬於影片生成模型的可解釋性研究,實際處理的是 text-to-video diffusion models 如何在早期去噪階段規劃物件軌跡,以及錯誤位置為何會一路鎖定。

研究把視線集中在 Wan2.1-T2V-1.3B 的最初五個去噪步驟,透過 video-to-object-token cross-attention 追蹤物件位置,再配合 convergence speed 和 causal contribution 找出負責形成軌跡的 attention heads。分析指出,Self-attention 中的 Rotary Position Embedding (RoPE) 會令空間注意力衰減過快,早期錯誤候選位置因此壓過鄰近影格較合理的路徑。

修正方法不依賴外部物理模擬器或額外 foundation-model teacher,而是在早期步驟降低 height/width RoPE frequency,測試時前五步使用 λ^{h/w}=0.70;需要訓練時則以只作用於 self-attention 和 cross-attention 的 Low-Rank Adaptation (LoRA) 配合 λ^{h/w}=0.75。LoRA 設定為 r=64、alpha=32,並以首 10% 去噪步驟佔 0.9 機率的混合 timestep sampler 加強早期學習。

測試這個項目時可沿用 Wan 官方模型與提示詞,以不同 random seeds 比較原模型、training-free 頻率調整及 LoRA 版本的籃球跌落等片段;程式透過 runtime monkey patches 修改行為,不需要改動官方 Wan source。提供的資訊確認有 training-free 和 training-based 實驗,但未列出完整數值指標,因此更適合視為機制分析與可重現的研究原型,而非已證明能處理所有物理場景的通用修補方案。

  • 物件軌跡主要在最初五個去噪步驟形成
  • Cross-attention 負責引入物件語義,self-attention 協助選擇候選區域
  • RoPE 空間衰減過強,會令錯誤位置過早固定
  • 可用早期頻率縮放,或加入只改注意力層的 LoRA
  • 適合研究影片生成、模型可解釋性及物理一致性的團隊

項目主頁 · GitHub

Categories: 開源, AI productions, Embedding, 模型, 視頻模型, 模型訓練, Video, 提示詞

WorldCrafter 記住你走過的世界

WorldCrafter把單張圖片或文字提示變成可操控鏡頭的連續場景,改善長時間探索時畫面失憶與視角不一致的問題。

鏡頭移開再回望時,生成場景仍能維持空間關係,正是 WorldCrafter 要處理的核心卡位。它屬於影片世界模型,能從單張圖片或文字提示建立可探索場景,並按照鏡頭控制生成後續畫面,減少長時間移動、回訪視角時的內容漂移。

WorldCrafter以可由鏡頭查詢的隱式 3D-aware memory 保存過往觀察,讓指定視角決定哪些歷史資訊交給影片生成器;記憶編碼器與姿態條件讀取模組會把不同視角的資料整理成目標視角適用的 memory tokens。它不依賴顯式深度估計或幾何 warping,近期 temporal context則負責維持動態物件和連續動作。

WorldCrafter Video Demo

提供 WorldCrafter-Base,以及經蒸餾、面向較快推理的 WorldCrafter-Fast。兩者可在 Linux、Python 3.11、NVIDIA GPU 和相容 CUDA 驅動環境運行,模型權重放在 Hugging Face;Fast 版本較適合互動式串流,但硬件要求和生成速度仍取決於本地配置。

  • 支援圖片轉可探索世界,也支援文字轉可探索世界
  • 可控制鏡頭、揭示未見區域,並回到曾經觀察的視角
  • 設計同時兼顧靜態場景、動態場景和長時間探索
  • 評測涵蓋145個場景及725條鏡頭軌跡

評測中,WorldCrafter在長時間回訪一致性和鏡頭控制準確度上優於參與比較的基線,整體 VBench 分數亦最高;項目展示的點雲與鏡頭軌跡重建,則用來檢查生成影片的幾何連貫性。研究團隊來自 Tencent ARC Lab 與北京大學,較適合研究生成式世界模型、可控影片、虛擬場景探索及互動內容的團隊測試。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 騰訊, AI productions, 模型, 世界模型, NVIDIA, Video, Image, 3D, Linux, Dataset 數據集

CrossView Warp : H3 LoRA 影片新視角

輸入原片與鏡頭偏移,就能生成同一場景的新視點;代價是需要 ComfyUI、深度變形及額外工作流程配合。

Og image

想從影片另一個鏡頭角度觀看同一場景,這個 LoRA 可直接處理方位角(azimuth)及仰角(elevation)偏移。它基於 MiniMaxAI/MiniMax-H3 微調,屬於 Ref2VA 影片生成用途,並非獨立的完整模型。

模型會同時讀取兩段影片:經過 CrossView Warp 的深度變形片段負責提供場景幾何,原始片段則保留人物身份與外觀。深度資訊由 MoGe Inference 產生,再交給 ComfyUI-CrossViewWarp 節點處理;生成結果對未被原片覆蓋的區域仍需要提示詞引導,因此新視角越大,畫面補全的不確定性亦可能增加。

使用流程集中於 ComfyUI:安裝 CrossViewWarp node,先取得 MoGe 幾何資料,再把 warp 與 source 調整至相同尺寸;載入 MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1_3500.safetensors 到 ref2va checkpoint,並以 MiniMax H3 Add Guide 和 MiniMax H3 Reference To Video 串接,frame_idx 設為 0。LoRA strength 建議由 0.8 開始,頁面建議範圍為 0.8 至 1.0,觸發詞是 crossview。

  • 已確認的基礎模型:MiniMaxAI/MiniMax-H3
  • 主要檔案:MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1_3500.safetensors
  • 頁面未列出 GGUF 檔案、量化級別、mmproj、檔案大小或量化建議,因此不能推斷 Q4_K_M 等本地推理配置
  • 頁面只明確提供 ComfyUI 工作流程,未確認 llama.cpp、Ollama、LM Studio、MTP draft speculation 或效能基準支援

它把 CrossView-Warp 概念移植到 MiniMax-H3,核心價值在於以幾何變形和原片外觀互補,協助影片生成模型維持場景連貫性。頁面提供多個 compare_* 影片作為 warp、原片與結果的並排示例;授權則標示為 minimax-h3-community-license。

模型

Categories: 開源, ComfyUI, AI productions, Video, 提示詞, 庫, MiniMax

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

Qwen3.8 邊講邊翻譯即時生成字幕

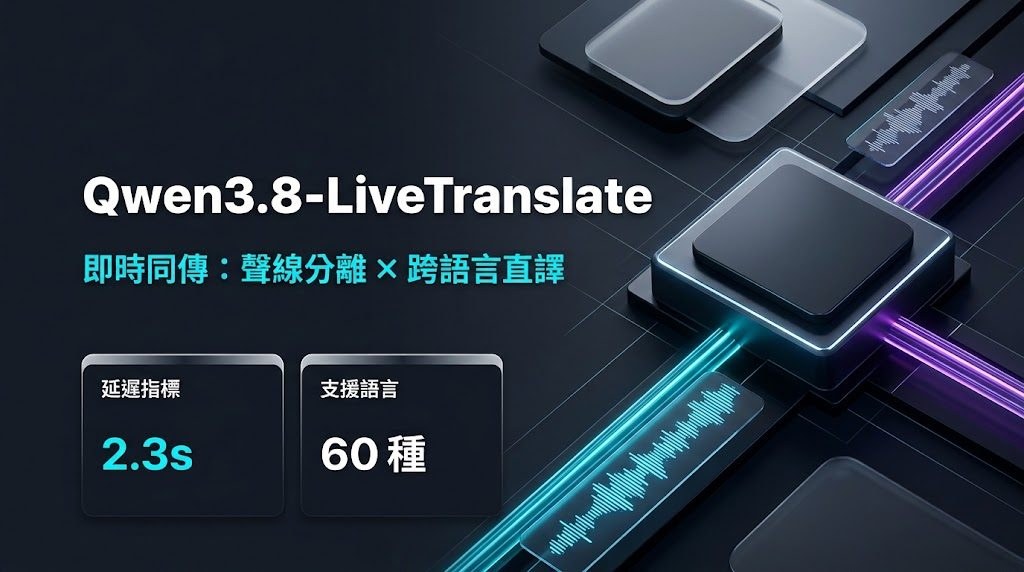
阿里旗下 Qwen 推出 LiveTranslate 模式,用同一個模型一邊聽語音、一邊翻譯、一邊輸出字幕,支援中文、英文等多語言即時對話。

Og image

Qwen 團隊最近公開了 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕。它把語音輸入、翻譯與字幕生成壓在同一個模型流程內,使用者開咪講一句,系統幾乎同步輸出另一種語言的文字,毋須額外挂接翻譯 API 或字幕引擎。

對於要做跨語言會議、外語直播、跨國客戶支援或聽打外語影片的團隊,這種一條龍處理可以直接省掉以往語音轉文字、再丟給翻譯模型、再做字幕排版的工序。直播主開英語節目時,中文觀眾可以即時睇到字幕;外語客戶打電話進來,中文客服亦可以一邊聽、一邊睇到對話內容。

LiveTranslate 屬於 Qwen3.8 系列下的語音功能延伸,目前支援普通話、英文等多語言之間互譯,亦可配合即時對話模式使用。Qwen.ai 用戶開啟 LiveTranslate 後揀選輸入與目標語言,便可以對住手機或電腦講話,螢幕同步顯示譯文。

Qwen 由阿里巴巴達摩院推出,屬於多語言、多模態大模型系列。LiveTranslate 的出現令 Qwen 在語音應用層面更貼近日常使用場景,而不限於純文字問答或文件分析。

重點摘要

  • Qwen3.8 新增 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕
  • 語音輸入、翻譯、字幕生成整合在同一個模型流程內
  • 支援普通話、英文等多語言之間的即時互譯
  • 可用於跨語言會議、外語直播、客戶支援等場景
  • 透過 Qwen.ai 網站即可開啟試用,毋須額外安裝

項目主頁

Categories: 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, API, Video, 語音

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

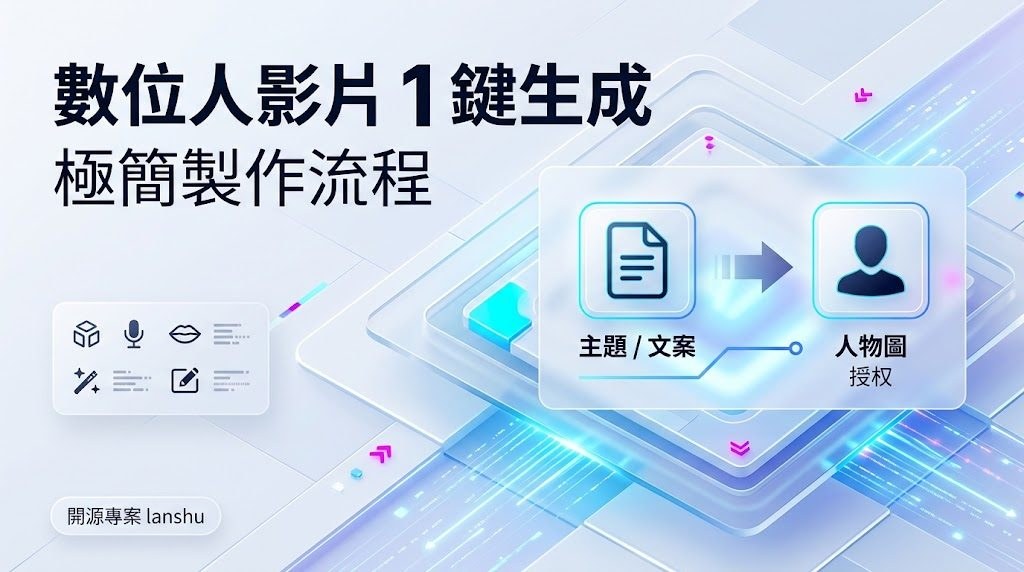
lanshu-create-ai-presenter-video:數字人影片 Skill:一張圖+文案自動生成完整講解影片

一個針對通用數字人影片製作 Skill。你輸入主題或文案,再加一張授權人物圖,它就會按完整配音時間軸組織生成、剪輯同驗收,輸出一條可發佈嘅講解片。

Repository image for cclank/lanshu-create-ai-presenter-video

做數字人講解片最麻煩嘅地方,往往唔係生成人物,而係口型、文字同聲音對唔齊,最後剪埋一齊就甩拍。lanshu-create-ai-presenter-video 嘅切入點正正喺呢度:佢將「完整配音」鎖定為全片時間基準,人物主素材、字幕、關鍵詞動效同鏡頭轉場都跟住呢條音頻排,從而減少口型漂移同片段接駁嘅問題。整個項目屬於 Agent Skill 工具,由 Codex 或其他兼容本地 Skill 嘅 Agent 環境直接調用,源碼本身唔綁定任何特定服務商、模型或私有接口,可以按當前環境可調用嘅能力動態選擇配音、人物生成同口型同步工具。

最低門檻只需要一份主題或文案,再加一張已授權、包含清晰成年人物嘅參考圖。聲音樣本、屏幕錄影、B-roll、品牌素材、目標平台、時長、橫豎屏同風格等都係可選輸入,畀進階用戶調整。Skill 目錄會隨階段讀取對應參考文檔:generation.md 處理文案、聲音、能力選型同人物提示詞;editing.md 負責時間軸、字幕預設、封面同導出;qa-recovery.md 處理技術驗收、人工驗收同常見故障修復,避免一次過佔用過多上下文。

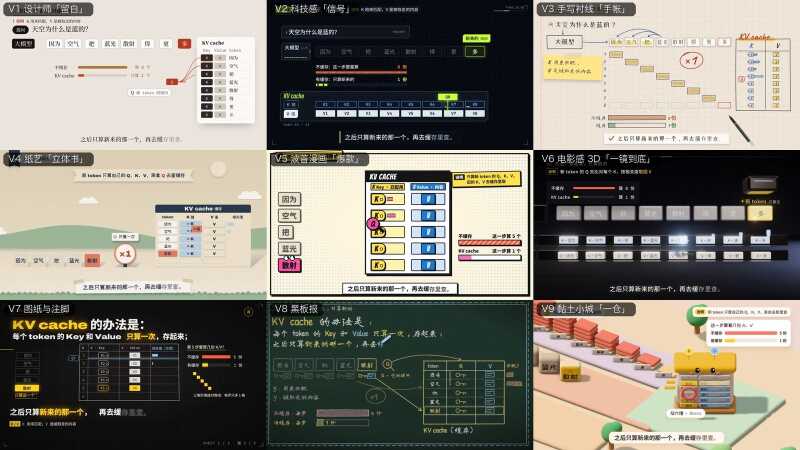
key名称the look · 画面best for · 适合3D
v1-editorialV1 设计师「留白」warm paper, ink, one vermilion accent, data blocks, page turns · 暖白纸、墨色、一抹朱红,大留白serious, premium explainers; business and product topics · 严肃、高级感、商业与产品no
v2-signalV2 科技感「信号」dark HUD, acid-lime accent, labels decode in, packets on wires, glitch cuts · 暗色仪表盘、荧光绿、数据包流动AI / infra / networking, anything “system-like” · AI、基础设施、网络、系统类no
v3-notebookV3 手写衬线「手帐」grid paper, a live pen writes every word, sticky notes, eraser · 方格纸上真笔书写、便利贴、橡皮擦teaching step by step, derivations, study notes · 一步步推导、学习笔记、教学no
v4-paperV4 纸艺「立体书」kraft pop-up book, pieces fold up with soft shadows, parallax · 牛皮纸立体书、折起的纸片、视差warm stories, processes, consumer topics · 有温度的故事、流程、大众话题no
v5-comicV5 波普漫画「爆款」halftone comic page, stickers slam on, bursts and sound words · 半调网点漫画、贴纸拍入、爆炸字punchy short videos, hot takes, myth vs fact · 节奏快的短视频、观点、辟谣no
v6-cinematicV6 电影感 3D「一镜到底」Three.js one-take in a graphite studio, porcelain props, bloom · 一镜到底的 3D 影棚、瓷质道具、辉光flagship pieces, launches, big-picture concepts · 旗舰内容、发布、宏观概念yes
v7-draftingV7 图纸与注脚one black drawing sheet, leader lines, ghost-letter karaoke, true footnotes · 黑色图纸、引线、注脚、卡拉OK式大字technical deep dives for practitioners · 面向从业者的技术深挖no
v8-chalkboardV8 黑板报a wooden blackboard written live in chalk, felt eraser, chalk mind map · 木框黑板、粉笔现写、板擦、粉笔脑图复习classroom feel, beginners, memory-friendly recaps · 课堂感、入门、便于记忆no
v9-clayV9 黏土小城「一仓」an isometric plasticine town, every analogy labelled with its real term · 等距黏土小城,比喻 + 真实术语标签analogies for non-experts, cute and friendly · 用比喻讲给外行、可爱亲和yes

預設輸出係 9:16、1080×1920、30fps 豎屏,時長 45 至 75 秒,發佈響度目標約 -16 LUFS。初始化可透過 init_job.py 自動建立標準任務目錄同 job.json,preflight.py 會做前期檢查,最後由 finalize_delivery.sh 收尾輸出,同時產出 QA 報告。環境要求 Python 3.9+、FFmpeg/ffprobe、Bash、jq、awk、sed,以及至少一種可調用嘅影片生成、語音生成同口型同步能力。

佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。

  • 以完整配音為全片時間基準,減少口型漂移同片段接駁問題
  • 源碼不綁定服務商或模型,可按環境動態選擇配音、人物、口型工具
  • 三份參考文檔按階段讀取,控制上下文用量
  • 預設 9:16 豎屏、1080×1920、30fps、主題片長 45–75 秒
  • 支援聲音樣本、B-roll、品牌素材、平台、橫豎屏等可選參數

GitHub

Categories: 開源, Agentic, AI productions, 數字人, Video, Audio, 提示詞, 框架, Content Creator, Python, 語音, Skill 技能

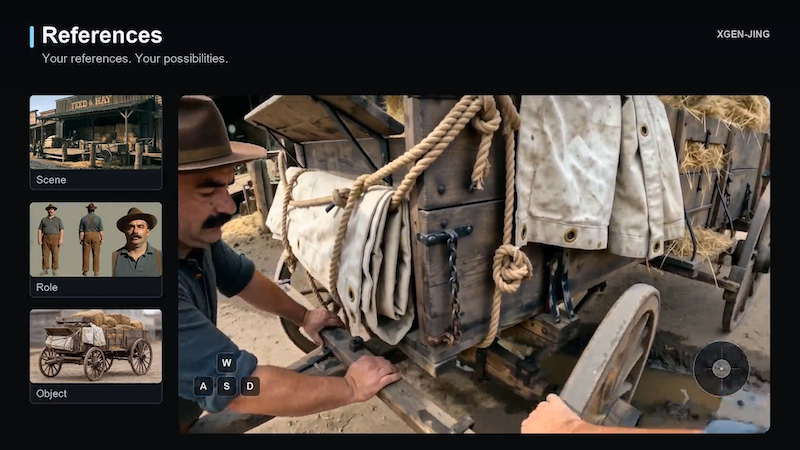
XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

Page 11 of 32
1 … 9 10 11 12 13 … 32