Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

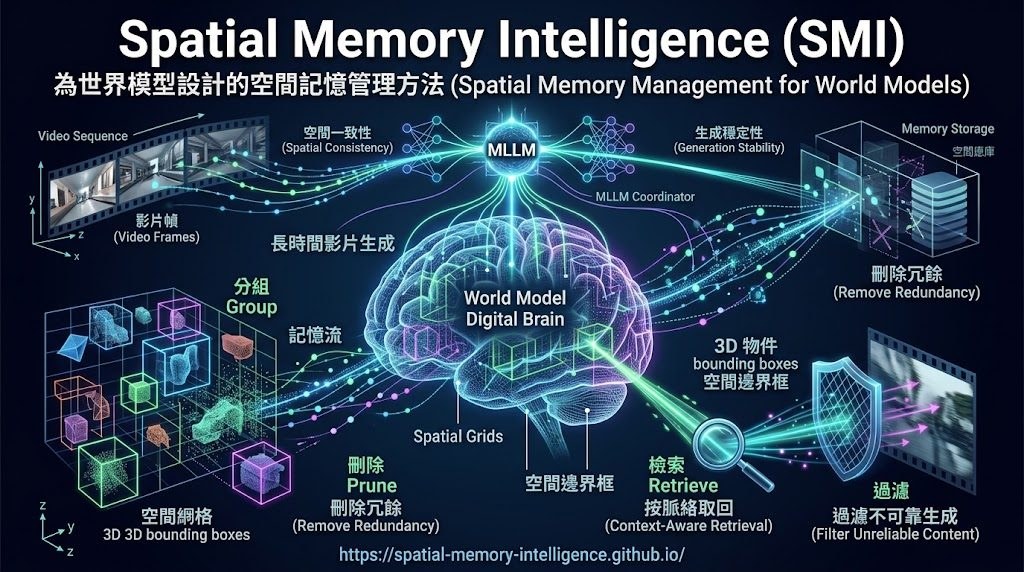
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

NAVA-WAM 讓機械人從影片學會直接行動

NAVA-WAM 從無動作標註影片學習機械人策略,減少視覺表徵與潛在動作之間的轉換限制。

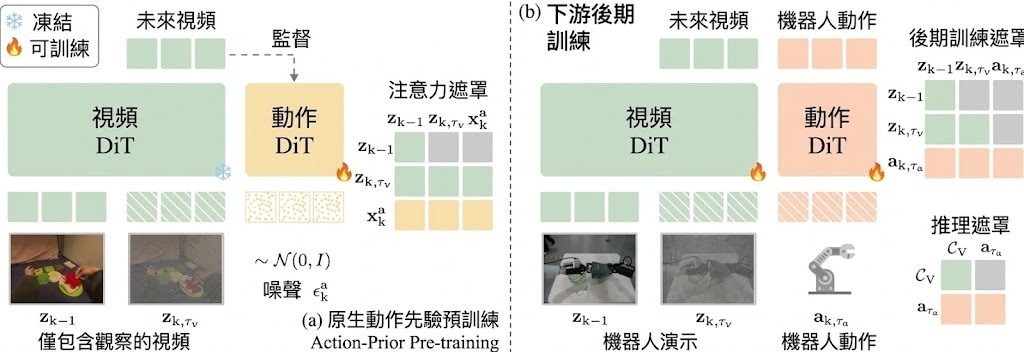
Overview of NAVA-WAM: action-free pre-training and downstream post-training.

機械人只看過人類操作影片,未必需要先建立中間視覺表徵或獨立的潛在動作模型,便能學習下一步應怎樣移動。NAVA-WAM(Native Action-Prior Learning from Videos for World Action Models)是一個 World Action Models(WAM)項目,直接從 observation-only videos 預訓練 action policy,處理動作標註機械人軌跡不足的問題。

訓練分為兩個階段:第一階段利用影片中的未來視覺變化作 flow-matching supervision,透過 transition-structured joint attention 將與動作相關的資訊傳入 Action-DiT;第二階段再加入動作資料,讓策略對應到機械人控制。這種做法避開先學視覺、再轉換成控制訊號時可能出現的落差。

實驗把經 DROID 訓練的策略直接放到實體 Franka FR3,沒有針對個別任務再微調。在三項任務共 15 次測試中,NAVA-WAM 平均成功率為 93.3%,DreamZero 為 66.7%,π0.5 為 53.3%;伺服器端每次 policy call 為 379.2 毫秒,按每次重新規劃實際執行的動作數計算,每個動作約 15.8 毫秒。

• 從 observation-only videos 直接學習 action policy
• 不依賴中間視覺表徵或獨立 latent-action model
• 在空間關係任務中,NAVA-WAM 成功 4/5 次,兩個基線均為 0/5
• 已在實體 Franka FR3 上測試,未作任務專屬微調

T1 要求把方塊放到碗的左側,基線模型雖能正確定位和抓取方塊,卻未能理解指令中的空間關係;NAVA-WAM 則較能將視覺互動經驗連接到具體控制行動。項目的限制是訓練仍需要第二階段的動作資料,並非完全脫離機械人示範,因此更適合用作擴充動作先驗,而不是取代所有實體機械人資料。

項目主頁

Categories: AI productions, 模型, 模型訓練, Video, World-Action Model, Robotic, Meta

ProAR 讓影片模型先想目標再生成

ProAR 把自回歸影片生成變成視覺推理流程,兼顧最終目標與中間步驟的合理性。

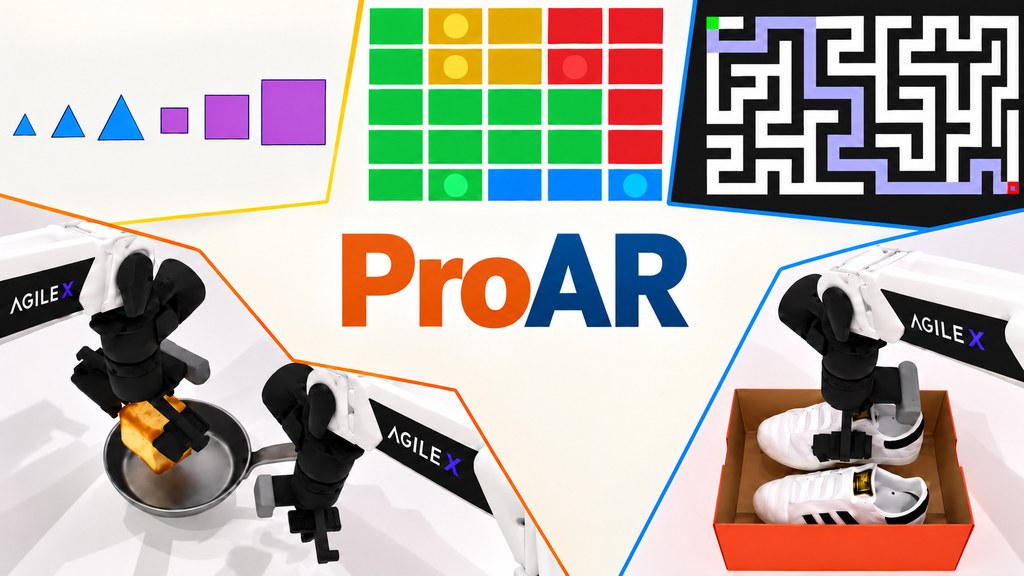
ProAR overview

當影片模型只按過去畫面逐步預測,畫面即使局部合理,也未必能完成指定任務。ProAR 屬於自回歸影片模型項目,透過 prospective reasoning 預測未來視覺狀態,處理長程目標與中間轉換容易失控的問題。

ProAR 以 Wan2.2-TI2V-5B 作為共享 backbone,加入兩條互補機制:outcome guidance 會一同預測未來 goal frame,讓目前 chunk 參考目標信念;transition guidance 則在訓練期間利用 predictor,令目前 hidden states 對齊乾淨的 next-chunk representation。前者偏向長距離規劃,後者補足短距離的狀態銜接。

• Outcome guidance 幫助生成結果符合任務目標
• Transition guidance 鼓勵中間步驟遵守時間及物理邏輯
• 推理時不需要真實未來畫面,訓練用 predictor 會移除
• 項目提供模型 checkpoint、ProAR-test 數據集及 VBVR-10Tasks 實驗配置

要測試項目,需要 Python 3.10、PyTorch 2.8.0,並把 Wan2.2-TI2V-5B 權重、VAE、T5 編碼器及 tokenizer 放到指定本地路徑;flash-attn 屬於可選的加速元件。這套流程較適合研究視覺推理、物理推演及 embodied intelligence 的團隊,未必是即裝即用的影片創作工具。

提供的資料確認了 AR 與 ProAR checkpoint,以及 VBVR-10Tasks 和測試數據集,但未列出足夠的數值結果,難以單憑儲存庫內容判斷提升幅度。推理時間會增加,換來模型在生成前預測目標及未來轉換;取捨是否合理,要視乎任務是否重視步驟有效性多於生成速度。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, AI productions, 模型, 模型訓練, 微軟, Video, 香港, 工具, Python, 庫, Dataset 數據集, Tokenize

HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

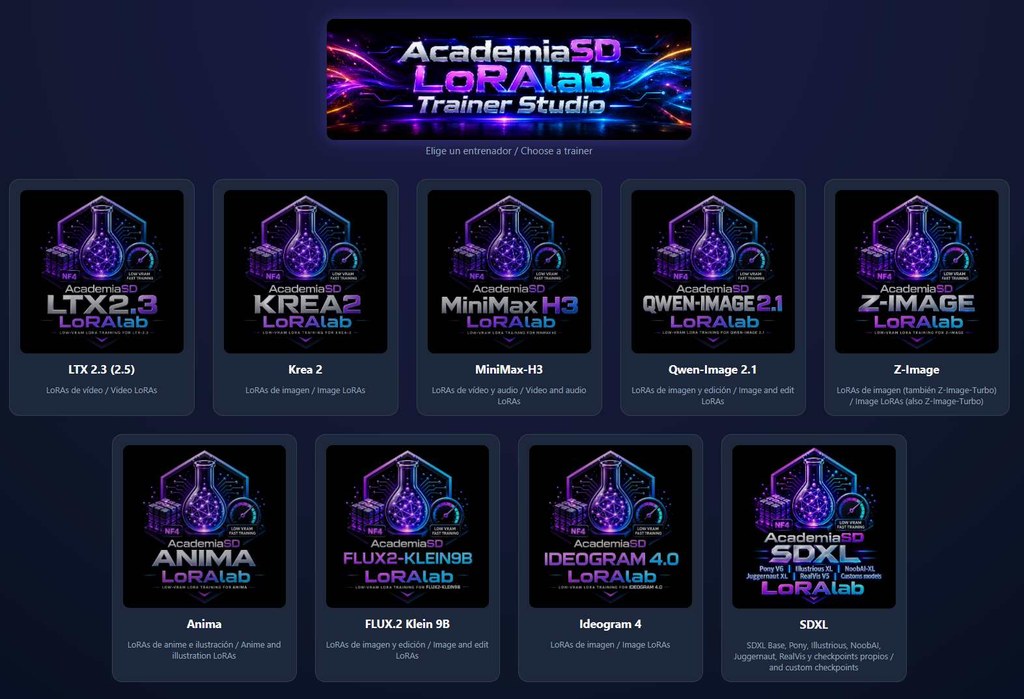
AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

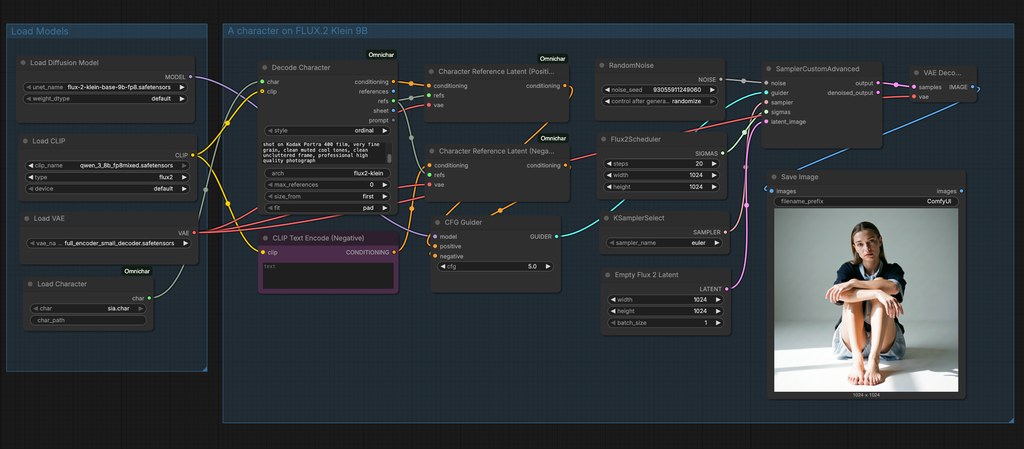
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

Awesome-Video-Generation-Post-Training:影片生成後訓練研究,一個持續更新的索引

影片生成模型的競爭已延伸到後訓練與對齊,這項目把論文、數據集及評測基準集中整理。

timeline

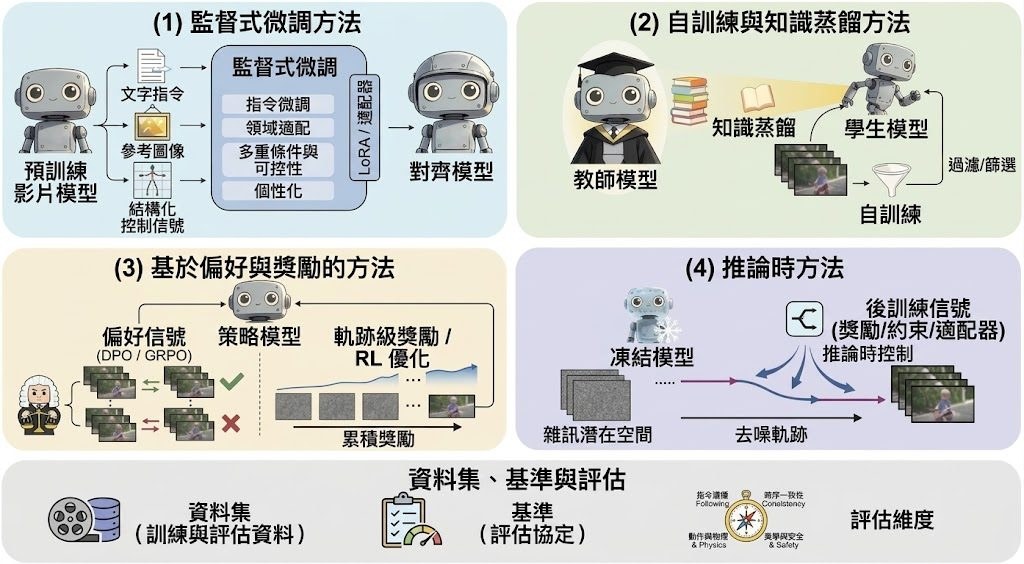
當影片生成模型由「能夠生成」走向「更符合指令、更穩定、更易評估」,研究者需要追蹤的不只是預訓練架構。Awesome-Video-Generation-Post-Training 是一個研究資料整理項目,集中收錄影片生成的 post-training、alignment、相關數據集及 evaluation benchmarks,亦配套一篇 Video Generation Models: A Survey of Post-Training and Alignment 綜述論文。

它不提供可直接執行的生成模型,主要在於縮短研究資料搜尋時間。你可按分類閱讀近期論文、對照不同後訓練方法,再沿着數據集與評測基準追查研究如何衡量影片品質、指令遵從及對齊效果;項目內容會持續更新,亦接受透過 pull request 補充論文、修正資料或建議分類。

  • 資料範圍:聚焦影片生成的 post-training 與 alignment 研究
  • 配套資源:整理相關 datasets 及 evaluation benchmarks
  • 閱讀方式:適合由綜述論文入門,再按分類深入原始研究
  • 參與方式:可提交 pull request,補充或修訂索引內容

對研究生、影片模型開發團隊及需要整理文獻的工程師而言,這項目比零散搜尋更方便建立研究地圖。它的限制亦很清楚:索引本身沒有統一跑分、推理介面或安裝後即可測試的模型,性能判斷仍要返回各篇論文查看實驗設定與指標。

GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 模型訓練, Video, World-Action Model, Dataset 數據集

Page 8 of 32
1 … 6 7 8 9 10 … 32