Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

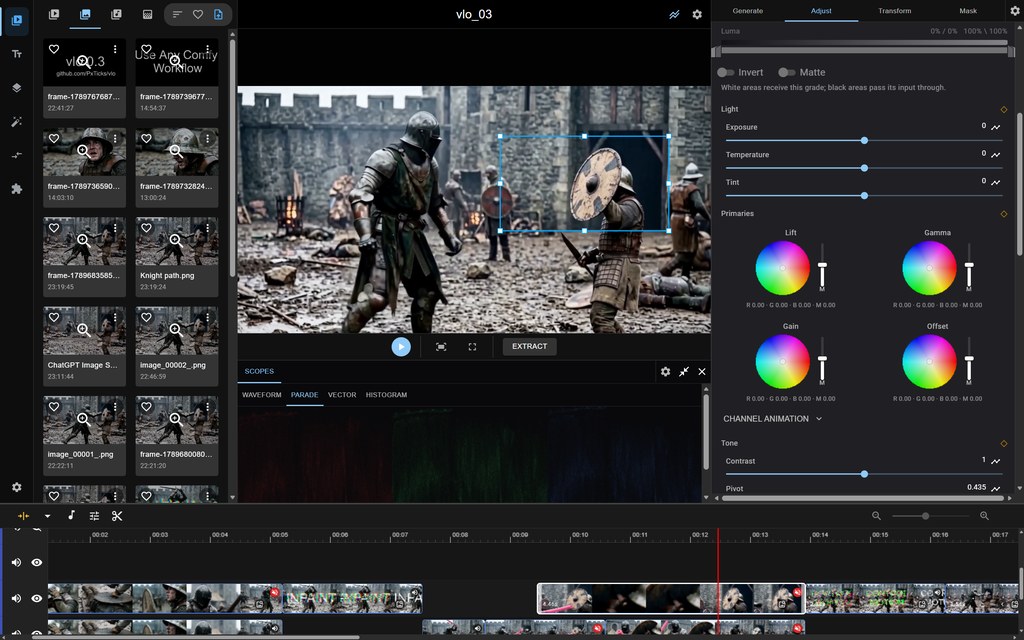
想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

4Director:3D 幾何精準控制影片世界模型

4Director 將鏡頭、物件與新加入的物件放進同一個 3D 空間,改善影片生成中動作失控和視角不一致的問題。

4Director

想令影片中的鏡頭、原有物件和新加入的物件按指定路徑移動,4Director 提供了一個較接近 3D 動畫製作的控制方式。它屬於影片世界模型,處理的是生成影片時深度、旋轉和跨視角一致性難以同時維持的問題。

系統會先為每件物件重建一個 canonical mesh,再以每幀一組 rigid transformation 推動物件,並把整個場景渲染成深度影片。Motion Adapter 之後將這份幾何骨架轉換成具備外觀、光照和非剛性動態的影片;新物件則可透過參考影像插入場景,並與鏡頭及原有物件共同控制。

相較只控制鏡頭、依賴 image-plane cues,或使用 3D tracks、blobs 的方法,完整網格能保留物件未被鏡頭看見的幾何,減少物件離開畫面後再出現時形狀和身份改變的情況。影片生成研究、視覺特效預演,以及需要精確安排物件運動的製作團隊較容易受益,但重建網格和建立剛性軌跡亦增加了準備工作。

  • RealCOD-Rigid 提供 20,774 段附有剛性 3D 場景標註的影片片段。
  • Identity-Gated IoU(IG-IoU)同時衡量物件動作是否跟隨指令,以及物件身份能否保持。
  • 實驗報告指 4Director 在畫質、鏡頭控制和物件控制方面優於多種先前方法。

4Director 目前更適合作為研究原型和可控影片生成的實驗基礎,而非即裝即用的剪片工具。理解其效果時,應同時檢查生成畫面的外觀品質、指定軌跡的遵循程度,以及物件離開後重新出現時的身份一致性。

項目主頁 · GitHub

Categories: 開源, AI productions, 世界模型, Video, 工具, 3D, 動畫

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

MiniMax H3 的雙用途 X2 Detail VAE 實驗

一個 VAE 同時處理影片 2 倍解碼與參考圖細節增強,但仍依賴指定 ComfyUI 節點。

Og image

由 MiniMaxAI/MiniMax-H3 作為 base model,呢個實驗型 video VAE 將兩條工作流程放入同一個模型:一條負責生成影片 latent 的 2 倍解碼,另一條則提升 image-reference 的空間細節,適合 ComfyUI 影片生成項目使用。

影片模式會以 MiniMax-H3-X2-Detail-v1.safetensors 解碼,再將 packed 12-channel 輸出交給 PixelShuffle ×2,產生 2 倍 RGB 影片幀。參考圖模式則透過 MiniMax H3 VAE 2X (Detailed Upscale) 節點,從 encoder 的 down.1.block.1 抽取額外 B32 空間細節;因此必須有現成 RGB 參考圖,並非只處理 latent。

檔案附有 ComfyUI 節點、workflow 及研究報告。影片解碼需要 ComfyUI-MiniMaxH3_LatentUpscaler 的 MiniMax H3 VAE Decode (fast),示範設定包括 tiling=true、tile_size=256、tile_overlap=64、output_device=cpu,以及 temporal_tiling=false;節點依賴令流程不能直接用標準 VAE Decode 取代。

  • 模型檔案:MiniMax-H3-X2-Detail-v1.safetensors
  • 定位:2X VAE Decode 加參考圖 Detail Enhancement
  • 已知取捨:B32 細節路徑只適用於 RGB 參考圖
  • 頁面未提供參數規模、上下文長度、GGUF、量化版本或 mmproj 檔案

項目作者將成果描述為一次未達預期的 HQ-VAE 實驗,但保留了可工作的 2-in-1 發布版本。適合作為實驗性 ComfyUI 工具,而非已完成全面效能驗證的通用 VAE。

模型

Categories: 開源, ComfyUI, AI productions, 模型, Video, MiniMax

Physis-Lang 讓影片模型理解物理因果

影片畫面看似合理,動態卻可能違反物理規律。Physis-Lang 以可演化的物理語言,改善影片資料整理、訓練與生成。

Physis

當影片模型能生成融化中的牛油,卻未必理解升溫、重力與形變之間的關係,Physis-Lang 便嘗試補上這個落差。這個由 NVIDIA、MIT 與 University of Oxford 研究團隊提出的 Video World Model 研究項目,把物理因果、相互作用、支配原理與結果寫進共享語言表示,協助模型生成更合理的世界演化過程。

Physis-Lang 不只描述畫面發生了甚麼,還要求字幕交代事情為何發生。例如牛油融化的描述會進一步指出升高的溫度提供熱力,熱力促成融化,而重力令牛油向下塌成淺層液體。物理概念會經由 Physics-aware critic 找出遺漏或缺乏視覺證據的說法,再由 agent 修訂共同的 captioning guidelines,captioner 本身則維持不變。

整套方法連接資料整理、模型訓練與推理:模型失敗會轉化成物理領域查詢,再透過 language-guided retrieval 找出能補足缺口、而且視覺內容多樣的影片;演化後的語言會重新製作訓練字幕,並擴展 inference prompts,同時加入針對場景的 negative descriptions,減少不合理動態。

  • PhysCapBench 收錄 246 段經審核的物理影片及 3,794 個人工驗證 assertions
  • 評估字幕對物理細節的 precision、recall 與 F1
  • Physis-Lang · Cosmos3-Super 在 Physics-IQ 公開排行榜列第一,平均分數為 48.2 ± 1.4
  • Physis-Lang · Cosmos3-Nano 列第二,平均分數為 43.3 ± 1.5

這項研究適合關注 Video World Models、物理推理和影片生成可靠性的讀者。排行榜結果顯示,加入可演化的物理語言後,Cosmos3 系列模型在相關評測中取得進展,但分數只反映指定基準,並不代表所有影片場景都能避免物理錯誤。

項目主頁

Categories: Agentic, 世界模型, 模型訓練, NVIDIA, Video, 框架

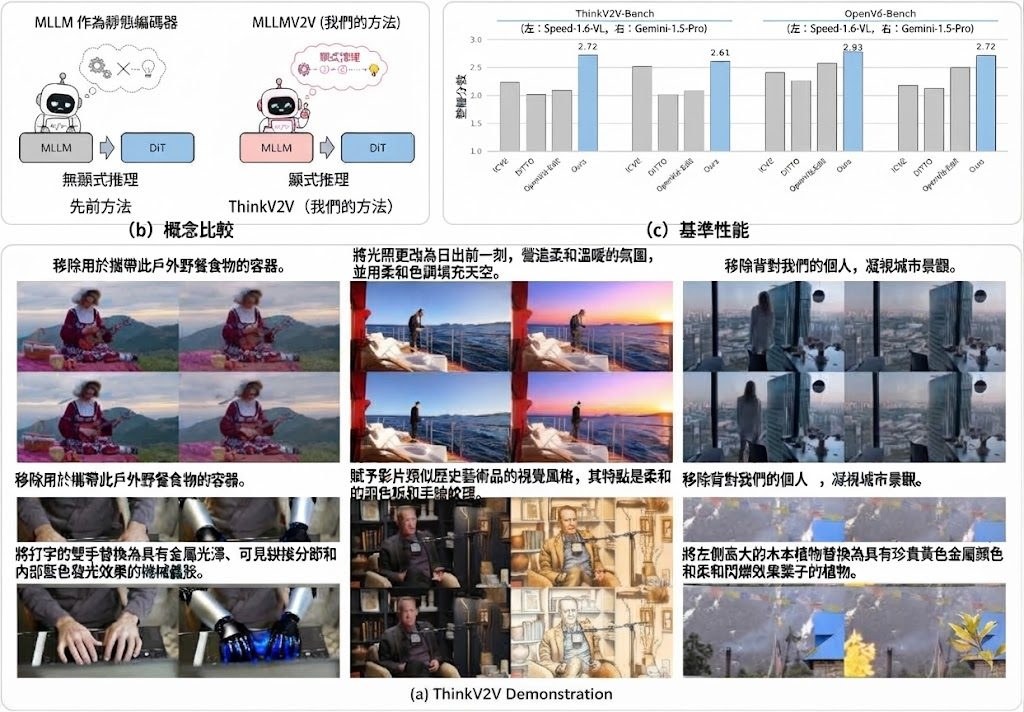
ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

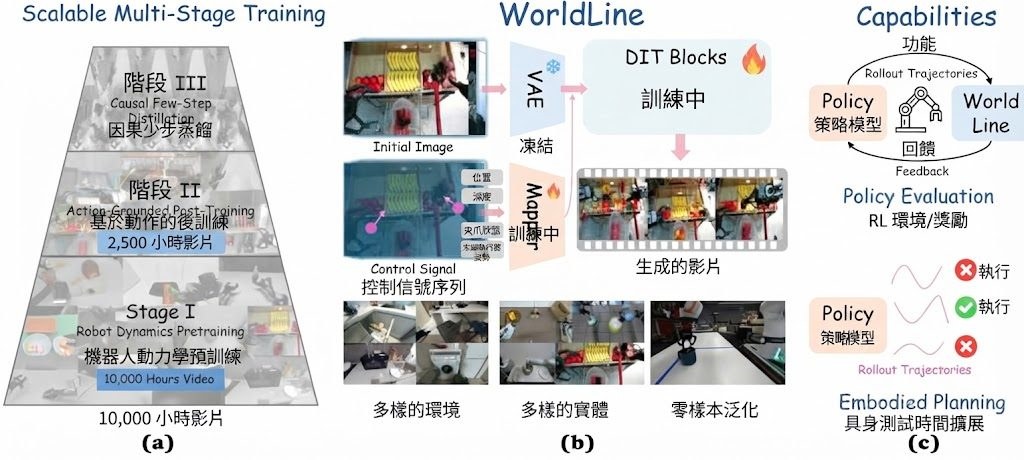
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

ComfyUI-MiniMaxH3Mod:可重用參考模組

你可以把它理解成 MiniMax H3 的參考素材管理層,把圖像、影片和聲音整理成可重用的 RefMod。

ko-fi

想在 ComfyUI 的 MiniMax H3 工作流中重用同一組人物、場景或聲音參考,不必每次重新編碼原素材。ComfyUI-MiniMaxH3Mod 是一個開源 custom node 項目,處理 RefMod 的建立、儲存、載入、組合及套用,讓圖像、影片和音訊參考可以保存成 .safetensors,再交給 Apply H3 RefMod 使用。它不會訓練 H3 權重,也不是 LoRA 或監督式概念學習工具,而是接入 H3 原生 reference-token 路徑的儲存與選擇層。

使用時需要將項目放入 custom_nodes 後重新啟動,並把標準 H3 video VAE、audio VAE 及原生 CONDITIONING 接到相應節點。項目已提供 Create H3 RefMod、Create H3 RefMod Master、Load H3 RefMods、Apply H3 RefMod 等節點;Master 可以一次處理視覺和音訊,save=False 則可只產生記憶體中的 bundle,不寫入檔案。ComfyUI Manager 可處理 safetensors、numpy 和 Pillow 等 Python 依賴,影片資料夾載入則可按需要加入 opencv-python 或 imageio。

  • 支援圖像、影片、音訊 RefMod,並可在同一個 .safetensors bundle 儲存視覺與聲音。
  • encode 保留較多細節但消耗更多 reference tokens;training 先壓縮 latent,降低 token 成本,亦可能損失細節和動態。
  • Collect H3 RefMod Masks 可處理不同尺寸的 MASK,並按對應參考素材保留尺寸;上游裁走的像素則無法恢復。
  • Full Reference video sampling 會先決定因果 frame 數,避免 16 等限制直接截掉影片尾段。
  • Loader 和 Axis 採用按需增加的參考槽位,並可分開選擇 All、Visual 或 Audio。

它和單純把素材放在工作流內的做法不同,RefMod 會把編碼結果保存下來,之後重用時可避免重複處理來源檔案。壓縮模式適合控制 token 和生成成本,完整 encode 則較適合作為身份或細節比較的基線;兩者都不能保證只轉移指定屬性,身份、服裝、背景和構圖仍可能互相混合。項目支援最多八個參考槽位、子資料夾、外置磁碟及 extra_model_paths.yaml 登記的 RefMod 根目錄,Library 和 Config 亦能搜尋及檢視已保存內容。

可調整的 max_tokens、frame limit、視覺 budget policy 和 Refinement Steps,令項目較適合需要反覆測試參考組合的創作者、ComfyUI 工作流作者,以及要管理大量人物或場景素材的團隊。truncate 會削減畫面內容以符合 token 預算,error 則在超出預算時停止保存;這些選擇直接影響細節保留和工作流是否繼續。項目目前沒有提供可與原生完整 reference workflow 對齊的正式基準測試,Windows 是原先測試環境,Apple Silicon 只覆蓋部分預處理和 H3 VAE 檢查。

音訊支援仍是最大限制。項目可以保存及混合視覺、音訊參考,亦曾成功處理音樂參考,但目前測試未能完成 speaker-identity transfer,因此不能當作已驗證的 voice cloning 解決方案;它亦不會自動修正影音同步。API 和 node schema 仍在演變,節點名稱及輸入欄位可能隨版本調整,適合接受工作流需要維護、並願意自行測試參考強度與 token 取捨的使用者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型訓練, API, Video, Image, 影像處理, Audio, 工具, Content Creator, Clone, 庫, 語音, 音樂, 蘋果, MiniMax, LoRA

Page 9 of 32
1 … 7 8 9 10 11 … 32