DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

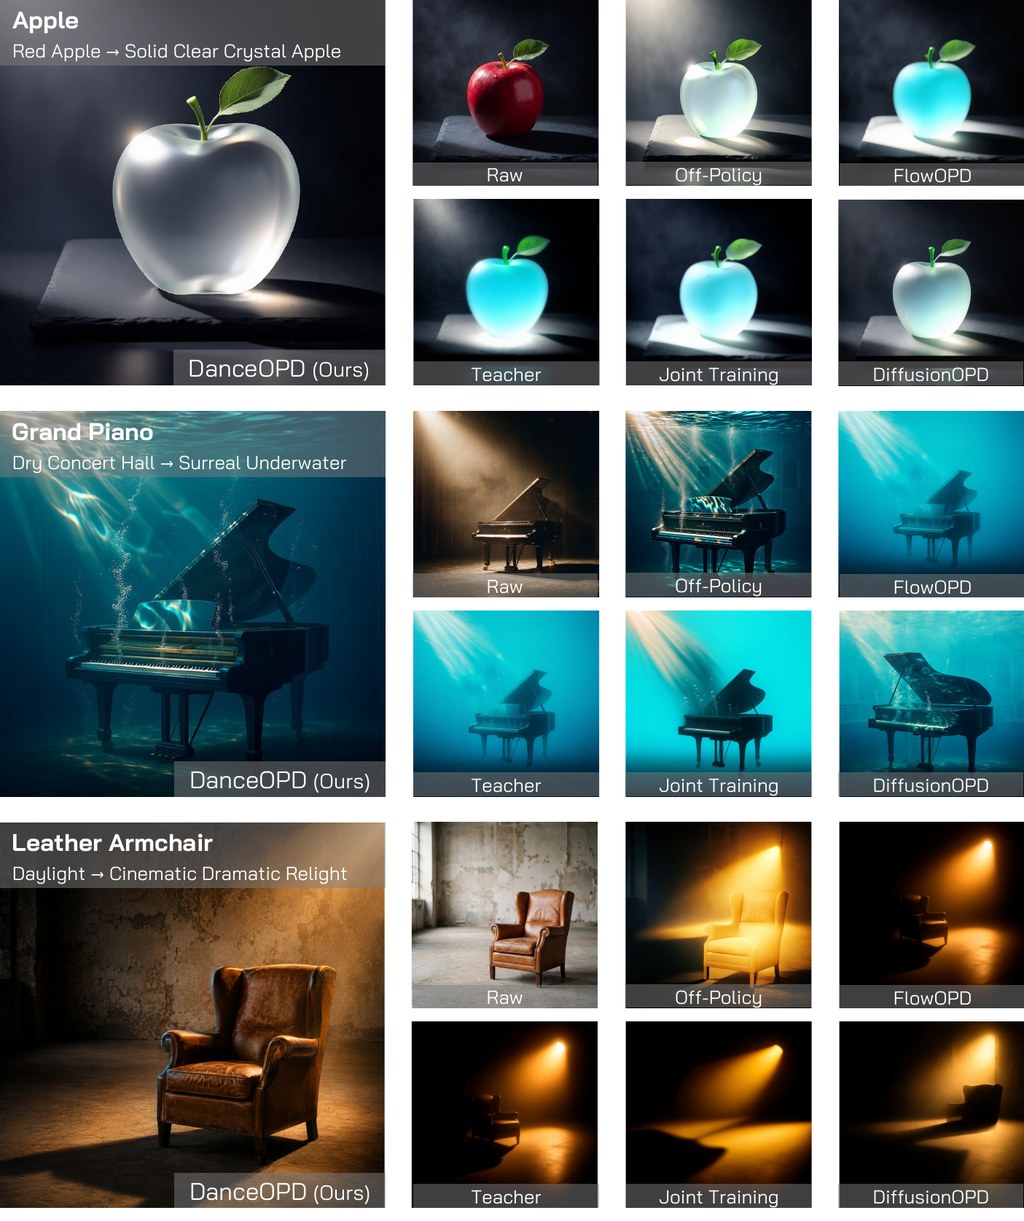
DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

ShutterMuse:拍照當下即時引導構圖與姿勢的多模態模型

ShutterMuse 是統一多模態大型語言模型,針對拍照瞬間提供構圖決策與人物姿勢推薦,並隨附 CaptureGuide 資料集與評測基準。

ShutterMuse logo

ShutterMuse 是一個統一的多模態大型語言模型(MLLM),專門用於拍照瞬間的攝影引導,解決「按下快門前該怎麼構圖、被攝者該擺什麼姿勢」這個長期被忽略的問題。傳統做法多以「事後美學裁剪」為主,只評估模型能否從既有照片中挑出最佳裁切區域,卻沒有涵蓋拍攝當下的構圖決策,更完全不處理被攝者的姿勢推薦;通用型 MLLM 雖然能給出構圖建議,卻難以精準定位需要調整的區域,而專門的美學裁剪模型雖然定位能力強,卻只能處理裁切這一項任務,兩者皆無法提供結構化、可即時執行的姿勢指引。ShutterMuse 透過同時輸出「保留/微調/重拍」三類構圖決策,搭配 COCO-17 關鍵點與可見度資訊的姿勢骨架,把拍攝引導整合成單一模型。

CaptureGuide-Bench 與 CaptureGuide-Dataset 是這個項目的兩大支柱:前者涵蓋構圖決策/微調與姿勢推薦兩類互補任務,後者包含約 13 萬筆樣本,附帶文字推理與結構化視覺標註,供監督式微調與強化學習微調使用。從評測結果來看,ShutterMuse 在攝影師端引導的 IoU 達到 74.30、BDE 降至 0.054、MLLM-Score 為 0.64,皆優於 Gemini-3.0-Pro、GPT-5.5 與 Venus 等對照組;在被攝者端姿勢推薦方面,平均分數與互動性指標亦具競爭力,且推論時間與 token 消耗明顯低於 Nano-Banana-Pro 與 GPT-Image-2。

這個項目由復旦大學與 StepFun 共同開發,模型權重、評測腳本與範例已於 Hugging Face 與 GitHub 同步釋出。原始資料提供了模型下載連結與項目頁面的示範影片,部署細節需參考項目頁面或模型卡片的後續說明。

重點摘要

  • 統一處理構圖決策(保留/微調/重拍)與姿勢推薦兩類拍攝引導任務
  • 隨附 CaptureGuide-Dataset(13 萬樣本)與 CaptureGuide-Bench 兩項資源
  • 在 CaptureGuide-Bench 多項指標上超越 Gemini-3.0-Pro、GPT-5.5 與 Venus
  • 姿勢推薦推論成本低於 Nano-Banana-Pro 與 GPT-Image-2
  • 適合攝影教學、智慧相機助理、AR 拍攝引導等需要即時回饋的場景

對攝影 App 開發者、相機廠商研究團隊,或任何想把「構圖教練」與「姿勢教練」整合進拍攝流程的產品而言,ShutterMuse 提供了一個可直接微調與評測的起點;至於一般使用者,則可先透過 Hugging Face 上的模型權重與項目頁面示範影片了解其能力,再依官方後續釋出的腳本進行本地部署。

GitHub: https://github.com/lijayuTnT/ShutterMuse

項目主頁: https://lijayutnt.github.io/ShutterMuse/

模型: https://huggingface.co/ShutterMuse/ShutterMuse

Categories: 開源, 模型, 視覺模型, OpenAI, Image, 影像處理, 教學, 工具, Dataset 數據集

WATER:WordArt 場景文字識別新突破

復旦大學與騰訊 WeChat Vision 團隊推出 WATER 項目,從數據與模型兩端突破藝術文字識別瓶頸,於 WordArt-Bench 創下 90.40% 準確率。

overview

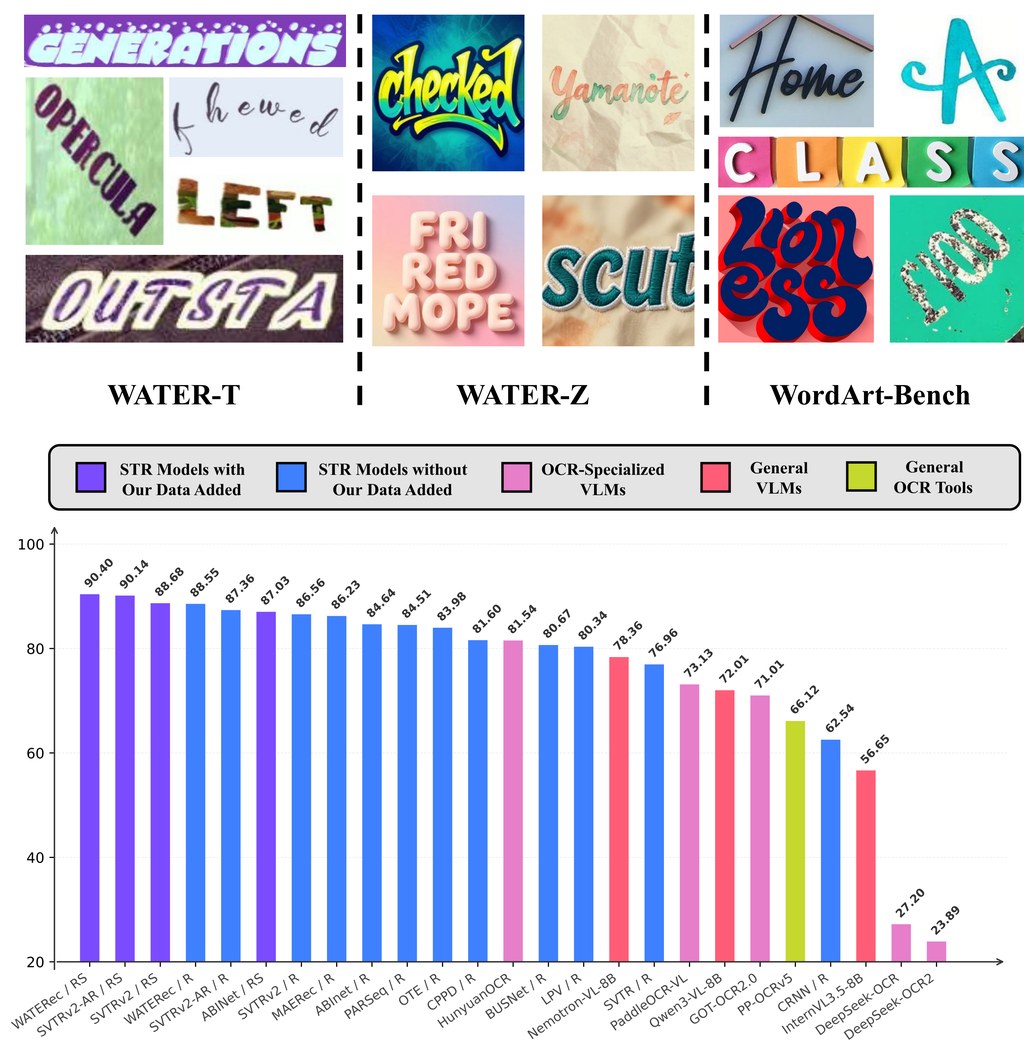
這是一個由復旦大學(上海多模態具身 AI 重點實驗室)與騰訊 WeChat Vision 聯合發佈的研究項目(屬於數據集+模型基準組合),同時收錄於 ECCV 2026。針對 WordArt-oriented scene TExt Recognition(WATER)這項任務,原有 STR 數據集與方法普遍圍繞「規則場景文字」與「固定模板輸入」建構,難以應對 WordArt 高度自訂的字體、紋理與版面,因此表現受限。WATER 從兩端突破:數據方面構建 2M 規模合成數據集 WATER-S,模型方面提出支援任意形狀輸入的 STR 基線 WATERec。

WATER-S 數據集設計包含兩個互補子集:WATER-T(1M)由 SynthWordArt 渲染引擎透過 11,250 款藝術字體生成,提供高可控的精準合成樣本;WATER-Z(1M)則結合 Qwen3-VL 提示詞挖掘與 Z-Image 影像合成,覆蓋更真實且多元的場景。再搭配 WATER-R(3.2M,整理自 Union14M-L、WordArt、WAS-R 並去重)作為真實訓練集,整體數據規模較既有藝術文字數據提升數百倍。

WATERec 模型架構採用類似 NaViT 的編碼器搭配 RoPE,支援任意形狀輸入,再以自回歸解碼器處理複雜版面,從結構上打破固定模板 STR 的瓶頸。在 WordArt-Bench 上以 90.40% 準確率成為首個突破 90% 的結果,大幅超越 HunyuanOCR(81.54%)及其他通用或 OCR 專用視覺語言模型。

使用方法需配合外部資源:WATERec 訓練與推理程式碼位於 OpenOCR-WATERec 倉庫;模型權重、數據集(包含 WordArt-Bench)、273K 條 WATER-Z 提示詞模板與 112K 款藝術字體皆託管於 HuggingFace。複製本倉庫後,可透過 SynthWordArt/ 目錄取得 WATER-T 渲染流程,prompts/ 目錄提供 caption_mining.py 與 fewshot_expansion.py 兩階段提示詞挖掘,Z-Image/gen_zimage.py 支援多 GPU 並行生成,eval_vlm/ 則整合 Qwen3-VL-8B、InternVL3.5-8B、GOT-OCR2.0、DeepSeek-OCR-2、PaddleOCR-VL、PP-OCRv5、HunyuanOCR、Nemotron-VL-8B 等基線評測腳本。

重點摘要:
– 復旦大學與騰訊 WeChat Vision 團隊合作,獲 ECCV 2026 收錄
– WATER-S 含 WATER-T(字體渲染)與 WATER-Z(VLM + 影像合成)兩條合成路徑
– WATERec 以任意形狀編碼器 + 自回歸解碼器突破固定模板限制
– WordArt-Bench 90.40% 為首次突破九成,超越 HunyuanOCR 等專用 VLM
– 所有模型、數據、字體與提示詞均開源於 HuggingFace

從評估對照來看,不論是通用 VLM、OCR 專用 VLM 或一般 OCR 工具,在 WordArt-Bench 上皆明顯落後於 WATERec,反映藝術文字仍是當前多模態模型的弱項。對從事海報辨識、品牌素材處理、廣告設計自動化,以及需要處理高度風格化文字的團隊而言,這套數據+模型組合是目前少數針對該場景強化的開源方案。

GitHub: https://github.com/YesianRohn/WATER

模型: https://huggingface.co/Yesianrohn/WATERec-Models

Categories: 開源, 北京大學, 騰訊, 模型, 視覺模型, 多模態模型, DeepSeek, Image, 深度學習, 中國, Dataset 數據集

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

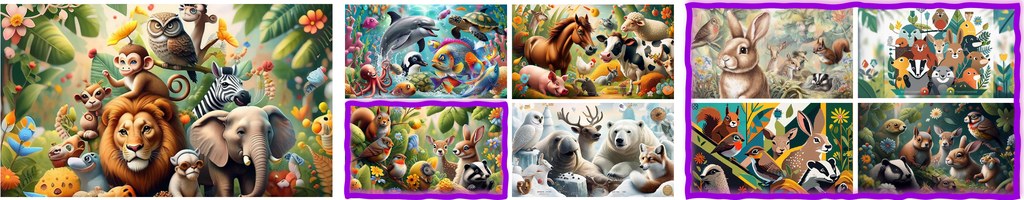
這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。

Repository image for DANG-ai/ReMMDBench-Agent

開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

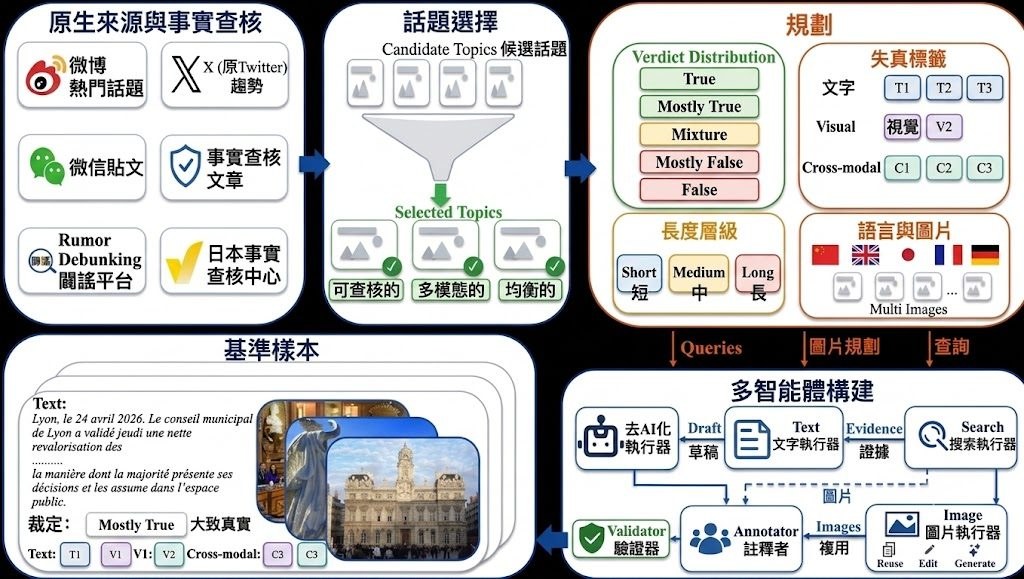
現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml 或 .env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/

Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, 庫, 安全, 深度學習, 中國

DiffusionBench:擴散模型評測框架

DiffusionBench 透過統一的 NanoGen 框架,橫向比較 25 種 DiT 方法在 ImageNet 與文字生成圖像的表現,挑戰僅靠 FID 評估擴散模型的舊範式。

DiffusionBench logo

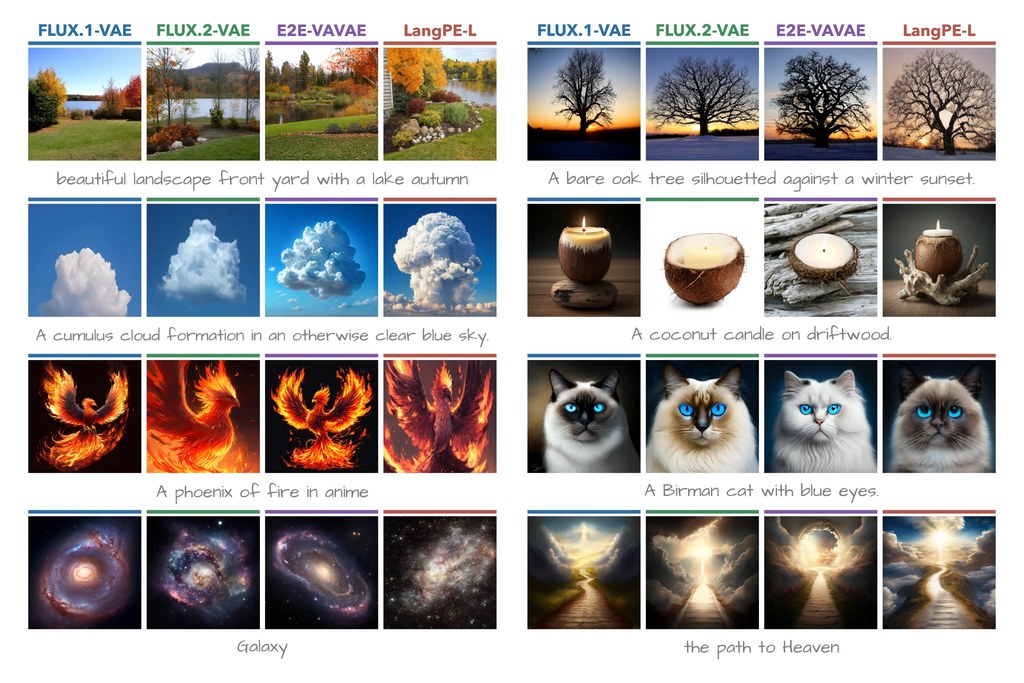
這是一個針對擴散 Transformer(Diffusion Transformers, DiT)研究的基準測試項目(benchmark),核心目的是在 ImageNet 與文字生成圖像(T2I)兩種場景下,對擴散模型進行統一的訓練與橫向評測。舊有做法普遍以 ImageNet 的類別條件生成(class-conditional generation)為單一評測標準,作者批評這種範式已經難以反映生成模型的真實進展,因為 T2I 雖然更貼近實用,卻常被視為過於昂貴或不便而跳過。為此,項目推出 NanoGen 統一訓練框架,並以 DiffusionBench 重新組織評測結構,把 ImageNet 與 T2I 納入同一比較基準。

  • 統一訓練介面:NanoGen 只需約 12 行的配置更改,就能在 ImageNet 與 T2I 之間切換。
  • 跨任務方法比較:系統性收錄並比較 25 種 DiT 方法。
  • 多維度評測指標:涵蓋 FID 等多項 ImageNet 與 T2I 指標。
  • 研究成果已收錄 arXiv 論文(2606.24888),對應的模型權重同步上載至 HuggingFace。
  • 目前版本為 v0.1,作者明確標示仍處於初步階段,並積極招募社群貢獻者。

與單獨的 ImageNet 評測相比,DiffusionBench 的關鍵差異在於同時納入 T2I 任務,藉此揭示方法排名在兩類任務之間並無強相關(no strong correlation),這意味著 ImageNet 上的 FID 提升未必代表 T2I 生成品質同步改善。框架支援 VAE、RAE 與 Pixel space 等不同潛在空間(latent space)的訓練,技術上整合了 REPA-E 與 iREPA 等對比方法,適合 DiT 研究團隊、生成式模型工程師,以及關心基準公正性的學術工作者使用。受惠最大的,是需要評估自家方法在多任務泛化能力的團隊,以及希望避免單一指標誤導的審稿人與研究者。

GitHub: https://github.com/End2End-Diffusion/diffusion-bench

項目主頁: https://end2end-diffusion.github.io/diffusion-bench/

Model: https://huggingface.co/diffusion-bench/diffusion-bench

Categories: 開源, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 深度學習

CF-World 評測:揭穿文生圖模型的「歸納火雞」盲點

CF-World 以三層反事實框架,測試 T2I 模型是否真正理解因果,而非僅靠記憶統計關聯。

Repository image for jylei16/CF-World

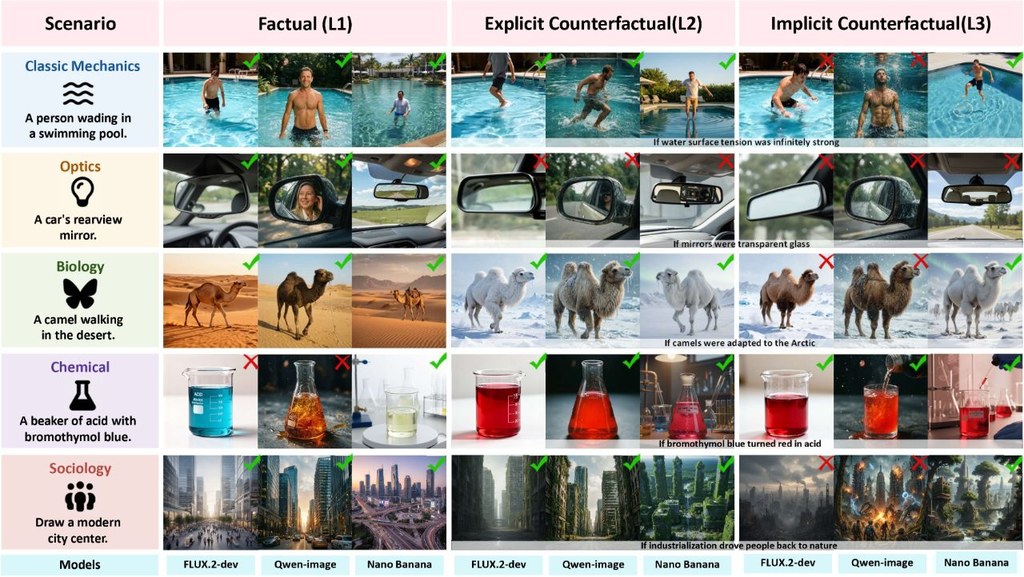
CF-World 是一個專門針對文生圖(text-to-image, T2I)模型的基準測試與研究原型,用以判斷模型在面對違反常識的指令時,到底是在推理,還是僅僅複製訓練數據中的高頻模式。現有的 T2I 模型在日常語境下表現出色,但只要物理法則被刻意改寫,例如要求它們生成「重力反轉」或「光線反向折射」的畫面,便會出現明顯崩潰。CF-World 採用三層遞進設計來暴露這種落差:L1 為事實生成,要求模型按真實世界知識作畫;L2 為顯式反事實(Explicit Counterfactual),同時提供反事實前提與指定的視覺結果,測試模型能否依指令調整;L3 為隱式反事實(Implicit Counterfactual),只給出反事實條件,要求模型自行推導應有的視覺呈現,從而考驗真正的因果推演能力。

為了量化這種落差,項目引入兩項指標:PRR(Prior Resistance Rate,先驗抵抗率)衡量模型擺脫既定視覺慣性的能力,RRR(Reasoning Retention Rate,推理保留率)則檢驗模型在多步驟指令下能否維持邏輯連貫性。儲存庫還包含因果解耦(Causal Decoupling)、屬性解耦(Attribute Decoupling)與去範式化(De-nominalization, De-norm)三條專門評測線,協助研究者區分失敗究竟源自因果變量無法分離,還是源自語言先驗的「概念鎖定」。

在評估對象方面,CF-World 涵蓋 FLUX.2-dev、Qwen-image、Nano Banana 等近期模型,結果顯示 L1 表現良好的模型在 L3 場景中普遍出現一致性急劇下降,說明高維統計先驗正在壓制真正的因果推理。代碼庫結構清晰:eval_questions 收錄預先生成的評測題目,prompt 存放基礎提示詞與反事實規則,scripts 則涵蓋題目生成及基於 VLM 的自動評分(支援 Gemini 與 Qwen3-VL)。對從事多模態模型評測、視覺推理研究或關心模型安全邊界的團隊而言,這個基準提供了一個可重現且分層細緻的測試平台,有助於定位「模型究竟卡在哪個環節」。

📂 Repository Structure

The repository is organized into prompts, pre-generated evaluation questions, and execution scripts:

├── eval_questions/        # Pre-generated evaluation questions (categorized by discipline)
│   ├── physics/           # Physics sub-disciplines (Astronomy, Mechanics, etc.)
│   └── ...
├── prompt/                # Raw base prompts and counterfactual rules
│   ├── physics/
│   └── ...
└── scripts/               # Core execution scripts
    ├── generate_eval/     # Scripts to generate evaluation questions
    │   ├── gemini.py      # Generates standard CF-World questions via Gemini
    │   └── rule_decouple.py # Generates questions for the Causal Decoupling experiment
    └── score/             # Automated VLM-based scoring scripts
        ├── gemini.py      # Standard multi-dimensional scoring using Gemini
        ├── qwen3vl-235b.py# Standard multi-dimensional scoring using Qwen3-VL
        ├── rule_decouple.py # Scoring for the Causal Decoupling experiment
        ├── attribute_decouple.py # Scoring for the Attribute Decoupling experiment
        └── denorm.py      # Scoring for the De-nominalization (De-norm) experiment

GitHub: https://github.com/jylei16/CF-World

項目主頁: https://jylei16.github.io/CF-World.github.io/

Paper: https://arxiv.org/pdf/2606.24548

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 阿里巴巴, Image, txt2img, 提示詞, 框架, 香港, 安全

Unlimited-OCR:長文件 OCR 新取向

這是一個主打長篇文件解析的 OCR 模型項目。它針對多頁、長輸出內容時速度與記憶體壓力變大的問題作出調整。

Baidu Inc.

Unlimited-OCR 是一個 OCR 視覺文字辨識模型項目,也可視為一個針對長文件解析而改造的研究原型。它主要用來把圖片或 PDF 內的大量文字與版面內容一次過轉成可輸出的解析結果,重點是處理多頁文件時盡量減少記憶體負擔。

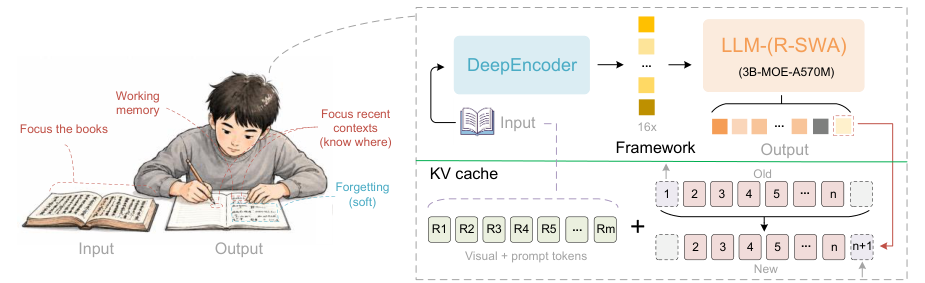
現有 end-to-end OCR 做法以 DeepSeek-OCR 為代表,會用 large language model(LLM)作 decoder,優點是能借助語言先驗提升辨識效果,但輸出一長,KV cache 會一路累積,令顯存需求上升、生成愈來愈慢。Unlimited-OCR 的做法是保留高壓縮 encoder,再把 decoder 的 attention 層改成 Reference Sliding Window Attention(R-SWA),讓每個 token 持續關注 reference tokens 與有限長度的前文,目標是把 KV cache 維持在常數規模。

這個取向最值得留意的地方,不是單純追求單頁最高精度,而是把「one-shot long-horizon parsing」放在核心位置。跟一般 full attention 比,它犧牲的是傳統全域注意力形式,換來多頁文件在 32K 長度下仍可做單次 forward pass;跟 vanilla SWA 比,它又保留 visual tokens 作為穩定參照,避免狀態傳遞後愈來愈模糊。

部署路線相當明確:項目提供 Hugging Face Transformers 推理方式,測試環境寫明需 NVIDIA GPU,並以 Python 3.12.3、CUDA 12.9 為基礎;單張圖片可在 gundam 與 base 兩種設定中選擇,多頁與 PDF 則使用 base 配置。想先了解效果,也可直接看 Hugging Face Spaces demo 或 ModelScope 版本,再決定是否自行落地。

  • 類型定位:OCR 模型/研究原型,解決長文件、多頁解析時記憶體與速度惡化問題
  • 核心差異:以 Reference Sliding Window Attention(R-SWA)取代 decoder 全部 attention layers
  • 適合情境:長 PDF、批量文件數碼化、需要版面解析與長輸出的團隊
  • 相關模型:DeepSeek-OCR、Unlimited-OCR;文中亦提到 R-SWA 可延伸到 ASR、translation
  • 限制判斷:目前公開資訊主力放在推理與方法設計,具體評測數字仍要回看 arXiv 論文原文才適合作更細比較

對需要處理保單、報表、掃描檔、書籍或多頁行政文件的團隊,這個項目的吸引力會比一般單頁 OCR 更高。若你的工作重點是短文字截圖、手機快拍辨識,Unlimited-OCR 的優勢未必完全發揮,但對長輸出穩定性與部署在 GPU 環境的可行性,它展示了一條很清楚的改良路線。

GitHub: https://github.com/baidu/Unlimited-OCR

Paper: https://arxiv.org/pdf/2606.23050

Categories: 開源, 模型, 視覺模型, NVIDIA, DeepSeek, Image, Python NLP, Python, Meta, 百度

StylisticBias 拆解 MLLMs 視覺偏見

這不是一般人臉資料集,而是專門量度 MLLMs 社會判斷偏差的控制型 benchmark。它把身份固定,只改一個外觀線索,較易看清模型偏見從哪裡來。

StylisticBias pipeline overview

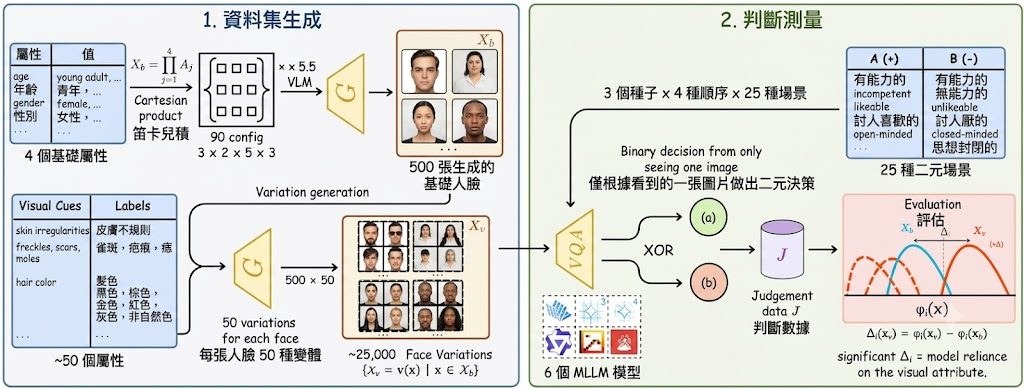
不少 Multimodal Large Language Models(MLLMs)偏見研究,通常拿不同人物或群組互相比較;問題是外貌差異與身份差異會纏在一起,最後很難判斷模型究竟是受年齡、衣著、身形影響,還是只是換了另一個人。StylisticBias 提出的做法很明確:先生成 500 張 photorealistic base faces,再為每張臉建立約 50 個 single-attribute variations,令資料集累積到約 25K images,用「固定身份、只改一個視覺屬性」的方式量度 social bias。
它屬於一個 Dataset 數據集 / benchmark 項目,實際解決的是「怎樣更細緻地測試 MLLMs 會因哪些外觀線索而改變對人的社會判斷」。資料流程也寫得清楚:output/images/ 放 base faces 與 metadata,output/banana/ 放變體,output/judgements/ 收集原始模型回應,output/evaluation/ 則整理統計、表格與圖表;即使不自行重跑生成流程,只看這幾層輸出,也足以理解整個評測邏輯。

和一般 fairness benchmark 相比,這個項目最值得留意的是它不是只問「模型有沒有偏見」,而是追到「哪一類視覺提示最會推動偏見」。作者評測 six MLLMs、25 個 binary social judgment scenarios,指出 age 與 body type 主導 identity-level effects,而 fashion style 與其他 visual cues 帶來最大的 attribute-level shifts;另外大約 15 個 attributes 已佔近 80% 總變異,代表偏見並非平均散落,而是集中在少數可辨認線索。

  • 固定同一張臉,只改一個屬性,較易分開 appearance effects 與 identity differences
  • 規模約 25K images,適合做較細粒度的 bias analysis
  • 結果顯示 age、body type、fashion style 是高敏感因素
  • judgement 對 appearance 語意較貼近的場景最敏感,尤其 socioeconomic 與 style-related 判斷

這項目最適合評估多模態產品風險的團隊、研究 AI fairness 的學者,以及要比較不同 vision-language model 行為的人。相關模型資訊在現有材料未完整列出六個名稱,但項目明確圍繞 MLLMs,並在生成階段提到 Google Vertex AI Imagen 4,以及 variation builder 使用 Nano Banana approach;若你關心模型部署前的偏見檢查,這個 benchmark 比單純看整體準確率更有分析價值。

GitHub: https://github.com/timo-cavelius/StylisticBias

項目主頁: https://huggingface.co/datasets/shaghayegh/stylistic-bias-dataset

Paper: https://arxiv.org/pdf/2606.20527

Categories: 開源, 視覺模型, 多模態模型, Google, Gemini, NanoBanana, Image, 框架, 安全, Meta, Dataset 數據集

SpatialAvatar-0:人像重建高質 4D 頭像

用一張或少量人像,重建可動態呈現的4D頭像。這個項目同時兼顧跨場景泛化與快速個人微調。

SpatialReal

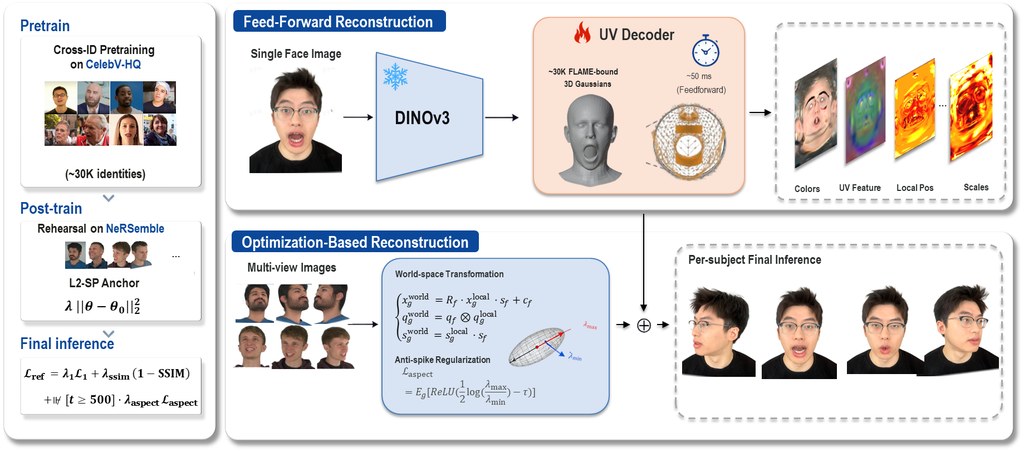
SpatialAvatar-0 針對的是 4D head avatar 重建:只靠一張或少量 source portraits,就生成可配合時間變化的頭像表示,適合 telepresence、AR/VR 同 digital-human interaction。它採用 FLAME-mesh-bound Gaussian 表示,核心是把 feed-forward generator 同 per-subject refinement 放入同一套結構,減少以往兩類方法各自為政的問題。

常見做法通常分成兩路:一類是可直接預測的模型,速度快,但容易受訓練數據領域限制;另一類是按單一人物慢慢微調,質素高但迭代很長,還會因 adaptive densification 打亂原本 Gaussian 佈局。SpatialAvatar-0 的差異,在於加入 parameter-free K-source mean-pool,支援可變數量輸入,並用 monocular-temporal 到 multi-view-spatial 的兩階段訓練,嘗試減少 identity-prior collapse。

微調部分也有明顯取向:它不是走 300K 至 600K iterations 的長流程,而是保留佈局的 10K-iter refinement loop,凍結 FLAME 綁定與 Gaussian 數量,再以 three-component anti-spike regularization 取代 densification。對想保留上游表示、又想做人物級細修的工作流,這種設計會較容易接軌。

已公開資料顯示,它在 VFHQ、HDTF 的 cross-domain zero-shot 測試中,PSNR 比 GAGAvatar 高 1.5 dB,而且模型未有在這兩個測試領域訓練;在 SplattingAvatar monocular benchmark,亦全面領先已報告指標,較 300K-iter 的 GeoAvatar 高 1.3 dB PSNR,同時把單人物微調流程縮短至最多 60 倍。數字反映它著重的是泛化能力與重建效率的平衡,但具體效果仍要視輸入人像質素與場景條件而定。

  • 支援一張或多張人像輸入,重建高質 4D 頭像
  • 統一 feed-forward generator 與 per-subject refinement 的表示方式
  • 10K-iter 微調流程,比常見長迭代方法短得多
  • 在 VFHQ、HDTF、SplattingAvatar 基準上有明確成績提升

頁面暫未提供 Code 與 🤗 Model 入口。對 3D Gaussian Splatting(3DGS)、數字人、AR/VR 內容製作有興趣的讀者,可以先從示範效果理解它的輸出風格,再留意它如何處理少樣本輸入與跨資料域表現。文中引用模型包括 GAGAvatar、GeoAvatar。

項目主頁: https://spatialwalk.github.io/SpatialAvatar-0/

Paper: https://arxiv.org/pdf/2606.15659

Categories: 開源, 數字人, 模型, 視覺模型, Image, 3D

Page 22 of 26
1 … 20 21 22 23 24 … 26