PixWorld 把 3D 重建與生成收在同一路線

想由幾張視角圖重建場景,或者直接做 text→3D、image→3D,PixWorld 把兩條路合併成同一個模型。它的吸引力不只在速度,亦在於訓練目標更貼近 3D 場景本身。

PixWorld teaser

做 3D 場景時,很多方法會把重建同生成分開處理,PixWorld 就反其道而行,把兩者收進同一個開源框架式研究項目:同一個 end-to-end pixel-space diffusion model,同一趟 forward pass,同時兼顧 reconstruction 同 generation。對想比較 text→3D、image→3D 同多視角重建流程的人來說,這種設計最大意義在於少一層轉換,也少一套彼此割裂的模型心智負擔。

它批評的舊範式很明確:不少做法先進 latent space,要經過 VAE/RAE,再由 3D decoder 還原成 3D 表示;PixWorld 則直接在 rendered multi-view images 上施加 pixel-space flow-matching loss,令優化目標更貼近 3D scene fidelity,而唔係先對準中介 latent target。作者再加上一個 geometry perception loss,借助 frozen 3D foundation model 的 π³ / VGGT feature space,補回純 2D photometric loss 同 perceptual loss 對 3D 結構監督不足的問題。

它會把 posed multi-view inputs 分成 clean views 同 noisy views:前者走 reconstruction,後者走 generation,並由 two-stream diffusion transformer 處理,最後解碼成 pixel-aligned 3D Gaussian representation。這個取向的好處,是把 3D reconstruction、text→3D 同 image→3D 放到同一個表示與訓練框架;代價則是項目目前仍偏研究原型,README 已提到 cleaned RealEstate10K、DL3DV、ACID datasets 以及 PixWorld-480P-4steps distilled weights 與 inference code 尚未完整釋出。

  • 類型定位:屬於模型導向的開源項目,處理 3D scene generation 與 reconstruction 分裂成兩套流程的問題。
  • 主要差異:直接在 pixel space 訓練,避開 VAE/RAE 中介表示,並加入 geometry-aware 監督。
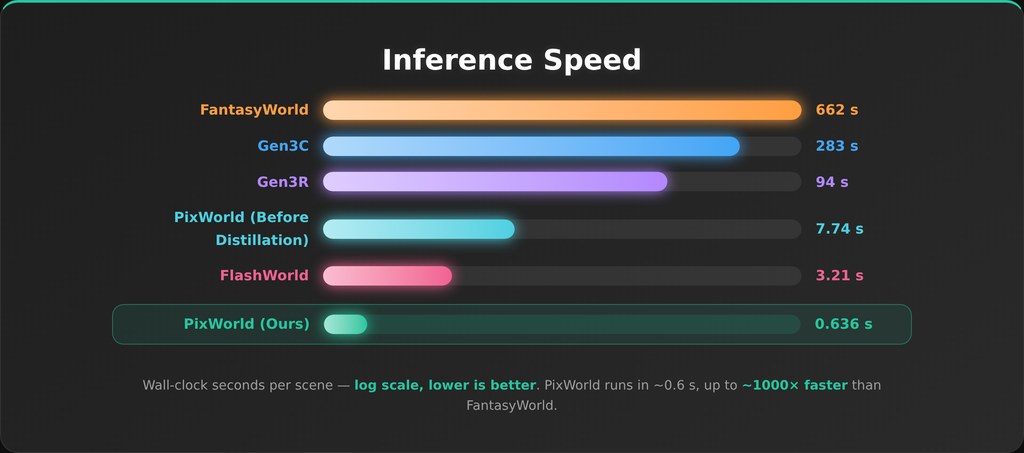
  • 已知表現:distilled 4-step 版本每個 scene 約 0.6 秒,官方稱相對 diffusion-based world generators 峰值可達約 1000× 加速。
  • 重建指標:提供 71.04 WorldScore average,以及 RealEstate10K 4-view reconstruction 的 26.21 dB PSNR。
  • 相關模型與模組:two-stream diffusion transformer、pixel-aligned 3D Gaussian、frozen 3D foundation model π³ / VGGT。

現階段較適合研究 3D world generation、3D Gaussian Splatting、multi-view reconstruction 的團隊先用來判斷方法價值,而唔係即刻當成完整生產工具部署。可惜目前公開資訊仍以論文、示範頁與方法介紹為主,未見完整安裝、評測腳本與權重發布,因此較合理的理解方式,是把 PixWorld 視為一條很有方向感的新路線:它不只是追求更快,還試圖重新定義 3D 生成與重建應該共用同一套訓練目標。
項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Image, 3D

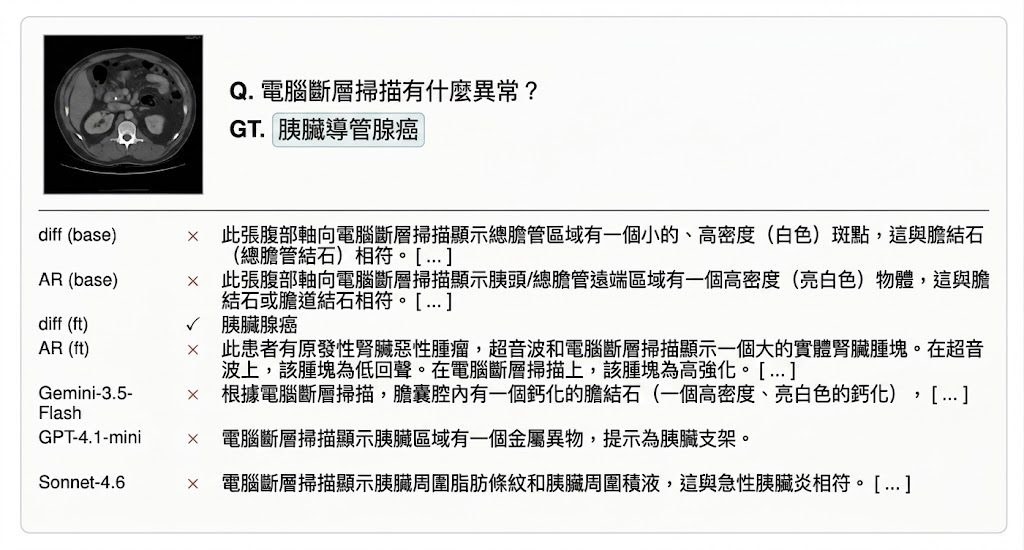
MRPO:醫療多模態推理訓練新路線

MRPO 不是再追最終答案分數,而是直接修補推理中途出錯的位置。醫療 VQA 表現因此更穩,也更有可遷移性。

alt text

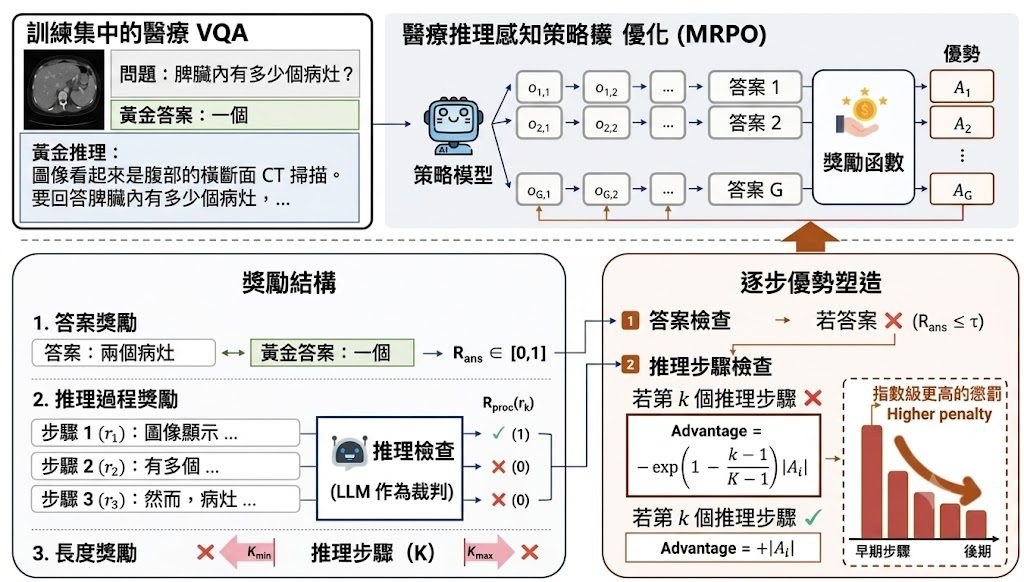
MRPO 是一個用於醫療多模態推理的強化學習框架(reinforcement learning framework)。它要解決的問題不是單純答對與否,而是醫療 VQA 過程中推理鏈一早出錯,之後一路連鎖失誤,令最後答案偏離。

現有 post-training 做法多數偏向 outcome-centric,主要看 final answer correctness 或 sequence-level preferences。作者認為這種範式的問題是 sparse credit assignment,模型知道答錯,卻未必知道究竟由哪一步開始失準;MRPO 因而改寫 GRPO-style advantages,結合 answer-level reward 與 step-wise process rewards,並在最終答案錯誤時,對較早出現的 invalid steps 給予更大懲罰。

這個設計的取向很明確:它不是只罰錯答案,而是重新分配學習訊號,優先修正最早發生的推理錯誤,避免 failure cascades 擴大。README 提到,MRPO 在三個 multimodal LLM backbones 上都優於 standard GRPO 與另一個近期 RL baseline;在 Qwen3-VL-8B-Instruct 上,更以只用 13K training samples 超過較大的醫療 MLLMs,例如 HuatuoGPT-Vision-34B,分數高出 2.79。

  • 核心方法:以 answer-level reward 加 step-wise process rewards 重整 GRPO-style advantages
  • 主要差異:重點放在 first failure,而不是只看最後有冇答中
  • 已公布內容:完整 reinforcement learning recipe、code、datasets 同 infrastructure
  • 可重現方式:項目提供環境腳本、資料下載與前處理流程,訓練資料包含 image、problem、solution 欄位
  • 相關模型:Qwen3-VL-8B-Instruct、HuatuoGPT-Vision-34B,以及 README 提及的另外兩個 multimodal LLM backbones

量化結果最值得留意的是推理質素分析。MRPO 將 early-stage reasoning failures 由 64.0% 降到 13.0%,反映它不只是把答案分數推高,而是令中途推理較少一開始就偏離;這對醫療影像問答尤其重要,因為錯誤往往不是出在最後一句,而是前面觀察與判斷已經失焦。

這個項目較適合研究醫療 AI、醫療影像問答、multimodal reasoning post-training 的團隊參考,也適合想比較 RL 訓練配方差異的人閱讀與重現。它現階段更接近研究原型與訓練方法展示,不是即裝即用的臨床產品;重點價值在於,它把「模型哪一步開始諗錯」正式納入訓練訊號,為醫療 MLLMs 提供一條比只看最終答案更細緻的優化方向。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Image, 框架, Medical醫學

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

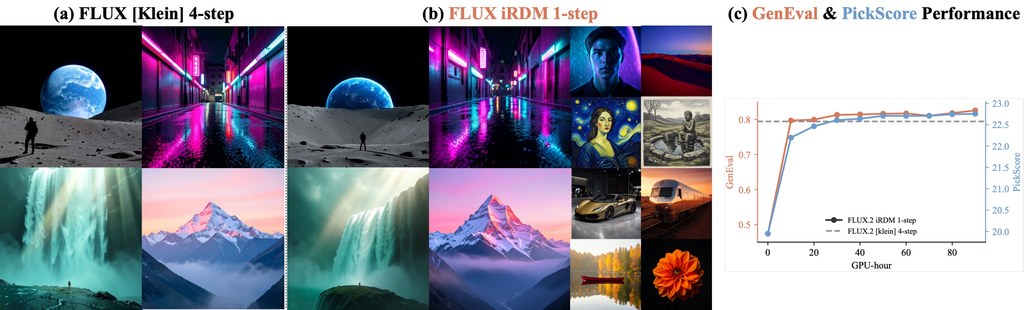
iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26B、Gemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

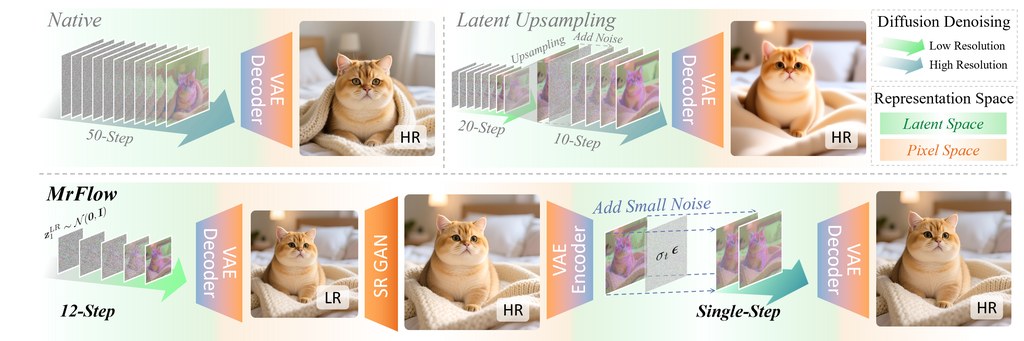
MrFlow framework

MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

OpenMontage:AI 代理拍片流程

OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

OpenMontage

OpenMontage 是一個開源、Agentic 的影片製作工具型項目。它的核心任務是把研究、寫稿、素材生成、片段檢索、剪輯到輸出成片串成同一條流程,讓 AI coding assistant 代為協調整個製作過程。

這個項目最值得留意的地方,在於它不把「幾張靜態圖加動畫」當成影片的唯一做法。它亦會從免費 stock footage 與公開影像檔案建立 corpus,抽取真正的 motion clips,再放入時間線完成合成,取向上比純 txt2img 或 image-to-video 工具更接近剪輯工作流。

部署理解上,現有資料顯示它依賴 FFmpeg,以及 Claude Code、Cursor、Copilot、Windsurf、Codex 這類 AI coding assistant。換句話說,它不像一般單一網頁服務,更像一套由代理驅動的製片管線;測試時較合理的方式,是先用簡單 prompt 驗證腳本規劃、素材來源、成本預估,再觀察最後能否穩定輸出可看的 timeline 與成片。

  • 定位清晰:多個生成與剪輯步驟接駁起來的工作流工具。
  • 差異明顯:支援真實影片片段檢索與編排,不只依賴靜態圖轉影片。
  • 適合情境:內容創作者、小型 marketing 團隊、需要快速做樣片的創意項目會較受惠。
  • 取捨存在:自由度高,但效果會受可用模型、素材來源與代理穩定性影響。

它可保留參考影片的節奏、hook style、結構與 tone,同時改動主題、畫面處理、切入角度與旁白方式,亦會在素材生成前估算目標片長成本。性能數字與正式 benchmark 暫未見完整公開,因此現階段較適合視為早期但方向鮮明的製片自動化項目;相關模型與服務例子包括 Veo,以及配合 AI coding assistant 與 Remotion、FFmpeg 一類組件完成輸出。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

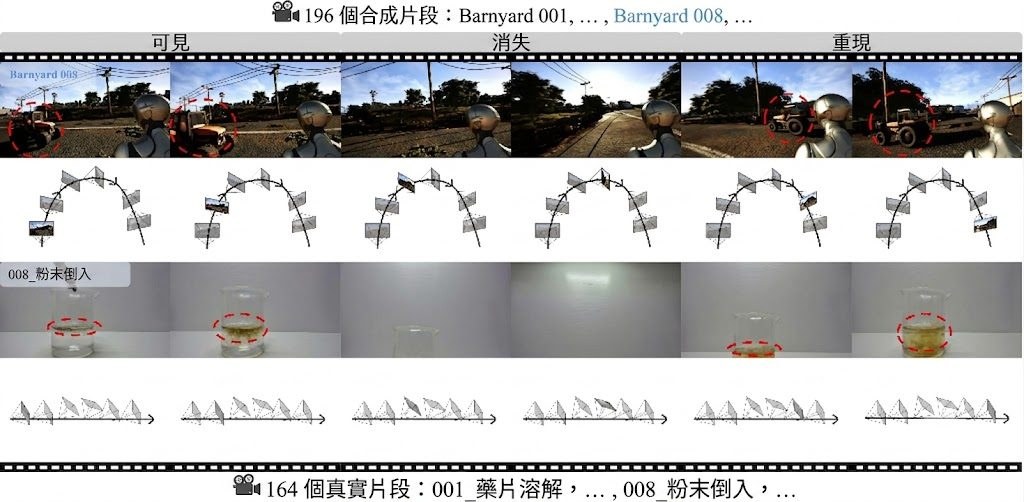
MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

PRA:像素級自回歸生圖的新路線

PRA 是一個 PyTorch 影像生成研究項目,主打 pixel-space autoregressive 生成。它嘗試用較細模型規模,換到更低 FID 表現。

result

PRA 是一個以 PyTorch 實作的影像生成研究項目,屬於 class-conditional pixel-space autoregressive image generation 模型與訓練框架。它要解決的問題,是直接在像素空間逐步生成圖片時,單步誤差大、而且 teacher-forced training 與推理流程不一致,令誤差一路累積。

現有 pixel-space continuous-token autoregressive 做法,多數直接預測高維像素 patch,或用 x-prediction、input noise injection 減輕誤差,但改善有限;exact rollout training 雖然更貼近推理,代價又太高。PRA 的取向是加入 Parallel Rollout Approximation (PRA):先生成低維 intermediate states,再經 pixel decoder 映射回 pixel-space tokens,同時用近似推理時的 pixel-feedback 方式保留平行訓練效率。

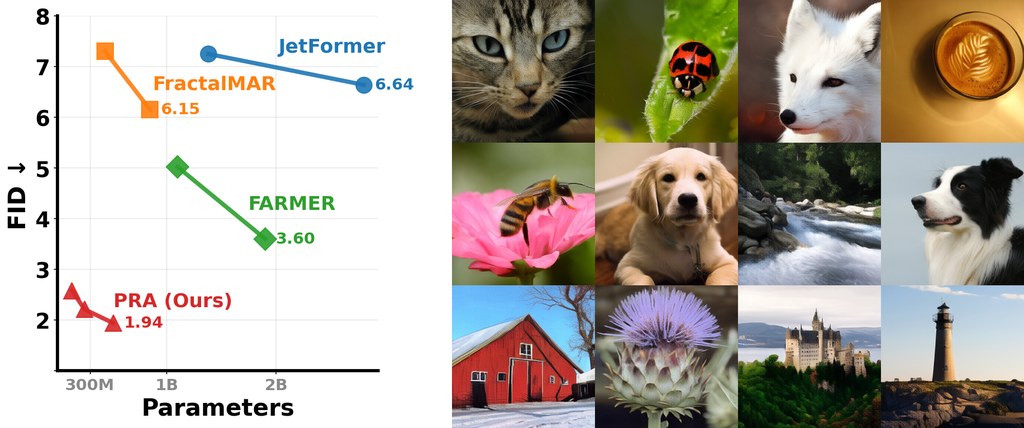
這個設計的重點,不是單純追求更大模型,而是重新處理「訓練見到的輸入」與「生成時真正收到的回饋」之間的落差。論文資料顯示,它在 ImageNet-1K 256×256 的 class-conditional 生成上,PRA-S 135M 參數已做到 FID 2.58,優於先前 billion-scale pixel-space AR 的 3.60;PRA-L 511M 進一步到 1.94,定位很清楚,就是衝着 pixel-space AR 的 SOTA 而來。

部署理解上,儲存庫已提供 environment.yml、requirements.txt、預訓練權重與 sample_ddp.py,代表作者預設你會用多卡分散式抽樣與評測。評估指標包括 FID、Inception Score、precision、recall,另有 ImageNet classification probing accuracy 作為生成以外的補充觀察,表示作者也在測試表徵能力,而不只看出圖漂亮與否。

  • 項目類型:研究原型兼模型實作,集中展示 PRA 訓練與取樣流程
  • 相關模型:PRA-S、PRA-B、PRA-L,參數量約 135M、250M、511M
  • 主要差異:不用離散 tokenizer,維持 pixel-in、pixel-out AR 介面
  • 較適合情境:研究 pixel-space AR、比較生成指標、重現 ImageNet 類條件生圖結果
  • 需要留意:目前公開內容偏向研究重現,不是即裝即用的終端應用工具

受益最大的,會是做影像生成研究的團隊、想比較 autoregressive 與 diffusion 路線的人,以及要研究像素空間建模取捨的學術項目。對一般開發者來說,這個項目較像高水準實驗平台;有現成 checkpoint 和評測流程是優點,但 CUDA、PyTorch 與 FlashAttention 相容性仍需自行處理。

GitHub · Paper

Categories: 北京大學, 模型訓練, Image, 影像模型, Python

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

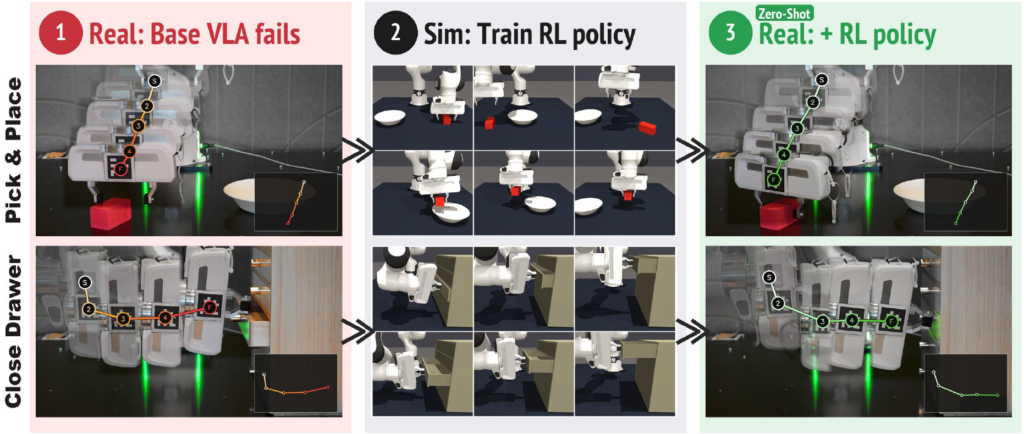
核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLA、Robotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Page 21 of 26
1 … 19 20 21 22 23 … 26