TAP:先學動作,再學指令的 VLA 路線

這是一個針對 Vision-Language-Action 模型訓練瓶頸提出的新框架。它用較少專家示範,換取接近大型資料訓練的操作能力。

TAP Framework Overview

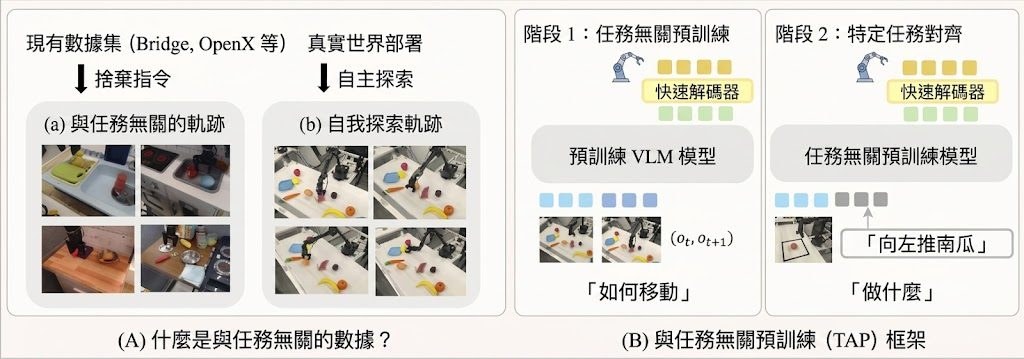
TAP(Task-Agnostic-Pretrain) 是一個 Vision-Language-Action(VLA)模型訓練框架,屬於研究原型兼訓練方法。它要處理的核心問題,是 VLA 長期依賴大量 expert demonstrations,導致機械操作能力難以用較低成本擴展。

現有做法多數直接把「how to move」與「what to do」一齊學,通常需要 observation、instruction、action 這類完整示範資料;作者認為這種固定範式混淆了 physical competence 與 semantic alignment 兩個目標,結果是語言標註被過度用喺本來可以自我監督學習的動作能力上。Task-Agnostic Pretraining(TAP)因此改成兩階段:先用無標註互動資料透過 self-supervised Inverse Dynamics 學 transferable motor priors,再用少量 expert demonstrations 做 task-specific alignment。

這種取向同標準 behavior cloning、以大量網路或專家軌跡堆出來的 VLA 路線唔同。TAP 的取捨很明確:它未必追求一次過把語義和動作全學齊,而是先把可遷移的「點樣郁」拆出來,換來更低標註成本,同時提高對背景、視角變化的穩定度;代價是整個方法仍然要靠第二階段示範去把語言指令對齊到具體任務。

項目已經交代了測試方式:這不是即裝即用應用程式,而是要跟住論文設定,載入 HuggingFace 提供的模型,重現兩階段訓練,再用 SIMPLER benchmark 與真實 WidowX-250s 場景驗證。數字上,TAP-20k 在 SIMPLER 的 Avg-All 為 33.32%,高過 Standard BC 的 23.15%;真實環境中只用 200 個 expert demos,面對 background texture shift 仍有 45% success,viewpoint variation 亦有 20%,而部分 baseline 會跌到 0%。

  • 用 self-supervised Inverse Dynamics 先學動作先驗,減少對語言標註依賴
  • 以約 30 小時 autonomous play 加少量 expert demonstrations,對比 1M+ expert trajectories 路線更慳資料
  • 在 SIMPLER benchmark 勝過 Standard BC,接近或超過部分現有 VLA 模型
  • 對 visual distractors、background texture shift、viewpoint variation 的抗干擾能力較強
  • 相關模型包括 RT-1-X、OpenVLA、Nora、Octo,以及 README 提到的 TAP-20k

項目較適合做 Embodied AI、robot learning、VLA 訓練流程研究的團隊參考,尤其係想用學術規模算力驗證新訓練路線的人。它現階段更像一套值得跟進的方法論,而唔係面向一般用戶的完成品工具。
項目主頁 · GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 教學, Clone, Dataset 數據集

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

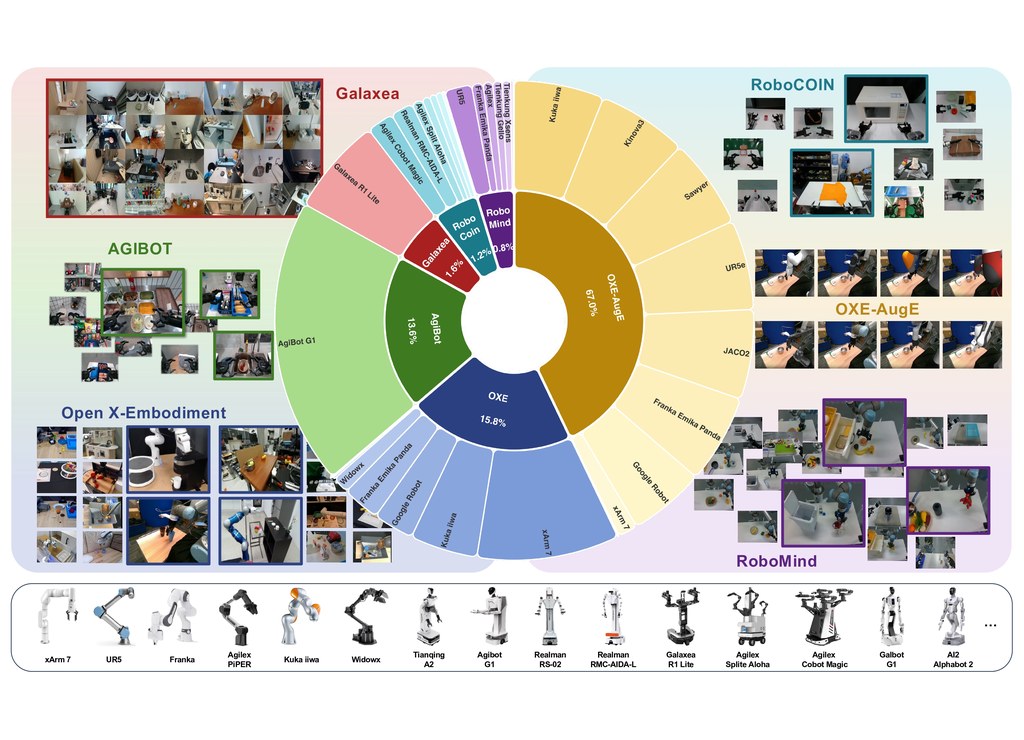
ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

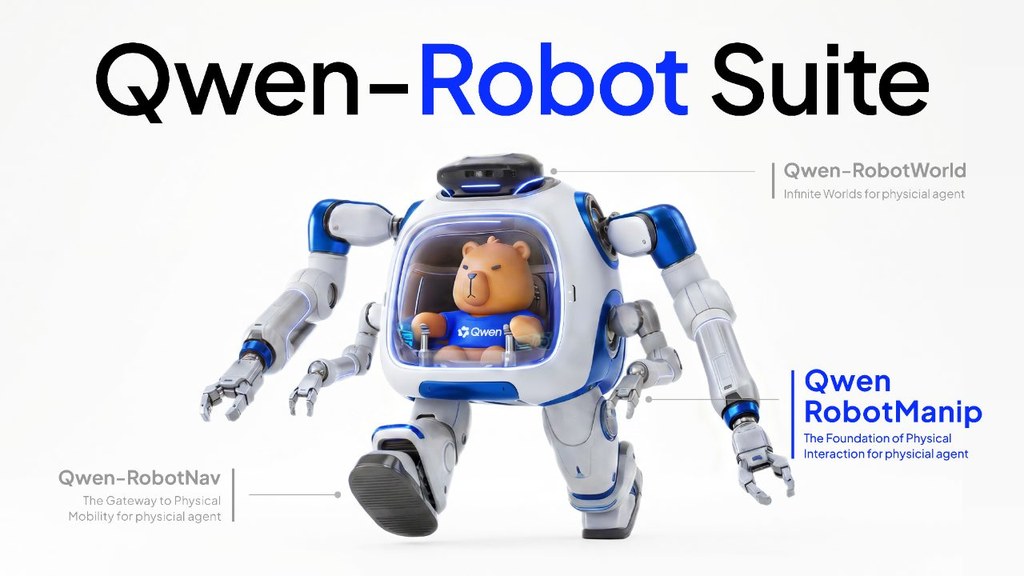
Qwen-RobotManip 如何把機械臂訓練推向通用化

這是一個面向機械人操作的 Vision-Language-Action 基礎模型。它嘗試用統一對齊與大規模資料訓練,提升跨場景與跨機械平台泛化能力。

Og image

這是一個機械人操作模型,名為 Qwen-RobotManip,屬於建基於 Qwen-VL 的 Vision-Language-Action foundation model。它主要處理機械臂操作資料分散、昂貴而且難以統一訓練的問題,目標是讓模型在未見過的任務、場景與機械平台上仍能保持可用表現。

它的核心做法,是把操作學習中的表徵、動作與行為三個層面放進同一套 alignment framework。研究團隊同時建立 human-to-robot synthesis pipeline,將第一身手部示範影片轉成 15 個平台可用的 robot trajectories,再配合多來源資料整理流程,整合真實機械人、合成資料與人類示範影片,形成約 38,100 小時 pretraining corpus。

和常見只集中單一機械平台、單一資料來源,或偏重分佈內表現的做法相比,Qwen-RobotManip 更著重 genuine generalization。評估上亦沒有停留在一般 benchmark,而是加入多個 OOD 設定,包括 RoboCasa365、LIBERO-Plus、EBench、RoboTwin-Clean2Rand、RoboTwin-IF 與 RoboTwin-XE,用來檢查指令跟隨、擾動穩健性、錯誤恢復,以及 cross-embodiment knowledge transfer。

重點可整理為:
– 建基於 Qwen-VL,面向 robotic manipulation 的通用基礎模型
– 以 unified alignment framework 整合 heterogeneous manipulation data
– 使用 human-to-robot synthesis pipeline,覆蓋 15 個機械平台
– 只依靠 open-source robotic manipulation datasets 與 human demonstration videos,未提及私有資料收集
– 在多個 OOD 評測中優於過往 state-of-the-art models,包括 π0.5,並在 RoboChallenge 排名第一

這個項目較適合關注 robotic manipulation、VLA、跨機械平台遷移與機械人資料擴展流程的人閱讀。現有資料顯示,它不單是再加大訓練規模,而是先解決資料對齊問題,令擴充規模之後的訓練信號不會互相衝突,這也是它能在真實機械平台驗證泛化能力的關鍵。

項目主頁 · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, 框架

微軟用殘差強化學習補強機械人 VLA

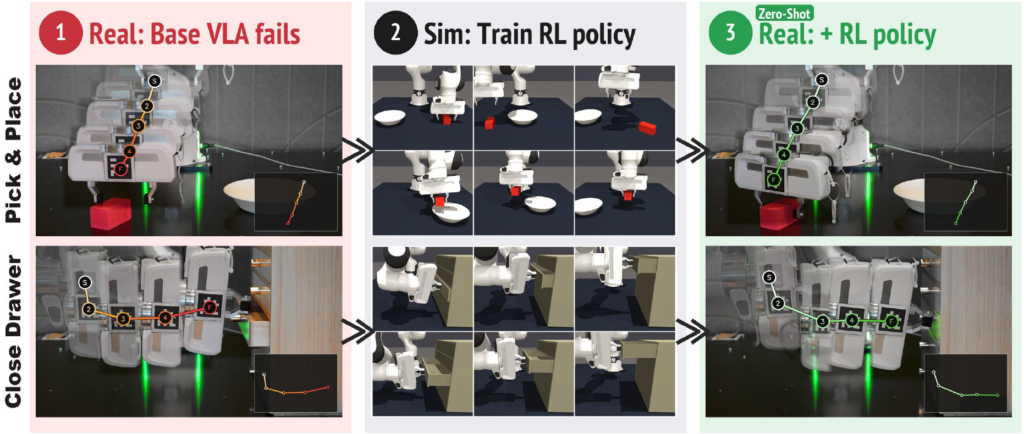
這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLARobotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

用 vision-language-action 把人類操作轉移到機械人的雙手

這項論文提出一種橋接動作表示,改善人類示範向雙手夾爪機械人的技能轉移。重點在於避開嘈雜的6DoF手部姿態。

Hugging Face

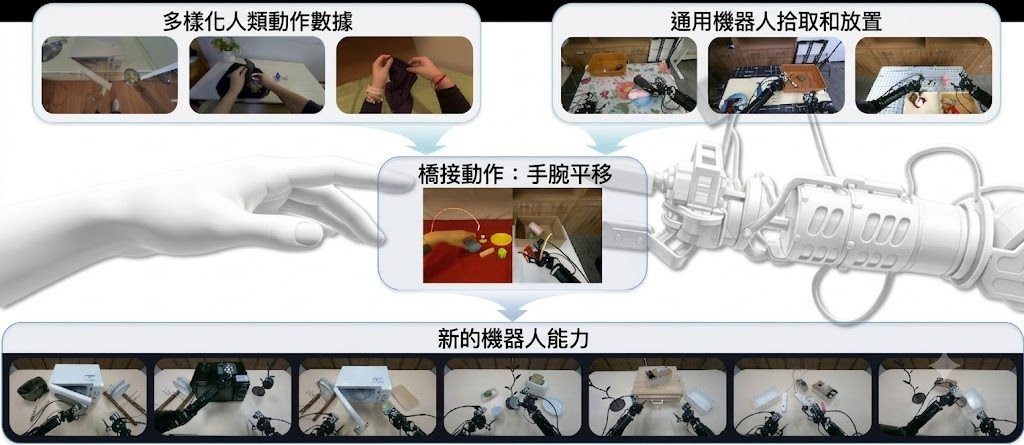
人類操作數據廉價、豐富且多樣化,使其成為擴展機器人學習規範最有前景的資源之一。然而,將人類技能遷移到機器人仍然困難重重:以往的大多數工作都將人類視為另一種雙手6自由度(6DoF)的具身模型,這存在兩個問題:手部姿態估計存在噪聲,並且人類手指的接觸模式與並聯機械臂的接觸模式存在根本差異,導致手腕旋轉與機械臂操作在語義上不一致。我們認為,從人類資料中學習包含旋轉的動作訊號並非最優方案,因此提出了一種 橋接動作表示:在初始頭部-攝影機座標系內的相對手腕平移,這是一個人類和機器人共享的動作空間。

如何把人類操作資料轉移到使用 parallel grippers 的雙手機械人,重點方法是用「relative wrist translation within the initial head-camera frame」作為 bridging action representation。

作者認為把人類直接當成另一種 bi-manual 6DoF embodiment 並不理想,因為手部姿態估計本身有噪聲,而且人手手指接觸模式與 parallel gripper 有本質差異。與其硬學包含旋轉的動作訊號,這項工作改為只保留更容易跨人類與機械人共享的平移資訊,減少 embodiment mismatch。

作者建立了一個 π0-like vision-language-action model,配合 interleaved action tokens 與 attention masking,處理不同 embodiment 可能缺少某些動作成分的問題。這種設計的意義,在於模型不需要假設人與機械人擁有完全相同的控制維度,較適合跨載體技能遷移。

  • 以 wrist translation 取代完整 6DoF human actions,降低人手到夾爪的表示落差
  • 採用 vision-language-action 架構,並加入 interleaved action tokens 與 attention masking
  • 在 novel bi-manual manipulation tasks 上,較 noisy 6DoF human actions 有更有效的知識轉移
  • 效果會隨 human data 數量增加而提升,說明方法具備一定擴展性

這項內容較接近方法論與表示學習分析,而不是部署指南。頁面沒有列出推論框架、硬體需求、v2 檔案更新、chat template 或 MTP draft speculation 等資訊;能確定的是,它針對 Robotic 技能轉移提出一種更貼近夾爪機械人控制需求的動作抽象,適合關注 imitation learning、cross-embodiment transfer 與雙手操作研究的人閱讀。

項目主頁 · Paper

Categories: 香港大學, 字節跳動, 視覺模型, 多模態模型, Robotic, Skill 技能

SimFoundry:單段影片變機械人模擬場景

這是 NVIDIA 的 real-to-sim 項目,可把真實場景影片自動轉成可互動模擬環境。它主打機械人策略訓練、評測與 sim-to-real 遷移。

Digital twin and cousins of the wooden drawer organizer

這是一個由 NVIDIA Research 推出的 robot learning 項目。它的主要用途是把單一真實場景的圖片或影片,自動轉成可供機械人策略訓練與評估的互動式 simulation environment,減少真實世界收集數據與反覆測試的成本。

SimFoundry 的核心做法是建立 modular and automated 的 zero-shot real-to-sim pipeline,從單一影像或影片生成 sim-ready digital twins,並支援 object、scene 與 task editing。除了重建原場景,系統亦可自動產生多種 digital cousins,讓同一個任務在不同物件配置、場景條件或操作要求下擴展訓練資料,提升策略泛化能力。

和常見要大量人工建模、手動調參或依賴多視角掃描的做法相比,這個項目強調以較低輸入門檻快速建立可用模擬場景。頁面亦提到 hybrid scene 表示方式,結合 3D Gaussian Splat 背景與 textured object meshes,重點不只在視覺重建,而是要讓場景可直接用於 policy learning and evaluation。

重點摘要:
– 以單一 image 或 video 建立 real-to-sim 場景
– 可生成 sim-ready digital twins,並編輯 object、scene、task
– digital cousins 有助擴充訓練變化,改善 sim-to-real 泛化
– 在 7 個 manipulation tasks、5 個 policies 上,simulation evaluation 與真實表現高度相關
– object、scene、task cousins 分別帶來平均 17%、21%、50% 任務成功率提升

評測結果顯示,SimFoundry 在 7 項 manipulation tasks 與 5 個 policies 上,simulation evaluation 對真實世界表現具有很強預測力,mean Pearson correlation 為 0.928,mean maximum ranking violation 為 0.018;用於評估真實策略時,頁面亦列出 mean Pearson correlation 0.911。文中提及的策略包括 DreamZero、Gr00t N1.7、π 0.5,顯示這個項目適合用於機械人操作研究、policy benchmarking,以及想以較低成本建立可重複測試流程的團隊。

項目主頁 · Paper

Categories: 模型訓練, NVIDIA, Video, Robotic, 3D

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

Teaser Figure

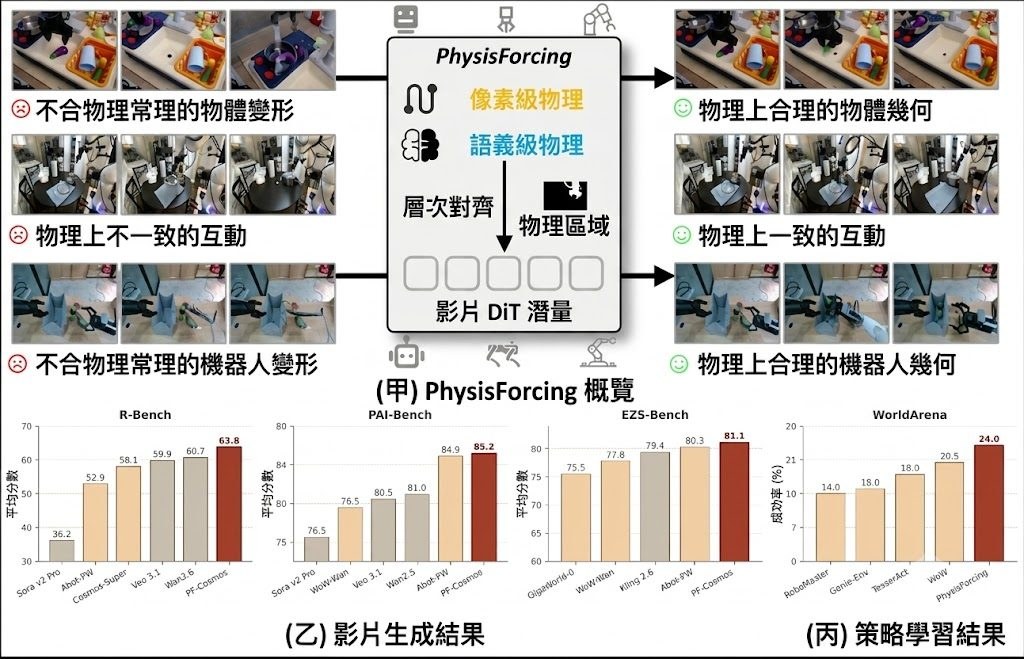
這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

walker run

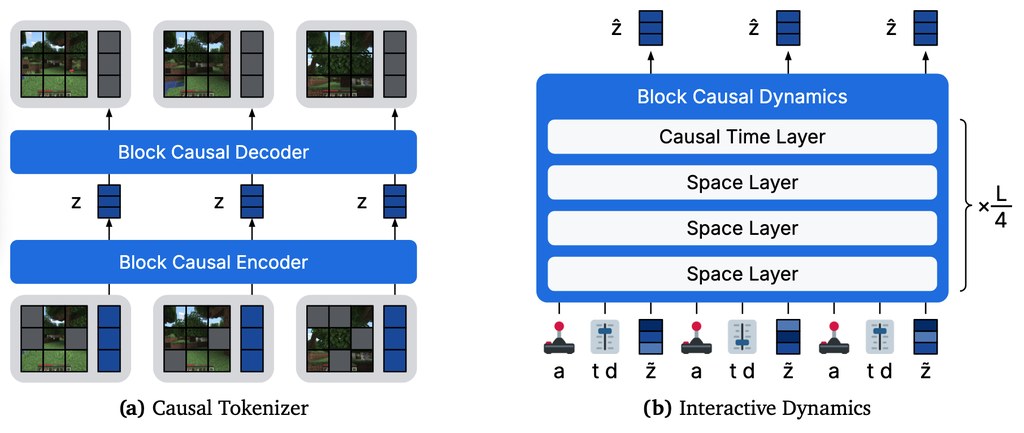
MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

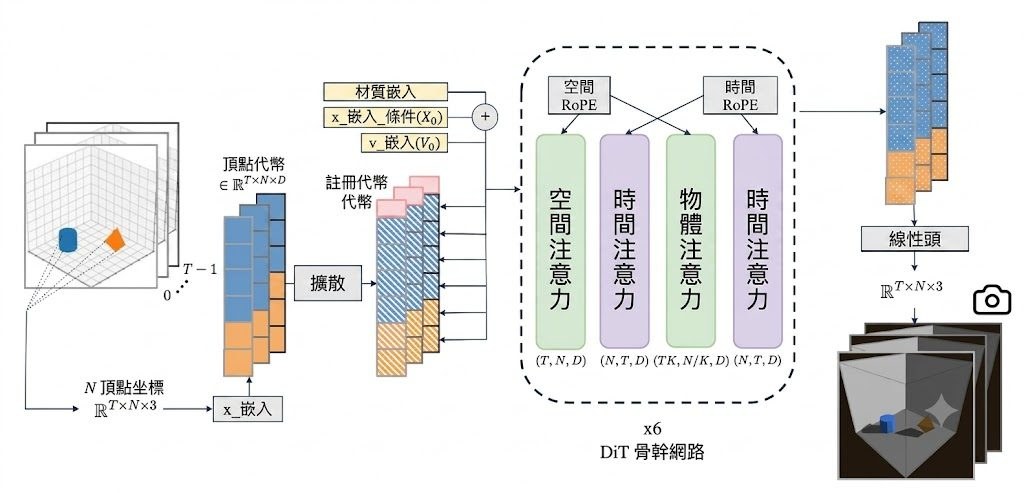
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

EventVLA:長時序機器人操作加入事件記憶機制

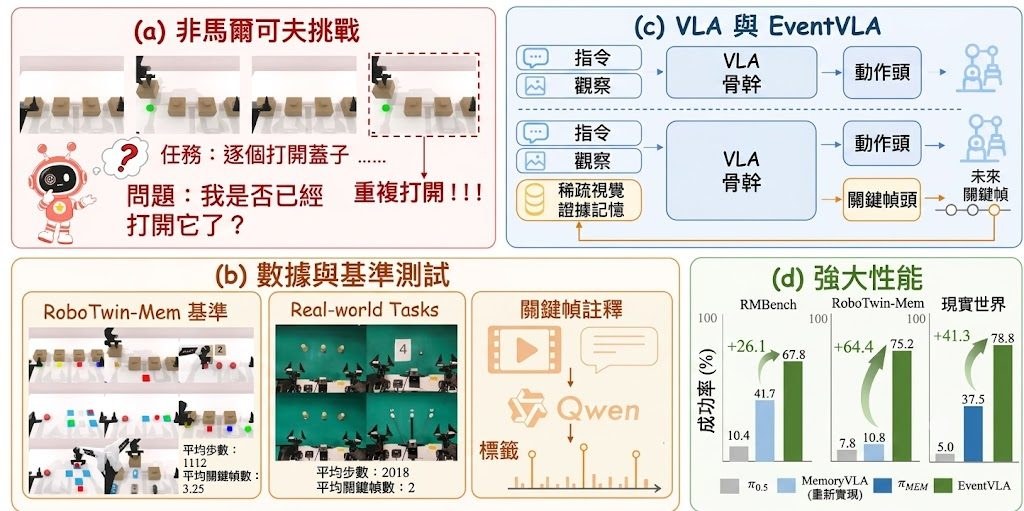
EventVLA 是一個視覺語言動作框架,透過事件驅動的關鍵幀記憶機制,讓機器人在長時序任務中能回溯早期視覺證據,提升操作準確度。

EventVLA Overview

EventVLA 是一個由中國科學技術大學、上海人工智能實驗室、上海交通大學、大連理工大學、香港大學、清華大學、北京大學及華為等團隊共同開發的視覺語言動作(Vision-Language-Action, VLA)框架,專門針對長時序機器人操作任務設計。它解決的核心問題是:當機器人需要執行跨越許多步驟的任務時,往往必須回想起數十步之前出現過的視覺線索,而傳統 VLA 政策通常只依賴壓縮後的隱狀態,容易遺失早期關鍵畫面。EventVLA 的做法是引入事件驅動的視覺證據記憶(event-driven visual evidence memory),在執行過程中偵測與任務相關的事件,把對應的關鍵幀以原始影像形式存入記憶體,並在後續動作預測時重新取用這些畫面作為參考。

這個項目同時發佈了 RoboTwin-MeM 基準測試,這是建基於 RoboTwin 2.0 的記憶依賴型操作評測環境,包含八個需要長時序記憶的任務,例如依序拾取物件、按照紙上指示重複放下積木、依指示重現路線等。與同類 VLA 框架相比,EventVLA 的差異在於它不只壓縮隱狀態,而是保留原始關鍵幀影像作為可回溯的視覺證據,這在需要精確回憶早期空間配置的任務上特別有用。

部署與測試方式

  • 建議建立兩個 conda 環境:一個用於 RoboTwin-MeM 模擬,另一個用於 EventVLA 模型訓練與推論。
  • 從 Hugging Face 下載對應的 checkpoint(RoboTwin-MeM 或 RMBench 版本),搭配相應的評測腳本即可在模擬環境中重現結果。
  • 數據集同時提供 HDF5 軌跡格式與 LeRobot 2.1 訓練格式,方便不同訓練流程直接取用。
  • 目前程式碼已支援模擬訓練與評估,真實機器人推論與微調模型仍在開發中。

重點摘要

  • 核心機制:事件驅動的關鍵幀記憶,以原始影像儲存視覺證據而非僅壓縮隱狀態。
  • 配套基準:RoboTwin-MeM 包含八個長時序記憶依賴任務。
  • 目前狀態:模擬環境訓練與評估已開源,真實世界部署尚未釋出。
  • 適用場景:需要回溯早期視覺線索的多步驟機器人操作任務。

從已釋出的資源來看,研究人員與機器人團隊可直接透過 Hugging Face 上的 checkpoint 與 RoboTwin-MeM 數據集進行基準測試與模型微調,評估記憶機制對長時序任務表現的影響。

GitHub: https://github.com/InternRobotics/EventVLA

項目主頁: https://ganlin-yang.github.io/EventVLA.github.io/

模型: https://huggingface.co/ganlinyang/EventVLA/tree/main

Categories: 開源, 香港大學, 北京大學, 清華大學, 上海人工智慧實驗室, 華為, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, Qwen, Robotic, 框架, 香港, 深度學習, 中國

Page 6 of 8
1 4 5 6 7 8