PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

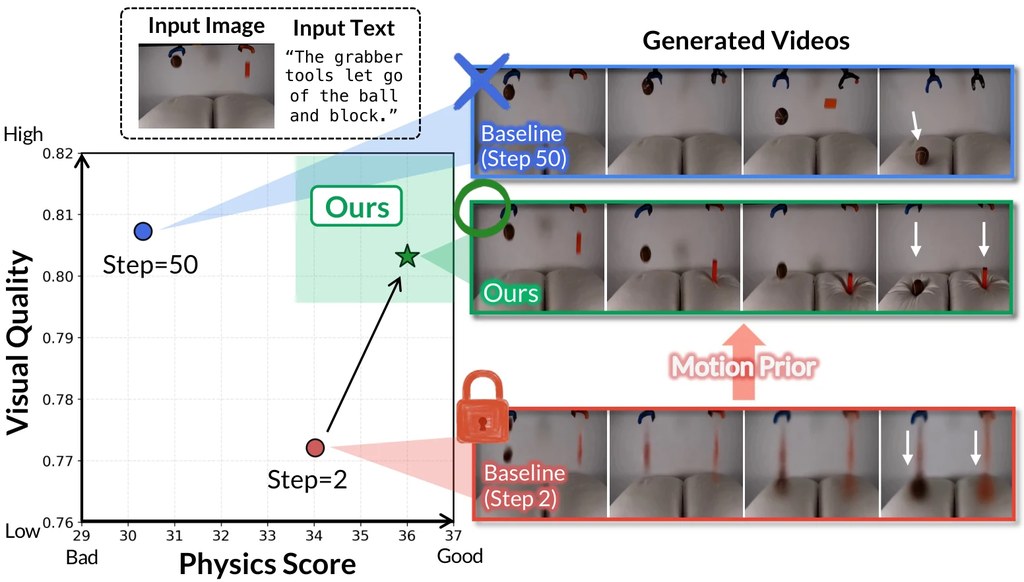
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

Dream.exe 評測 A.I. 生成的「夢境」能否真的驅動機械人?

Dream.exe 嘗試把影片生成模型的「想像」轉化為機械人可執行的軌跡,並用101項任務評估8款模型。影片好看不代表可執行,是這份研究最值得關注的發現。

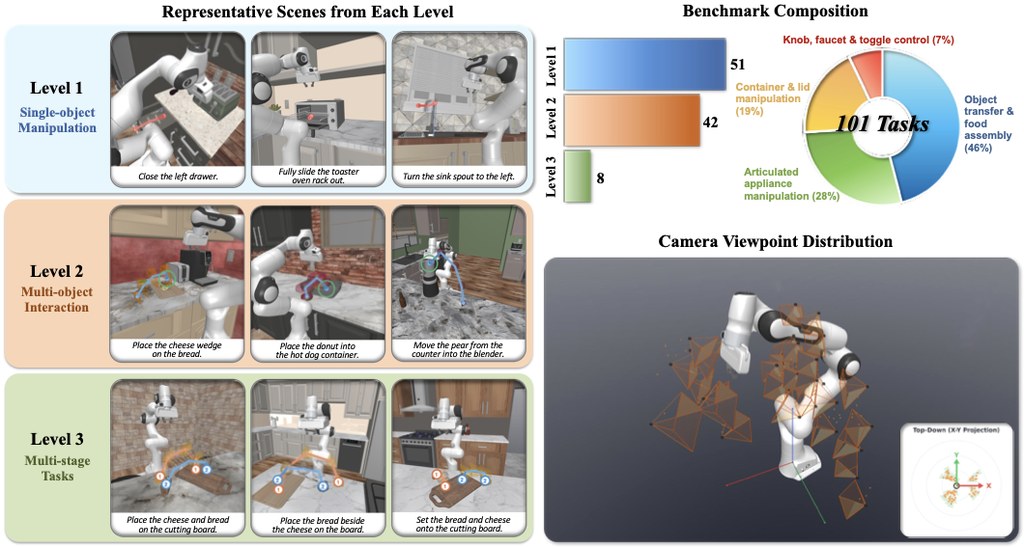
Overview of the Dream.exe task suite

過去兩年,影片生成模型(Video Generation Models)的能力突飛猛進,但大多數評估都停留在「畫面是否好看」這個層面。來自新加坡國立大學 Show Lab、牛津大學及 Tencent 的研究團隊推出 Dream.exe 項目,提出一個更根本的問題:模型在影片中「夢到」的操作動作,機械人真的能照著做嗎?

Dream.exe 的運作流程相當直觀。系統接收一張場景圖片與任務描述後,會先生成一段操作影片,再把當中的動作提升為 3D 機械人軌跡,最後放到物理模擬器中執行。研究團隊採用了 101 項任務,這些任務從 RoboCasa 數據集中精心挑選,並按物理複雜度分為三個等級,評分維度涵蓋視覺品質、軌跡擬真度,以及最關鍵的執行成功率。

評估涵蓋 8 款模型,包括前沿閉源模型如 Veo 2 及 Sora、開源模型如 Wan2.1,以及專為機械人設計的影片生成器。所有模型都採用統一的評測協議,確保比較公平。

這份研究帶來幾個值得留意的地方:

  • 物理知識其實已經藏在生成模型之中。 部分模型在沒有經過任何機械人專項訓練的情況下,仍能達到可量度的執行成功率。
  • 影片好看不代表能執行。 物理合理性評分與任務成功率的相關性極低,意味著以視覺質素判斷模型是否「有用」並不可靠。
  • 長時任務仍是痛點。 需要多階段協調的操作,會迅速暴露現有模型的極限。

對於機器學習研究者、機器人工程師,以及關注世界模型(World Models)與具身智能(Embodied AI)發展的讀者,這份基準測試提供了一個可重複使用的評估框架。研究團隊已表示將開源代碼、基準數據及評測工具,預計會引起不少關注。整體而言,Dream.exe 把影片生成模型從「看的技術」推向「用的技術」,是 2026 年具身智能研究中具代表性的方向之一。

GitHub: https://github.com/showlab/Dream.exe

Categories: 開源, 視覺模型, Robotic, 框架

WLA:整合世界、語言與動作模型

上海交大 DENG 實驗室發佈的 WLA 模型,把世界建模、語言推理與動作生成三項能力整合於一身,是統一型多模態 AI 的一次新嘗試。

Repository image for SJTU-DENG-Lab/WLA

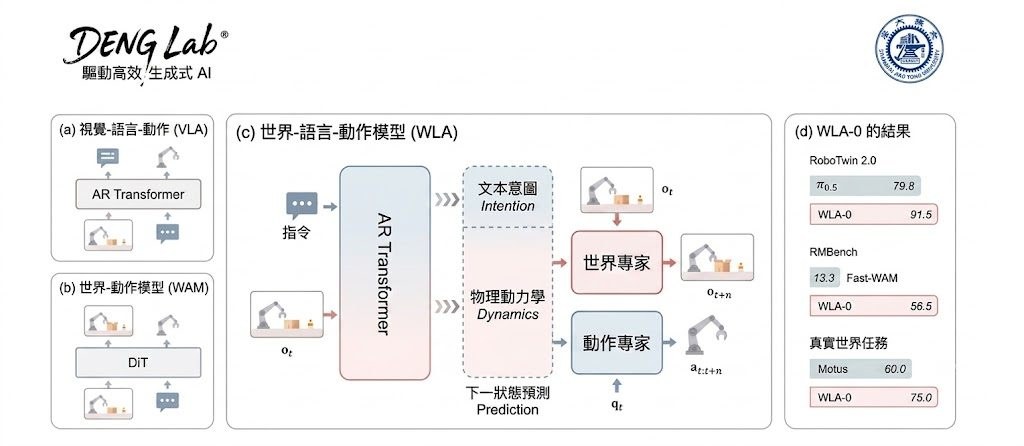
WLA(World-Language-Action Model)由上海交通大學 DENG 實驗室推出,定位為一個統一世界建模、語言推理與動作合成的官方實現項目。簡單來說,研究團隊嘗試讓同一個 AI 系統同時處理「理解世界」、「理解語言」以及「產生動作」三種任務,而不再需要三個獨立模型分工合作。這對於機器人、遊戲 AI 以及需要即時決策的互動系統來說,是一條值得關注的技術路徑。

目前這個項目仍處於預告階段,程式碼與模型權重計劃在 6 月 18 日之前開源釋出,官方提供了展示影片展示其運作效果。在動手實作方面,潛在使用者短期內只能先關注儲存庫的更新,等待權重釋出後再評估本地部署或 API 整合的可能性,項目本身亦未透露具體支援的模型清單。

這個項目的創新方向,是把感知層、認知層與執行層的概念放在同一個訓練框架下學習,減少傳統流水線中模組之間的介面損耗。對於機器人研究團隊、強化學習開發者,以及探索通用代理人(General-purpose Agent)架構的工程師而言,WLA 提供了一個可參考的新設計樣板。效能數據與基準測試結果,則有待官方釋出後再做比較。

以下整理幾個重點供參考:

  • 統一框架:把世界模型、語言模型與動作模型合而為一,降低多模態系統的整合成本。
  • 學術背景:來自上海交大 DENG 實驗室,屬於官方實作項目。
  • 適用場景:機器人控制、互動式代理人、強化學習等需要即時決策的應用。
  • 目前狀態:程式碼與權重即將於 6 月中前公開,尚未有完整基準評估。
  • 使用建議:在權重釋出前,讀者可先研究展示影片與後續論文,掌握其訓練思路再決定是否整合。

若你正在尋找一個把感知與行動串起來的新框架,WLA 值得加入觀察清單。

GitHub: https://github.com/SJTU-DENG-Lab/WLA

Categories: 開源, 視覺模型, Robotic, 中國

PhysBrain-VLA:教機械人先懂物理常識

全球首個物理智能數據引擎,將海量人類視頻轉化為多模態大模型訓練數據

Repository image for Phys-Brain/PhysBrain-VLA

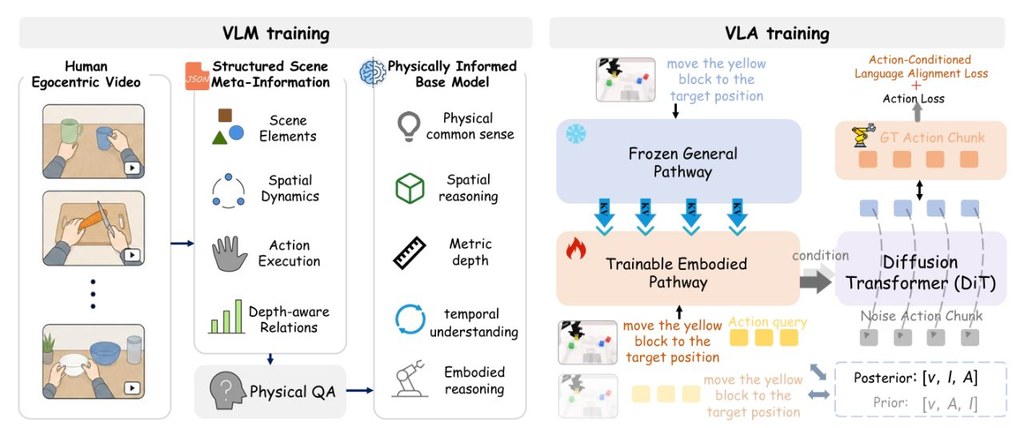
PhysBrain-VLA 係一個面向機械人控制的研究專案,但它最值得留意的地方,其實係訓練思路改變咗。以往不少系統主要靠機械人示範資料學動作,成本高之餘,遇到新場景亦未必識變通;而呢個專案就主張先由大量人類第一身影片抽取「物理常識」,再轉化畀模型學習。

對一般讀者嚟講,可以將它理解為:與其死記「點樣拎起杯」,不如先明白杯喺枱上、手要接近、物件有前後高低關係,甚至某些動作做唔做到。根據公開資料,團隊處理咗超過 3,000 小時人類影片,並整理成包含空間關係、動作可行性同推理線索的多模態訓練資料。

如果你想上手理解這個專案,較實際的方法唔係直接當成即裝即用工具,而係先由它的整體架構入手:先看資料引擎點樣把影片轉成結構化訊息,再看基礎模型如何吸收這些知識,最後理解 VLA 部分點樣把理解能力轉成機械人動作。對研究員、機械人開發者,或者關心 embodied AI 發展方向的人,呢個閱讀路線會比較清晰。

  • 核心價值係減少對昂貴機械人示範數據的依賴
  • 主要做法係由人類第一身影片提煉物理與空間常識
  • 架構包含 PhysBrainTwinBrainVLALangForce
  • 提到的評測包括 ERQA、PhysBench、SimplerEnv-WidowX、LIBERO、RoboCasa

其中較有新意的是 TwinBrainVLA 的雙腦式設計,目標是減輕微調後「學咗新嘢就忘記舊嘢」的問題;LangForce 則把訓練重心由單純模仿行為,轉向較貼近物理推理的學習方式。從論文摘要來看,它在多個理解與控制評測都有強表現,尤其在陌生環境的泛化能力方面值得關注。

整體而言,PhysBrain-VLA 未必係面向普通用家的產品型專案,但作為技術方向,它展示咗一條幾實際的路:先讓模型理解世界,再叫它出手做事。若你想追蹤未來機械人如何由「照做」走向「識判斷」,這個專案相當有參考價值。

Project Page:  https://phys-brain.github.io

網址: https://github.com/Phys-Brain/PhysBrain-VLA

網址: https://arxiv.org/pdf/2605.15298

Categories: 開源, 模型, 視覺模型, 影像模型, Robotic, 中國

DexJoCo:靈巧機械手模擬實驗入門

這個專案用 MuJoCo 建立靈巧操作模擬流程,亦照顧到示範收集與遙控操作。對研究機械手任務的人來說,方向相當清晰。

Repository image for brave-eai/dexjoco

DexJoCo 是一個以 MuJoCo 為基礎的模擬基準與工具集,重點放在「有目標的靈巧操作」:例如用機械手完成特定任務,而不只是做單一抓取動作。對初學者來說,它的價值在於把模擬環境、示範收集,以及遙控操作相關元件放在同一個專案內,較容易看清整體流程。

如果你想使用,先把它當成任務模擬平台,再了解示範資料如何被記錄。README 提到可輸出 Zarr 格式重播資料與相機影片,這表示它不只用來「睇畫面」,亦方便之後做訓練、重播或比較不同方法表現。

它較有意思的地方,是把遙控操作設計成依賴明確的 UDP 封包協定。換句話說,模擬器本身與外部裝置之間有一定解耦,無論是 Vive tracker、Rokoko,甚至內含的 GeoRT 流程,都較像可替換的輸入橋樑,令擴充與整合更實際。

  • 以 MuJoCo 為核心,集中處理靈巧操作任務
  • 支援示範收集,並輸出重播資料及影片
  • 內建多種遙控相關橋接元件,方便接駁外部追蹤資料
  • 可切換互動模式與較適合策略執行的無畫面模式

適合的讀者主要是機械人研究者、學生,或者想測試手部操作任務的人;如果你正研究 imitation learning、policy evaluation,這類資料輸出會特別有用。從專案內容可見的相關組件包括 MuJoCo、Vive bridge、Rokoko、GeoRT,以及用於資料儲存的 Zarr;至於 README 亦提到 policy mode 與離屏渲染設定,反映它同時兼顧互動收集與批次實驗兩種場景。

整體來看,DexJoCo 未必是面向一般用家的即開即用工具,但作為研究型基礎設施,它的定位相當清楚。若你需要一個把任務模擬、遙控輸入和示範記錄串連起來的環境,這個專案值得留意。

網址: https://github.com/brave-eai/dexjoco

Categories: 開源, 香港中文大學, 世界模型, Robotic

VLS : 透過視覺語言模型引導預先訓練機器人策略

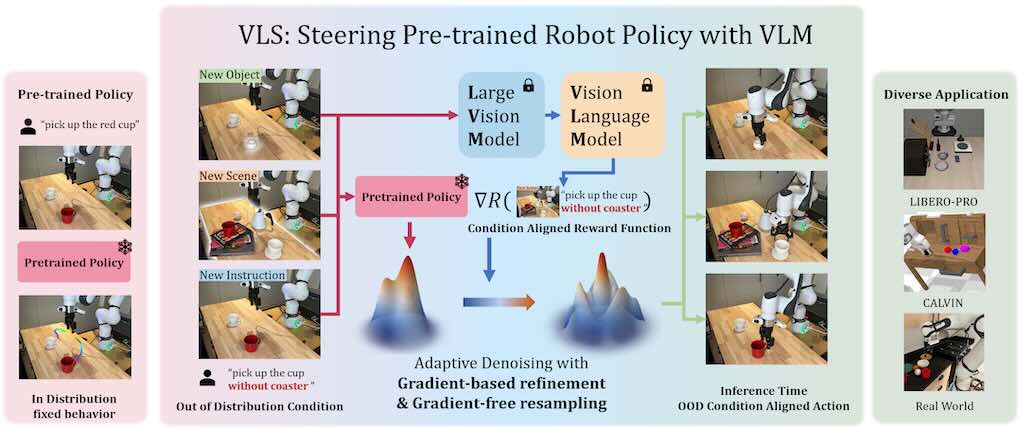
VLS(Vision-Language Steering)的具體作用是透過視覺語言模型(VLM)即時導向預訓練機器人策略,解決測試時的分布偏移,讓機器人在新環境中保持高成功率,而無需重新訓練。 VLS 針對預訓練擴散策略在空間變化(如新位置)或任務變化(如新物件)下的失效,提供無梯度、無訓練的適應機制,利用 VLM 生成可微分獎勵函數,注入去噪過程。​它將任務分解為順序階段(如「抓取」→「放置」),使用 3D 關鍵點獎勵,避免單一失敗導致整體崩潰。 場景 無 VLS 成功率 有 VLS 成功率 提升幅度 任務擾動 23% 38% +15% 位置擾動 24% 35% +11% 真實廚房任務 ~50% 85% +35%

VLS(Vision-Language Steering)的具體作用是透過視覺語言模型(VLM)即時導向預訓練機器人策略,解決測試時的分布偏移,讓機器人在新環境中保持高成功率,而無需重新訓練。

VLS 針對預訓練擴散策略在空間變化(如新位置)或任務變化(如新物件)下的失效,提供無梯度、無訓練的適應機制,利用 VLM 生成可微分獎勵函數,注入去噪過程。
它將任務分解為順序階段(如「抓取」→「放置」),使用 3D 關鍵點獎勵,避免單一失敗導致整體崩潰。

場景無 VLS 成功率有 VLS 成功率提升幅度
任務擾動23%38%+15%
位置擾動24%35%+11%
真實廚房任務~50%85%+35%
Categories: 開源, 視覺模型, Robotic

RBench and RoVid-X 機器人影片生成

RoVid‑X 號稱是目前最大規模的機器人影片生成開源資料集,約 400 萬 clips,覆蓋 1300+ skills / tasks,解析度達 720p,同時支援多樣機器人形態與多樣文字描述。RoVid‑X 主要解決現有 SOTA video diffusion / transformer 模型,在一般影片生成指標上不錯,但面對需要「因果一致、物理連貫」的機器人操作影片時,常出現物理錯誤、目標物體消失/瞬移、關節極限違反等問題。 RBench 旨在評估面向機器人的視訊生成的表現。它評估任務層面的正確性和視覺保真度。 雖然RBench為識別這些缺陷提供了必要的視角,但要實現物理上的真實性,還需要超越評估層面,解決高品質訓練資料嚴重短缺的問題。基於這些,他們引入了一個改進的四階段數據管道,由此誕生了 RoVid-X——迄今為止最大的開源機器人視頻生成數據集,涵蓋數千個任務,並富含全面的物理屬性標註。這項協同的評估和資料生態系統為視訊模型的嚴格評估和可擴展訓練奠定了堅實的基礎,加速了具身人工智慧向通用智慧的演進。

RoVid‑X 號稱是目前最大規模的機器人影片生成開源資料集,約 400 萬 clips,覆蓋 1300+ skills / tasks,解析度達 720p,同時支援多樣機器人形態與多樣文字描述。RoVid‑X 主要解決現有 SOTA video diffusion / transformer 模型,在一般影片生成指標上不錯,但面對需要「因果一致、物理連貫」的機器人操作影片時,常出現物理錯誤、目標物體消失/瞬移、關節極限違反等問題。

RBench 旨在評估面向機器人的視訊生成的表現。它評估任務層面的正確性和視覺保真度。 雖然RBench為識別這些缺陷提供了必要的視角,但要實現物理上的真實性,還需要超越評估層面,解決高品質訓練資料嚴重短缺的問題。基於這些,他們引入了一個改進的四階段數據管道,由此誕生了 RoVid-X——迄今為止最大的開源機器人視頻生成數據集,涵蓋數千個任務,並富含全面的物理屬性標註。這項協同的評估和資料生態系統為視訊模型的嚴格評估和可擴展訓練奠定了堅實的基礎,加速了具身人工智慧向通用智慧的演進。

Categories: 開源, 視頻模型, 影像模型, Robotic

FrankenMotion 人體動作生成框架

FrankenMotion 是一個以擴散模型為基礎的文本到人體動作生成框架,專注於對單一動作的各個身體部位進行細緻控制。研究團隊先建立名為「FrankenStein」的大規模運動資料集,這份資料集以大型語言模型自動生成的原子化、具備時間感知的逐部份文字敘述,填補了先前資料集只能提供全局或動作層級標註的不足。透過這些高度結構化的部位標註,模型能夠在訓練時同時學習空間(哪個部位在動)與時間(每個部位的具體時間模式)兩層資訊。 實驗結果顯示,相較於先前的 UniMotion、DART、STMC 等模型,FrankenMotion 在語義正確性與運動真實感上都有顯著提升,甚至能創造出訓練時未曾見過的組合動作,例如在坐下的同時抬起左手。

FrankenMotion 是一個以擴散模型為基礎的文本到人體動作生成框架,專注於對單一動作的各個身體部位進行細緻控制。研究團隊先建立名為「FrankenStein」的大規模運動資料集,這份資料集以大型語言模型自動生成的原子化、具備時間感知的逐部份文字敘述,填補了先前資料集只能提供全局或動作層級標註的不足。透過這些高度結構化的部位標註,模型能夠在訓練時同時學習空間(哪個部位在動)與時間(每個部位的具體時間模式)兩層資訊。

實驗結果顯示,相較於先前的 UniMotion、DART、STMC 等模型,FrankenMotion 在語義正確性與運動真實感上都有顯著提升,甚至能創造出訓練時未曾見過的組合動作,例如在坐下的同時抬起左手。

Categories: 開源, 模型, Robotic, , 編程

RoboVIP 訓練機器人的模擬數據生成

RoboVIP 解決機器人領域中,真實世界訓練數據不足且難以大量取得的痛點。RoboVIP 是一個機器人數據生成工具,它讓研究者能用更聰明、更可控的方式製造模擬數據,進而訓練出更強大、更不容易出錯的機器人。 RoboVIP 引入了「視覺身份提示 (Visual Identity Prompting)」,你可以直接給 AI 一張「參考圖」(例如一張特定碗的照片),AI 就能精準地在影片中生成或替換成那個碗,讓生成的畫面更真實、更符合需求。 研究證明,用 RoboVIP 處理過的數據去訓練機器人(像是 Pi0 或 Octo 這類模型),不只在模擬環境中表現更好,在真實世界的機器人操作上,成功率也顯著提升,尤其是在處理混亂、複雜的場景時。

RoboVIP 解決機器人領域中,真實世界訓練數據不足且難以大量取得的痛點。RoboVIP 是一個機器人數據生成工具,它讓研究者能用更聰明、更可控的方式製造模擬數據,進而訓練出更強大、更不容易出錯的機器人。

RoboVIP 引入了「視覺身份提示 (Visual Identity Prompting)」,你可以直接給 AI 一張「參考圖」(例如一張特定碗的照片),AI 就能精準地在影片中生成或替換成那個碗,讓生成的畫面更真實、更符合需求。

研究證明,用 RoboVIP 處理過的數據去訓練機器人(像是 Pi0 或 Octo 這類模型),不只在模擬環境中表現更好,在真實世界的機器人操作上,成功率也顯著提升,尤其是在處理混亂、複雜的場景時。

Categories: 開源, Robotic

CHORD 框架作為人類或機器人操作介面

CHORD 是一套通用的生成式流程,能直接從普通的 2D 影片畫面中抽取隱含的拉格朗日運動資訊,進而合成各式各樣的 4D 動態場景。這套方法不依賴任何類別專屬的先驗或結構標註,也不需要龐大的標註資料集,只要把影片送入分配式蒸餾流程,就能把 2D 影像裡的運動資訊轉換成 3D 物體的時間軸運動軌跡。如此得到的資訊既適用於單一物體,也能支援多物體之間的互動,讓模型在不限定物件類別的情況下,自動產生多層次、複雜的動態場景。 實驗顯示 CHORD 能快速生成從玩具積木、運動部件到機器人操作等不同情境的 4D 效果,且在視覺品質和多樣性上相較於既有的規則導向或大規模資料訓練方法更具優勢。同時,這套框架也能直接提供給人類或機器人操作介面,協助後續的實體模擬與控制。整體而言,CHORD 以低成本、無需大量標註的方式,讓生成式 AI 能更廣泛地應用於真實世界的 4D 動態創作上。

CHORD 是一套通用的生成式流程,能直接從普通的 2D 影片畫面中抽取隱含的拉格朗日運動資訊,進而合成各式各樣的 4D 動態場景。這套方法不依賴任何類別專屬的先驗或結構標註,也不需要龐大的標註資料集,只要把影片送入分配式蒸餾流程,就能把 2D 影像裡的運動資訊轉換成 3D 物體的時間軸運動軌跡。如此得到的資訊既適用於單一物體,也能支援多物體之間的互動,讓模型在不限定物件類別的情況下,自動產生多層次、複雜的動態場景。

實驗顯示 CHORD 能快速生成從玩具積木、運動部件到機器人操作等不同情境的 4D 效果,且在視覺品質和多樣性上相較於既有的規則導向或大規模資料訓練方法更具優勢。同時,這套框架也能直接提供給人類或機器人操作介面,協助後續的實體模擬與控制。整體而言,CHORD 以低成本、無需大量標註的方式,讓生成式 AI 能更廣泛地應用於真實世界的 4D 動態創作上。

Categories: Robotic

Page 8 of 8
1 6 7 8