VCSD 點樣逼可以 Vision-Language Models 真係睇圖

同一條問題配原圖同抹走內容嘅控制輸入,VCSD用兩次預測差異教模型分清邊啲答案真係來自視覺訊息。它瞄準嘅唔係加大模型,而係減少模型「冇睇圖都答到」嘅錯位。

Cover Figure overview

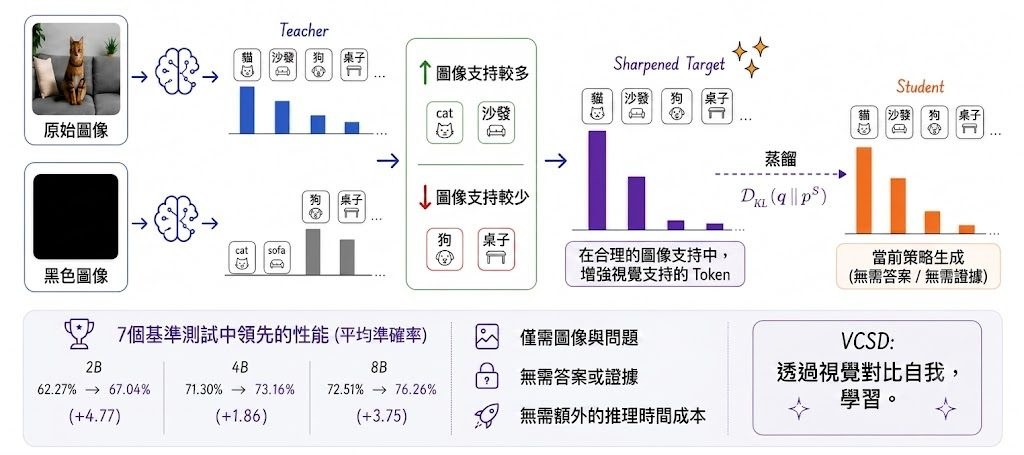
不少 Vision-Language Models 會表面上處理圖片,實際卻沿住語言慣性作答。VCSD 屬於模型訓練方法,針對嘅正正係呢種「答案似乎合理,但未必真係由圖像帶動」嘅問題:它讓同一個 EMA teacher 分別看原圖同內容被抹走嘅 control input,再用兩者對每個 response token 嘅分佈差異,提煉出更依賴視覺內容嘅學習目標。

現有 on-policy self-distillation(OPSD)多數靠 privileged answers 或 visual evidence 製造 teacher 比 student 更強嘅訊號,VCSD反過來把 image-content removal 變成非對稱來源。做法唔係直接獎勵某幾個字,而係用原圖分佈 p_hi 同控制輸入分佈 p_ctrl 嘅 log-probability 差,配合 α 調整對比強度,再用 β-plausibility mask 限制只喺 teacher 原本已視為可信嘅 token 集合內重新分配機率;README 亦講明 β 設成 0.0 會令訓練崩潰,代表呢個護欄唔係裝飾,而係方法成立嘅關鍵。

項目目前仍然係 work in progress,代碼、設定同文件都可能再改。倉庫已放出訓練資料格式線索,例如 train.parquet 需要 prompt 同 image 欄位,train_answer.parquetval_answer.parquet 用作 answer-conditioned validation;訓練則建基於繼承自 verl 嘅 GRPO/PPO 流程,VCSD 相關改動集中喺 verl/trainer/ppo/vcsd.pyverl/workers/actor/dp_actor.py 同 actor 設定檔,表示它比較似可插入現有 RL 訓練管線嘅附加目標,而唔係一套獨立框架。

  • 核心取向係用 visual contrast 代替 privileged answers 或 visual evidence
  • 學生模型學習嘅係 full-vocab KL 目標,唔係逐 token 手動加權
  • control input 可設成 black、degrade 或 noimg,用來測試答案有幾多真係靠圖像
  • 已公開結果顯示,VCSD 在 ViRL39K 上對 Qwen3-VL 與 Qwen3.5 系列均比 matched OPSD 更好

從已公開數字看,Qwen3-VL 在七個 benchmark aggregate 上由 2B 的 62.27 升到 67.04、4B 由 71.30 升到 73.16、8B 由 72.51 升到 76.26,方向相當清楚:它想改善嘅唔係推理時計算量,而係訓練期間點樣把「圖片真正提供咗乜嘢」變成更乾淨嘅監督訊號。對已經有 Vision-Language Models RL 訓練流程、又想減少外部 teacher 與額外標註依賴嘅研究團隊,呢個項目值得跟進;不過現階段仍要接受文件未齊、介面可能變動,以及結果主要來自論文與項目頁面披露。
項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Image, VLA, Robotic, 框架, Dataset 數據集

TableVerse 想補上機械臂數據缺口

想訓練更能適應雜亂桌面嘅機械臂,最缺的往往唔係模型,而係夠真實又夠大量嘅場景數據。TableVerse 用 Real2Sim 把網上圖片整理成可模擬環境,方向相當清晰。

TableVerse main figure

機械臂要學會喺凌亂桌面執放物件,卡位通常唔在控制器,而在訓練資料太乾淨、太想像化。TableVerse 屬於Dataset 數據集加上資料生成流程,重點不是再用文字幻想場景,而是用 Real2Sim 從網上真實圖片重建可放進模擬器的桌面配置,直接處理泛化操作最缺的場景真實感。

現有做法常見兩條路:text-to-layout hallucination,或者較簡化的 procedural generation。作者批評前者容易做出物理上唔合理的擺位,後者又捉唔到人類日常環境常見的密集雜物;因此 TableVerse 改成 deterministic reconstruction,從非結構化的 in-the-wild image data 還原具備 metric scales、authentic topologies 同 verified mechanical stability 的場景,取向明顯偏向可落地訓練,而唔係只追求合成速度。

項目現時最重要的成果是 TableVerse-100K,公開了 100,000 個 physically consistent 的桌面環境,並配對 interactive manipulation trajectories。網站資料顯示,它還接上自動化 task-conditioned trajectory generation,先由 MLLM 根據場景視角提出 object-to-target 配對,再生成 collision-free pick-and-place demonstrations,令數據不只得靜態場景,亦包含可直接餵給操作策略學習的示範。

  • 以真實圖片重建桌面,而非只靠生成式佈局
  • 提供 100K 場景與 pick-and-place 軌跡,規模夠大
  • 強調物理一致性、機械穩定性與模擬可用性
  • 適合做 generalizable manipulation 與桌面操作研究

部署角度上,這個 GitHub 儲存庫目前更接近論文與資料入口,主要連到 arXiv、HuggingFace dataset 同項目網站,未見完整訓練或評測程式公開。換句話說,研究團隊現階段較可能把它理解為高品質資料來源與方法參考,而不是即裝即跑的機械臂框架;對做 robotic manipulation、模擬訓練數據建構,或者研究 Real2Sim 流程的人,參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, Image, Robotic, Dataset 數據集

SeededGrasp 用自然語言指揮機械人精準抓取雜亂物件

面對一堆擺得亂的物件,只用一句文字指令就能幫機械人揀中目標。SeededGrasp把語意理解同抓取動作拆開處理,令多種夾爪更易落地。

SeededGrasp: Language-Guided Grasping in Complex Scenes with Multiple Embodiments teaser figure

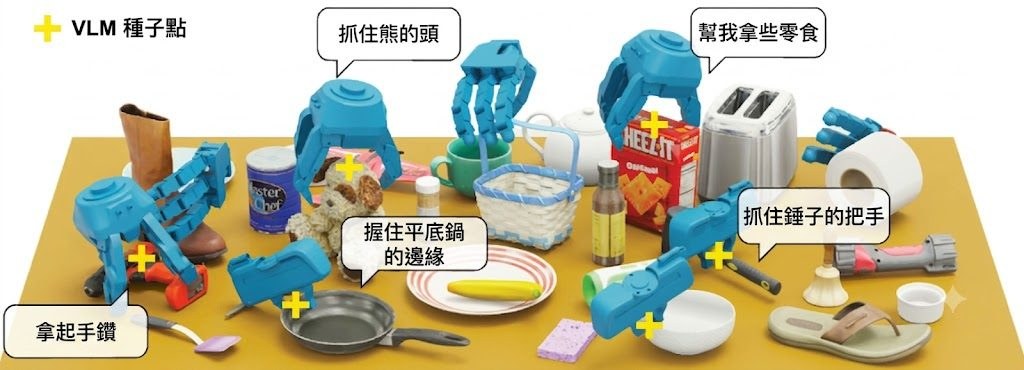
當桌面堆滿不同物件,機械人要聽得明「拎紅色杯旁邊嗰支筆」這類指令,難處不只在辨認物件,仲要同時算準 3D 空間位置同抓取角度。SeededGrasp 針對的正是這類語言引導抓取場景,重點不是端到端硬推整個動作,而是先找對目標,再生成穩定抓取姿態。

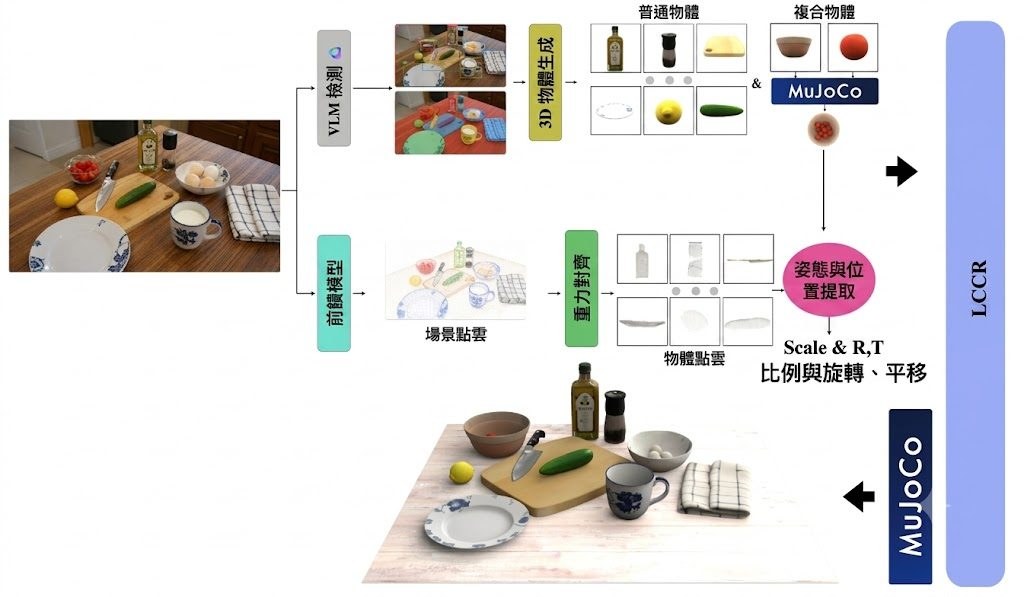
它的做法相當清晰:先用預訓練 Vision-Language Model(VLM)把文字指令轉成影像中的 2D 種子點,再投影到 3D 點雲,交給輕量的 flow-matching grasp model 產生 6DOF 抓取姿態。這種拆分方式把高層語意判斷同低層幾何執行分開,減少重新訓練整個系統的成本,也較容易支援多種 embodiment。

相比直接由 VLM 預測抓取,SeededGrasp 保留語言理解的直觀操作,同時補回空間推理不足;相比把 VLM 同抓取模型一併訓練,它對語言標註資料與算力的需求更克制。團隊亦公開多 embodiment 桌面抓取數據集,包含超過 2.56M 個 cluttered scenes 抓取姿態,涵蓋 Franka Panda、Allegro Hand 同 Robotiq 3-Finger。

  • 用簡單文字指令指定目標,適合雜亂桌面抓取情境
  • 以 2D 種子點連接 VLM 與 3D 抓取生成,降低端到端訓練負擔
  • 支援多種 embodiment,不限單一夾爪或手型
  • 公開 2.56M grasp dataset,補足多 embodiment 訓練資源
  • 模擬成功率達 72%,真實環境抓取實驗達 78%

對機械人操作、語言介面同 grasp planning 有興趣的讀者,會較容易感受到這個項目的價值:它沒有把所有問題塞進同一個大模型,而是用較節制的架構處理語意與幾何之間的落差。現階段重點仍在桌面雜亂場景抓取,但它已經展示出多 embodiment 擴展同資料效率上的實用方向。

項目主頁 · Paper

Categories: 視覺模型, 多模態模型, 模型訓練, Google, Robotic, 框架, 3D, Dataset 數據集

DocOps 直擊文件代理真功夫

文件代理唔止要答啱內容,仲要改得啱格式同結構。DocOps將評測焦點放回原生文件本身,較易看清代理係真識做事,定只係識講答案。

DocOps benchmark overview

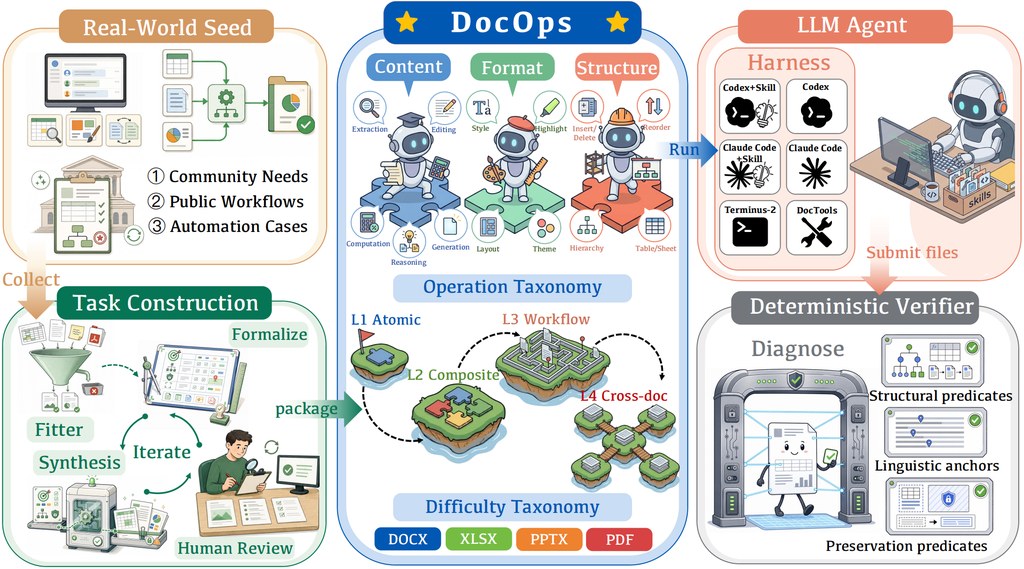
改 Excel、Word、PowerPoint 同 PDF,最難唔係生成一段合理回覆,而係交返一份可用、冇整爛結構的原生文件。DocOps屬於 benchmark 類型,針對 document-operation agents 而設,重點不是問答得分,而是檢查代理能否把文件改到指定狀態,同時保住公式、樣式、大綱、書籤與格式有效性。

現有評測常落在兩個範式:static document understanding 把文件當成唯讀材料做擷取或問答;workflow-oriented software evaluation 則把文件當成在應用程式之間流轉的附屬品。DocOps反過來把「文件本身」放回中心,用 Harbor 格式整理 210 個可執行任務,再用 deterministic artifact-level verifiers 直接驗最終檔案狀態,這種設計比只看可見文字更能捉到破壞性修改與狀態遺漏。

它的取向相當鮮明:不是追求聊天式流暢回覆,而是拆解 document manipulation 到 content、format、structure 三個維度,再按 L1 到 L4 拉開難度,涵蓋局部原子操作、同文件組合操作、單文件流程,到跨文件工作流程。對研究 agent 能否長步驟維持全局一致性的人來說,這個分層比單一總分更有診斷價值。

  • 收錄 210 個 Harbor tasks,覆蓋四種常見文件格式
  • 內建 deterministic verifiers,驗證原生檔案而非只看輸出文字
  • 提供 DocumentTools、Terminus-2、Codex、Claude Code 等 execution harnesses
  • 支援 skill-on / skill-off 評測,較易分辨工具能力與模型能力

這個 GitHub 項目已包 task、skills、harnesses 同 Docker base images,重點在重現 benchmark run,而不是單獨提供某個辦公自動化工具。現有結果亦說明門檻不低:例如 GPT-5.5 在不同 harness 的表現有明顯落差,Claude Sonnet 4.6、DeepSeek-V4-Pro 等模型亦未見接近滿分,反映文件操作代理距離穩定處理端到端工作仍有一段距離。對做 Agentic 評測、辦公自動化代理、或想比較 skill 與模型邊界的團隊而言,DocOps的參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, Robotic, 軟件, Anthropic, Meta, Dataset 數據集, 百度, Skill 技能

Wan Streamer v0.3:讓 AI 學懂「世界不變,只有事件在流動」

Wan Streamer v0.3 把影片拆成「持續存在的世界」和「持續發生的事件」,讓即時音視頻對話支援自由動作描述,延遲仍維持約 200ms。你可以把它理解成:一個會記得場景、然後跟著時間線即興演下去的 AI 對手。

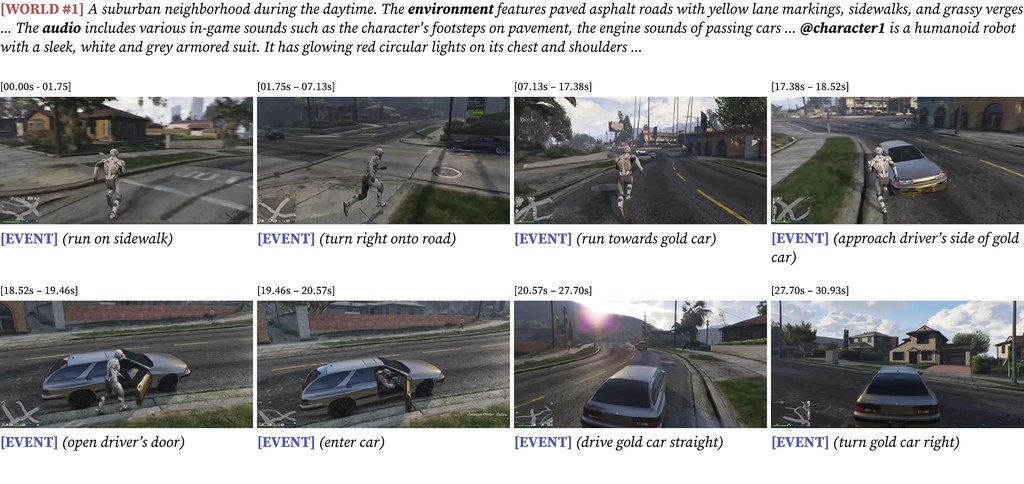
A robot navigates a suburban neighborhood and drives a car through a sequence of events

玩過 AI 影片對話工具的人都會發現一個矛盾:模型可以跟你聊天,但一旦想做動作,畫面就容易卡頓、失憶,甚至換了一張臉。Wan Streamer v0.3 想解決的就是這個問題——它把影片分成兩件事來學,一件是「世界設定」(場景、角色、畫風、聲音這些要長期保持一致的東西),另一件是「事件流」(說話、動作、鏡頭移動、環境變化這些隨時間發生的事)。

這個拆法聽起來抽象,但對使用者來說,最直接的差別就是角色終於可以做自然語言描述的動作了。你打開鏡頭,模型會一邊跟你說話,一邊伸手拿起眼前的物件、轉向聲音來源、或者露出驚訝的表情,而且動作和對嘴的時序是學出來的,不是後製對齊的。延遲仍然維持在約 200 毫秒,解析度 640×368、幀率 25fps,即時互動不會被打斷。

從工作流角度看,這個版本最大的價值是把普通影片變成訓練素材:先建立世界,再沿時間軸學接下來會發生什麼。同一套能力日後可以遷移到漫遊探索、機器人控制等場景,而這次發佈聚焦在即時音視頻對話。

重點摘要:

  • 拆解式學習:將「持續世界」與「事件流」分開建模,避免長對話中場景漂移
  • 自由動作描述:支援用自然語言寫出動作(如拿取物件、轉向、變換姿勢),並與對話同步渲染
  • 即時互動規格:640×368、25fps、約 200ms 模型側延遲,支援全雙工音視頻
  • 普通影片即訓練素材:不需特殊標註,現成影片就能用於學習時間軸上的因果事件
  • 可遷移架構:同一套預訓練能力可延伸至具身導航、漫遊等場景

對於做數位人、虛擬主播、互動敘事或即時陪聊的團隊,這個方向值得留意;對於只是想試試看的個人,現有 demo 已經足夠展示「角色真的在過日子,而不只是在回話」的差異。

項目主頁

Categories: 多模態模型, 世界模型, 模型訓練, Video, Audio, Robotic, 語音, Skill 技能

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

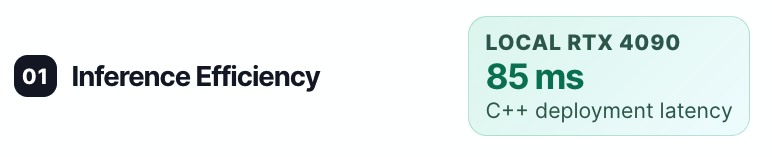
它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

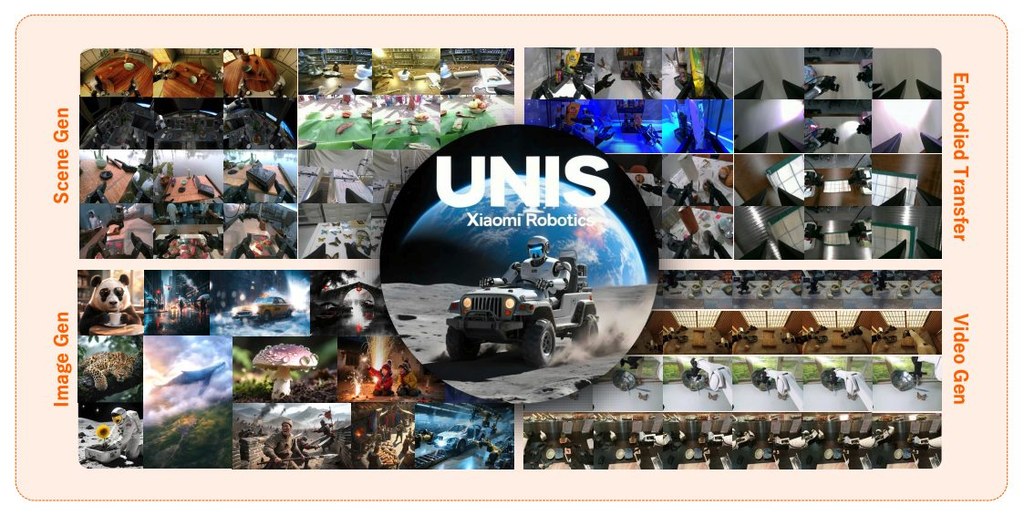
常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。

呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

EgoSteer:用第一身影片教機械人靈巧操作

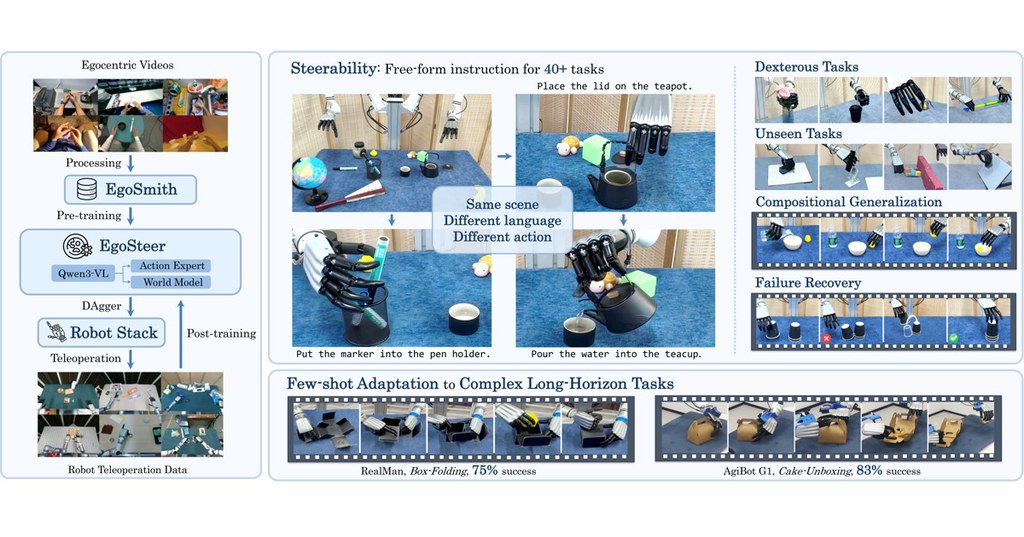
EgoSteer 讓機械人按自然語言調整動作,並以單一模型應付逾 40 種真實機械人任務。

Og image

面對不同物件與操作要求,機械人毋須為每項任務切換獨立模型。EgoSteer 結合第一身視角影片(Egocentric Videos)與自由形式語言指令,處理可控制的靈巧操作(Steerable Dexterous Manipulation)。

系統的核心取向,是讓使用者以日常語句改變機械人的操作方式,而不只觸發預先固定的動作。這種設計適合需要頻繁轉換物件、步驟或操作目標的機械人工作流程。

  • 單一模型支援超過 40 項真實機械人任務
  • 接受自由形式語言指令
  • 從第一身視角影片學習操作資訊
  • 重點在於按指令引導靈巧動作,而非只重播示範

相較每項任務各自訓練模型的常見做法,EgoSteer 着重跨任務共用能力,可減少模型切換帶來的流程負擔。現有資料未交代成功率、延遲、硬件配置及訓練數據規模,因此暫時未能判斷它在未見物件或全新環境中的穩定程度。

研究機械人模仿學習、人機協作或以語言控制操作流程的讀者,會較容易理解它的價值;其後仍需完整技術資料,才能評估部署成本與泛化能力。

項目主頁 · GitHub · 模型

Categories: 模型, 視覺模型, Robotic, Dataset 數據集

ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

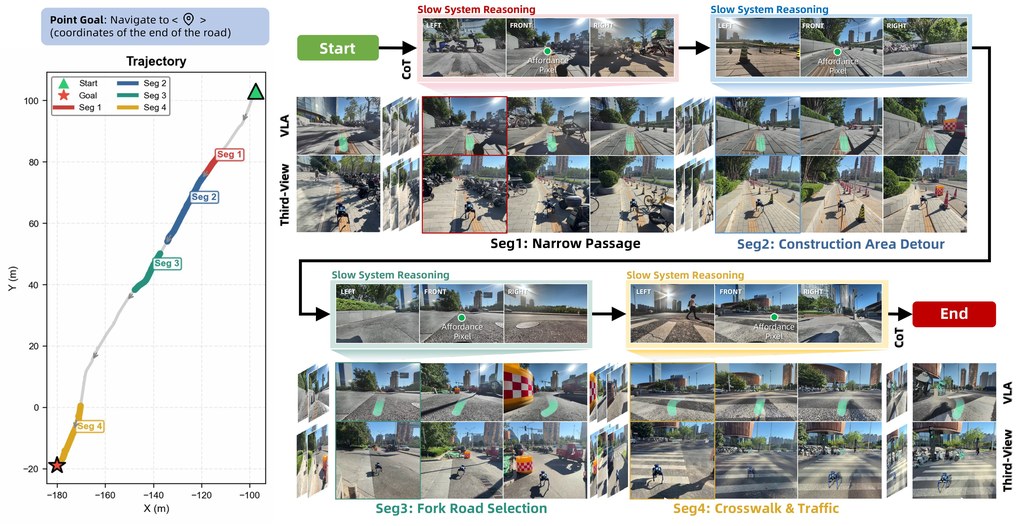
做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。

項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

RCORE 為什麼我打不開抽屜

同一個抽屜,模型可能只見到物件就判成「關上」。RCORE 針對這種偏差補上時序線索,重點不在多記類別,而是少走錯路。

RCORE teaser

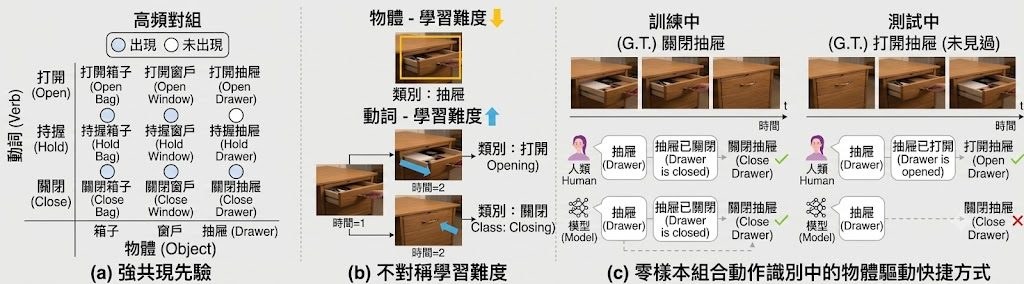
見到抽屜就猜「關上」、見到杯就猜「拿起」,正是 Zero-Shot Compositional Action Recognition (ZS-CAR) 最容易失手的位置。RCORE 是一個研究型模型項目,處理的是新 verb–object 組合辨識,核心不是再加更多標籤,而是壓低模型依賴物件類別走捷徑的傾向。

現有做法多數沿用已見過的共現關係去推斷動作,作者指出這種 fixed compositional supervision 會令模型把 object 當成近路,忽略影片中的 temporal evidence。RCORE 的回應很直接:用 CPR(Co-occurrence Prior Regularization)補足原本缺席的組合監督,同時把常見配對當成 hard negatives;再用 TORC(Temporal Order Regularization for Composition)迫使 verb 表徵對時間順序敏感,而不是學成靜態語意。

這個取向的價值,在於它不是單純追求更強 backbone,而是修正 ZS-CAR 的學習偏差。論文亦加入 FSP、FCP 與 Compositional Gap 這幾個診斷指標,不只看最後準確率,亦檢查模型是否真的較少受 co-occurrence patterns 牽引;已公開資訊指出,它在 Sth-com 與 EK100-com 都能改善 compositional generalization。

  • 重點放在減少 object-driven shortcuts,不是單靠物件猜動詞
  • CPR 針對訓練配對偏斜,TORC 針對時序線索不足
  • 準備 Python 3.10、requirements,以及特定 tokenizer 詞彙檔
  • InternVideo2 1B backbone 依賴 flash-attn,CLIP / InternVideo2-Base 則較易測試

部署與測試方式偏向研究流程:先安裝相依套件、準備資料,再跑 training 與 evaluation;它較適合做影片理解、組合泛化或 benchmark 分析的團隊,而不是即插即用的產品工具。相關模型與骨幹包括 CLIP、InternVideo2-Base、InternVideo2 1B;對於想研究模型為何會「看錯動作」的人,RCORE 比單看分數更有參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, Qwen, VLA, Robotic, Python, Dataset 數據集

Page 4 of 8
1 2 3 4 5 6 8