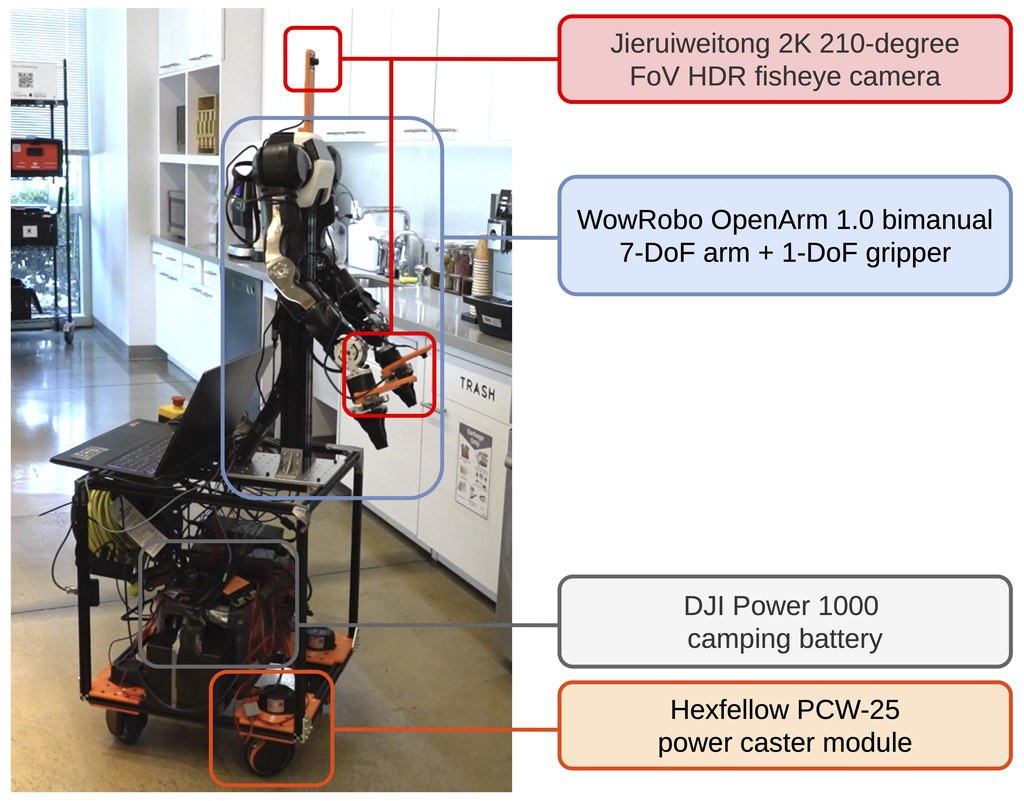
UME 可回饋力度的機械人遙操作外骨骼

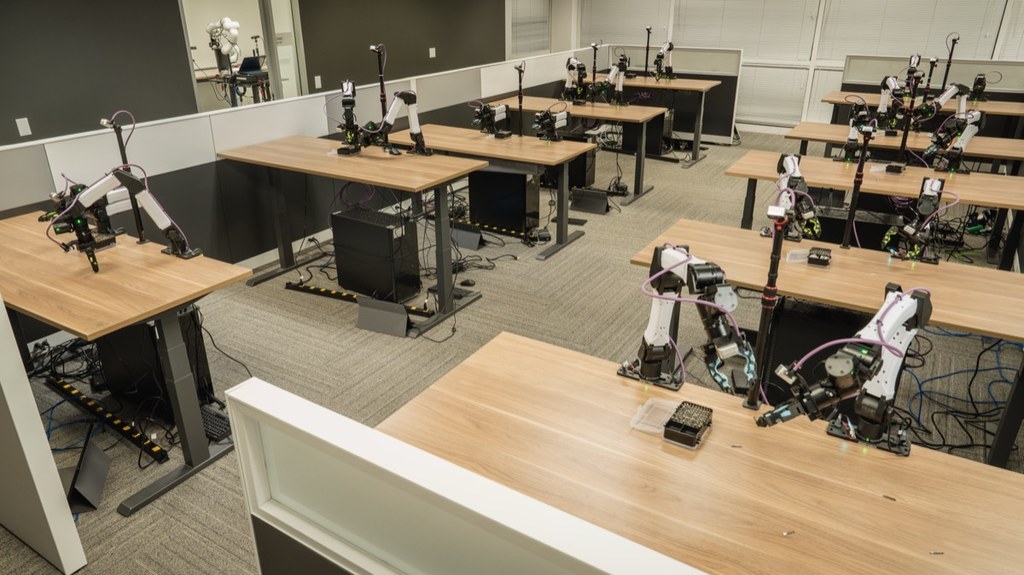
UME 讓人用手臂外骨骼遙控機械人,並即時感到扭力回饋。重點是把「接觸感」一併記錄,用來訓練更穩定的策略。

蚂蚁集团标志(英) 正色

Universal Manipulation Exoskeleton(UME)是一個上肢外骨骼遙操作項目,重點不只是在遠端控制機械人,更是在操作期間即時提供 haptic torque feedback,並同步記錄整條手臂姿態與關節 torque 訊號。頁面指出,它想解決的核心問題是:很多機械人示範數據流程只記到動作,卻記不到接觸時的力與扭力,令模型較難學會順應環境的 compliant 行為。

與常見只靠視覺或位置控制的做法相比,UME 把「人手感受到的阻力」直接帶回操作者身上。這種透明 torque feedback 令操作者即使蒙眼,也能完成例如抽出受運動限制物件這類任務;對需要接觸、擠壓、推動或在狹窄空間內調整角度的工作,差異尤其明顯。

UME 配備 embedded IMU,可支援 mobile manipulation,並配合 universal retargeting algorithm,把同一套操作映射到不同機械臂,包括 7DoF OpenArm、7DoF Franka 與 6DoF X-ARM。整套 UME system 成本為 1900 美元,詳細成本拆解可在論文中找到,這對研究團隊或自建實驗平台的人來說,是很實際的參考點。

  • 可記錄 whole-arm configurations 與 joint torque signals,用於訓練 active compliant policies
  • 支援 bimanual、whole-body 及 long-horizon mobile manipulation 任務
  • 已展示雪櫃取飲品、箱子翻轉、遮擋下推箱、狹窄桌面操作等情境
  • 頁面提供 Paper、Video,Code 標示為 coming soon,現階段較適合先理解方法與看示範

最受用的會是做 Robotic、teleoperation、模仿學習與機械人數據收集的人。性能方面,頁面以多個 autonomous policy 示範強調高成功率與抗干擾能力,亦有與 UMI、No-torque 設定的比較,但若要判斷完整指標、成本細節與評測方式,仍需回到論文原文核實。
項目主頁: https://ume-exo.github.io/

Paper: https://arxiv.org/pdf/2606.14218

Categories: 開源, Robotic, 框架

MolmoMotion 把語言變成 3D 動作預測

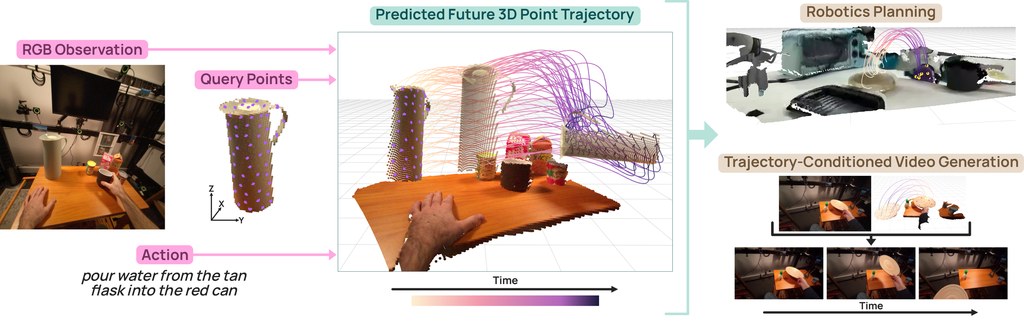
這是一個會按文字指令預測物件未來移動路徑的 4B 視覺語言模型,也連同資料集與基準一併公開。

MolmoMotion teaser

現有做法多數偏向追蹤已經發生的移動,或者只在 2D 畫面估計下一步位置;作者認為這種 retrospective 範式難以支援機械人規劃與可控影片生成,所以提出 MolmoMotion、MolmoMotion-1M 同 PointMotionBench,把問題改成「根據語言指令預測 3D 點位未來軌跡」。這不是單純看影片理解內容,而是要模型根據短段 RGB 歷史、2D query points、初始 3D 位置,以及文字動作描述,預測之後約 2 秒的 3D movement。

MolmoMotion 本身屬於模型,更準確地說是 4B vision-language model,處理的是物件上指定點會怎樣移動的預測問題。儲存庫目前公開的是 autoregressive (AR) variant,並提供訓練資料、評測集、已釋出模型,以及由 pretrain 到 long-horizon finetune 的兩階段流程,較適合研究團隊直接重現結果或改成自家任務。

和同類方法相比,這個項目的取向很鮮明:它不是先做一般影片理解,再另外接 motion head,而是把 language-guided 3D point trajectory forecasting 當成核心任務。代價是輸入要求較多,你要有 query points 同初始 3D 資訊;回報則是輸出更貼近規劃用途,特別適合要預測「物件將會點樣郁」而不是只想分類場景的人。

  • 可預測最長約 2 秒未來軌跡,文件提到 15 fps、F=30 或 F=32 的設定
  • 評測指標列出 ADE、FDE、PWT,焦點放在軌跡準確度而非只看畫面相似度
  • 配套包含 MolmoMotion-1M 訓練資料集與 PointMotionBench 評測基準
  • 作者指出學到的 motion prior 可轉移到 robotics planning 與 motion-guided video generation

部署與測試的理解方式相當直接:先下載模型、資料集或 benchmark,再按儲存庫提供的 evaluation 與 training 流程執行;若不打算重訓,較合理是先拿已釋出模型跑 PointMotionBench 或自家樣本,看看語言指令改變時,3D 點位預測是否穩定。現有資訊未見完整效能數字摘錄,但官方明確聲稱表現明顯優於既有 forecasting 方法;較保守的判斷是,它最適合 embodied AI、robotics、可控影片生成研究者,以及需要把語言意圖轉成未來運動假設的團隊。

相關模型與資源包括:MolmoMotion、其 autoregressive (AR) variant、MolmoMotion-1M、PointMotionBench;底層 backbone 初始化與從零訓練入口亦有提供。

GitHub: https://github.com/allenai/molmo-motion

項目主頁: https://allenai.org/blog/molmo-motion

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Robotic, IDE, 3D, , Dataset 數據集

ENPIRE : NVIDIA 閉環系統訓練機械人自我改良

ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。

NVIDIA

ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。

系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。

列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。

若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。

  • 核心價值:把真實機械人訓練流程標準化,減少人手介入
  • 主要差異:不是只生成策略,而是連同驗證、重設、改良一起自動執行
  • 適合讀者:機械人研究者、Agentic AI 開發者、關心自動化實驗流程的人
  • 已提方法:heuristic learning、tool calling、behavior cloning、offline RL、online RL

這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。

項目: https://research.nvidia.com/labs/gear/enpire/

Categories: 開源, Agentic, 模型, 模型訓練, NVIDIA, Robotic, 框架, Vibe Coding, Clone, 編程

AdaVoMP 讓 3D 場景有可互動物理材質

AdaVoMP 會為 3D 物件補上物理材質資料,令模擬更真實,亦更高解像與省記憶體。

Og image

不少 3D 資產只有外形,欠缺 Young’s modulus(E)、Poisson’s ratio(ν)同 density(ρ)等物理資料,結果做模擬時只係「睇落似」,但受力、變形同碰撞未必可信。AdaVoMP 就係針對呢個缺口,為輸入 3D 物件預測高密度、空間可變的物理屬性場,令數碼世界更接近可互動、可模擬的狀態。

同前一代 VoMP v1 比,AdaVoMP 的重點唔止係更清晰,而係改用 sparse and adaptive voxel structure(SAV)同 sparse transformer encoder-decoder,將固定體素表示換成可自適應結構。頁面指出,它可生成高出 16^3 倍解析度的屬性場,亦支援 test-time 調整解析度,兼顧準確度、記憶體效率同細節保留。

AdaVoMP short video [ICML 26]

AdaVoMP 展示咗幾種直接可理解的用途,例如將 Gaussian Splat + mesh 場景轉成可互動世界、為純 mesh 或 gaussian splats 場景做較真實的物理模擬,以及配合 RoboLab 與 Isaac Sim 建立機械人測試環境。對做 robotics、simulation、數碼孿生,或者想將 NeRF、Gaussian Splat 資產變成可操作場景的人,呢類流程會特別有參考價值。

  • 補回 3D 資產常見缺失的物理材質資訊
  • 比 VoMP v1 提供更高解析度與可縮放輸出
  • 同時支援 mesh、Gaussian Splat 等不同表示
  • 可用於 Isaac Sim 機械人基準測試與互動場景建立

從頁面資料看,AdaVoMP 亦有同 NeRF2Physics、PUGS、Phys4DGen、Pixie、VoMP 及 Ground Truth 作視覺比較,重點放在 physics material fields 的品質。若要自行測試,查看 Code 同 Model/Data,再留意它在自己場景表示、模擬器同資產格式上的接入成本。

項目: https://research.nvidia.com/labs/sil/projects/adavomp/

Categories: 開源, 模型, NVIDIA, Robotic, 3D

ImageWAM 用圖片編輯做機械人決策

ImageWAM把世界動作模型改成圖片編輯思路,嘗試避開影片生成的高成本。對機械人控制研究者來說,這個方向幾有啟發性。

Repository image for yuyangalin/ImageWAM

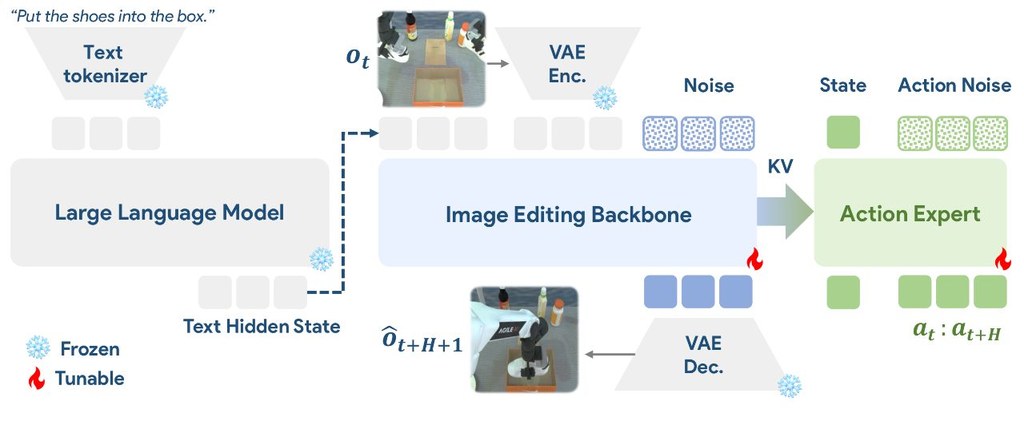
ImageWAM 是一個模型訓練與評測項目,核心目標是用 image-editing foundation models 取代傳統 World Action Models (WAMs) 常見的影片生成流程,處理機械人動作預測又慢又重的問題。它的判斷很鮮明:與其生成一段未來畫面,不如直接從「當前影像 + 指令」抽取足夠的動作線索。

這項目把圖片編輯模型的中間表徵拿來做 robot action prediction。根據項目頁資料,ImageWAM 推論時不一定要解碼出編輯後影像,而是使用單次 image editing forward step 產生的 KV caches,再交給 action expert 生成未來動作,方向上比多幀影片預測更輕量。

先看 FLUX.2 ImageWAM,因為倉庫已表明它是主力版本,並提供 4B 與 9B 變體。之後再按手上資料與算力,準備本地 datasets、pretrained weights、ActionDiT 初始化權重,然後在 LIBERO、LIBERO-plus 或 RoboTwin 這幾個基準環境做訓練與評測。

這個方向不只是概念實驗。項目頁列出 RoboTwin 2.0 為 93.38%、LIBERO 為 98.4%、LIBERO-Plus 為 83.1%,並提到可節省 4.1× FLOPs、推論延遲加速 84.7%。這些數字很吸引,但始終以作者公開的實驗設定為準,若換成不同機械人平台或資料分布,表現仍要再驗證。

  • 支援多個相關模型:FLUX.2 ImageWAM、OmniGen2 ImageWAM、Ovis-U1 ImageWAM
  • FLUX.2 提供 4B9B 版本,Ovis-U1 走較細模型路線
  • 適合機械人控制、world modeling、action prediction 研究與基準測試
  • 重點不是生成漂亮畫面,而是抽取對動作決策有用的變化資訊

整體來看,ImageWAM 不算面向一般用家的 AI 工具,更像給研究者與工程團隊驗證新路線的開源項目。若你關心 world action models 是否一定要靠影片生成,這個項目提供了一個相當具體,而且有基準成績支持的反例。

GitHub: https://github.com/yuyangalin/ImageWAM

項目: https://zhangwenyao1.github.io/ImageWAM/

Categories: 開源, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 影像模型, 影像處理, Robotic, 工具, , Dataset 數據集

RATs 用多代理玩出機械人技能庫

RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

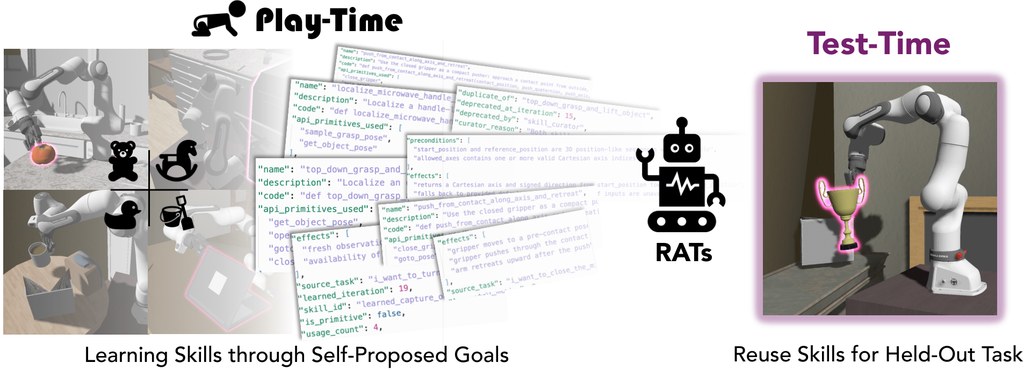
現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda

GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, , Skill 技能

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

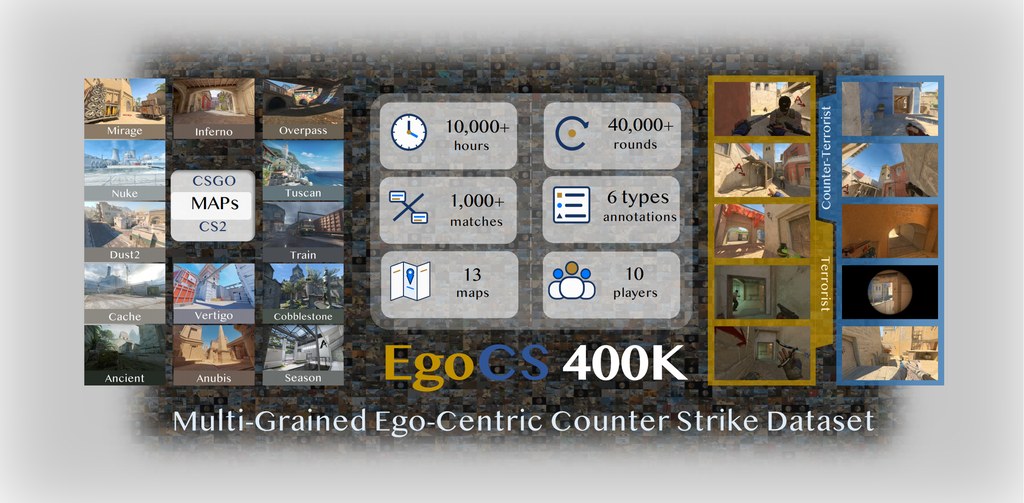
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, , 動畫, Dataset 數據集

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

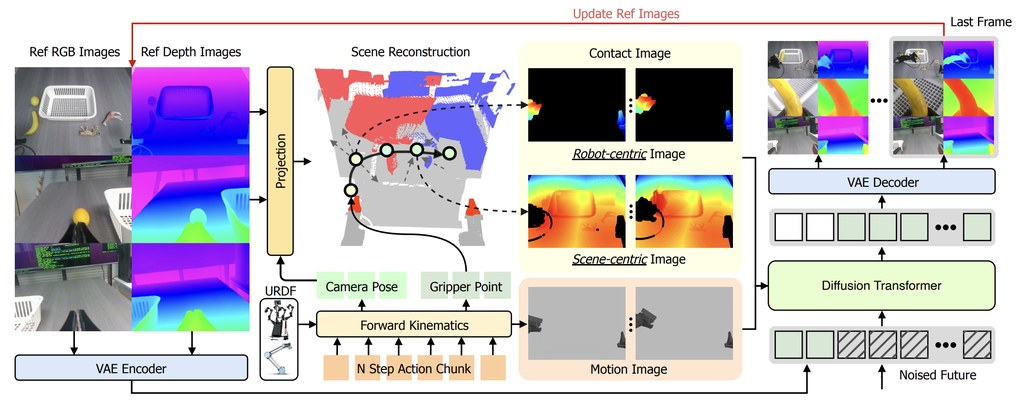
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, , 編程, Win

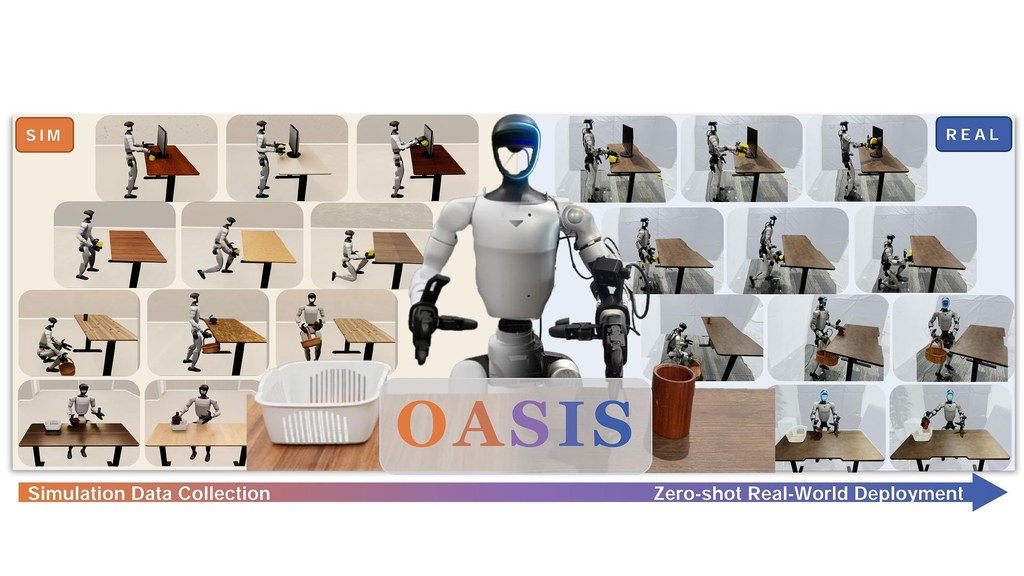
OASIS:模擬訓練、部署人形機器人框架

OASIS 是一套針對 Unitree G1 人形機器人的模擬數據收集與視覺運動策略框架,主打零樣本真機遷移。

Cover

OASIS(Simulation Data Collection to Real-World Humanoid Loco-Manipulation)由中國電信 TeleAI 等機構開源,目標是讓人形機器人的「移動+操作」(loco-manipulation)策略,靠模擬數據訓練後就能直接搬到 Unitree G1 真機執行,省去費時的真機遙操作。

整個流程有三個核心階段。先用 3D 生成模型把真實物品影像重建為可用的 3D 資產;接著透過 PICO VR 頭盔搭配 Isaac Lab v2.1.0 進行沉浸式遙操作收集示範數據,過程中 PICO 會即時接收頭部相機畫面,X、Y、A、B 鍵分別負責錄影、停止、重置、視角切換,板機與握把可控制夾爪開合;最後在 replay 階段加入多樣化的光照與環境隨機化,並訓練層次化視覺運動策略(hierarchical visuomotor policy)。

論文結果指出,在零樣本(zero-shot)部署下,純模擬數據訓練的策略在大多數任務的成功率,反而高於用真機遙操作數據訓練的版本,主要原因是模擬能涵蓋真機難以拍攝的光照與環境變化。團隊也展示了一鍵重啟的故障恢復機制,解決真機跌倒後需要人工搬運、重置場景的痛點。

OASIS: From Simulation Data Collection to Real-World Humanoid Loco-Manipulation

幾個重點摘要:

  • 項目定位:模擬數據驅動的人形機器人 loco-manipulation 框架,並非通用 LLM 或多模態模型
  • 創新處:以 3D 生成模型重建資產,加上後處理階段的 domain randomization,解決模擬到真機的差距
  • 相關模型/組件:Unitree G1 人形機器人、Isaac Lab 模擬器、PICO VR、PICO SDK、GMR、XRoboToolkit
  • 硬體要求:PC 必須安裝 Ubuntu 22.04,PICO 須與 PC 處於同一網段
  • 適用場景:研究 humanoid 移動操作、想用模擬取代部分真機遙操作成本、Unitree G1 開發者

適合機器人研究團隊、人形機器人開發者,以及想嘗試 sim-to-real 路線的人。不過整套環境對 VR 設備與 Linux 版本要求嚴格,純 Windows 或 Mac 用戶門檻偏高,建議先評估手上硬體是否到位再投入。

GitHub: https://github.com/TeleHuman/OASIS

Paper: https://arxiv.org/pdf/2606.08548

Categories: 開源, Robotic, 框架

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

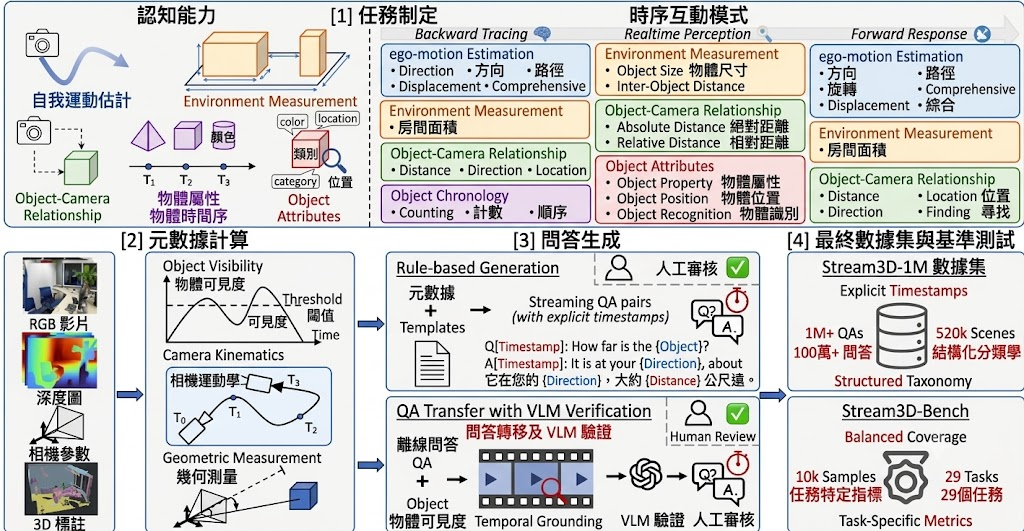
Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

Page 7 of 8
1 5 6 7 8