WorldCrafter 記住你走過的世界

WorldCrafter把單張圖片或文字提示變成可操控鏡頭的連續場景,改善長時間探索時畫面失憶與視角不一致的問題。

鏡頭移開再回望時,生成場景仍能維持空間關係,正是 WorldCrafter 要處理的核心卡位。它屬於影片世界模型,能從單張圖片或文字提示建立可探索場景,並按照鏡頭控制生成後續畫面,減少長時間移動、回訪視角時的內容漂移。

WorldCrafter以可由鏡頭查詢的隱式 3D-aware memory 保存過往觀察,讓指定視角決定哪些歷史資訊交給影片生成器;記憶編碼器與姿態條件讀取模組會把不同視角的資料整理成目標視角適用的 memory tokens。它不依賴顯式深度估計或幾何 warping,近期 temporal context則負責維持動態物件和連續動作。

WorldCrafter Video Demo

提供 WorldCrafter-Base,以及經蒸餾、面向較快推理的 WorldCrafter-Fast。兩者可在 Linux、Python 3.11、NVIDIA GPU 和相容 CUDA 驅動環境運行,模型權重放在 Hugging Face;Fast 版本較適合互動式串流,但硬件要求和生成速度仍取決於本地配置。

  • 支援圖片轉可探索世界,也支援文字轉可探索世界
  • 可控制鏡頭、揭示未見區域,並回到曾經觀察的視角
  • 設計同時兼顧靜態場景、動態場景和長時間探索
  • 評測涵蓋145個場景及725條鏡頭軌跡

評測中,WorldCrafter在長時間回訪一致性和鏡頭控制準確度上優於參與比較的基線,整體 VBench 分數亦最高;項目展示的點雲與鏡頭軌跡重建,則用來檢查生成影片的幾何連貫性。研究團隊來自 Tencent ARC Lab 與北京大學,較適合研究生成式世界模型、可控影片、虛擬場景探索及互動內容的團隊測試。
項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 騰訊, AI productions, 模型, 世界模型, NVIDIA, Video, Image, 3D, Linux, Dataset 數據集

RefineEdit : 免訓練 Prompt-to-Prompt 編修

RefineEdit 以文字提示生成來源與編輯結果,毋須額外訓練或遮罩,但未能直接處理任意真實照片。

compare

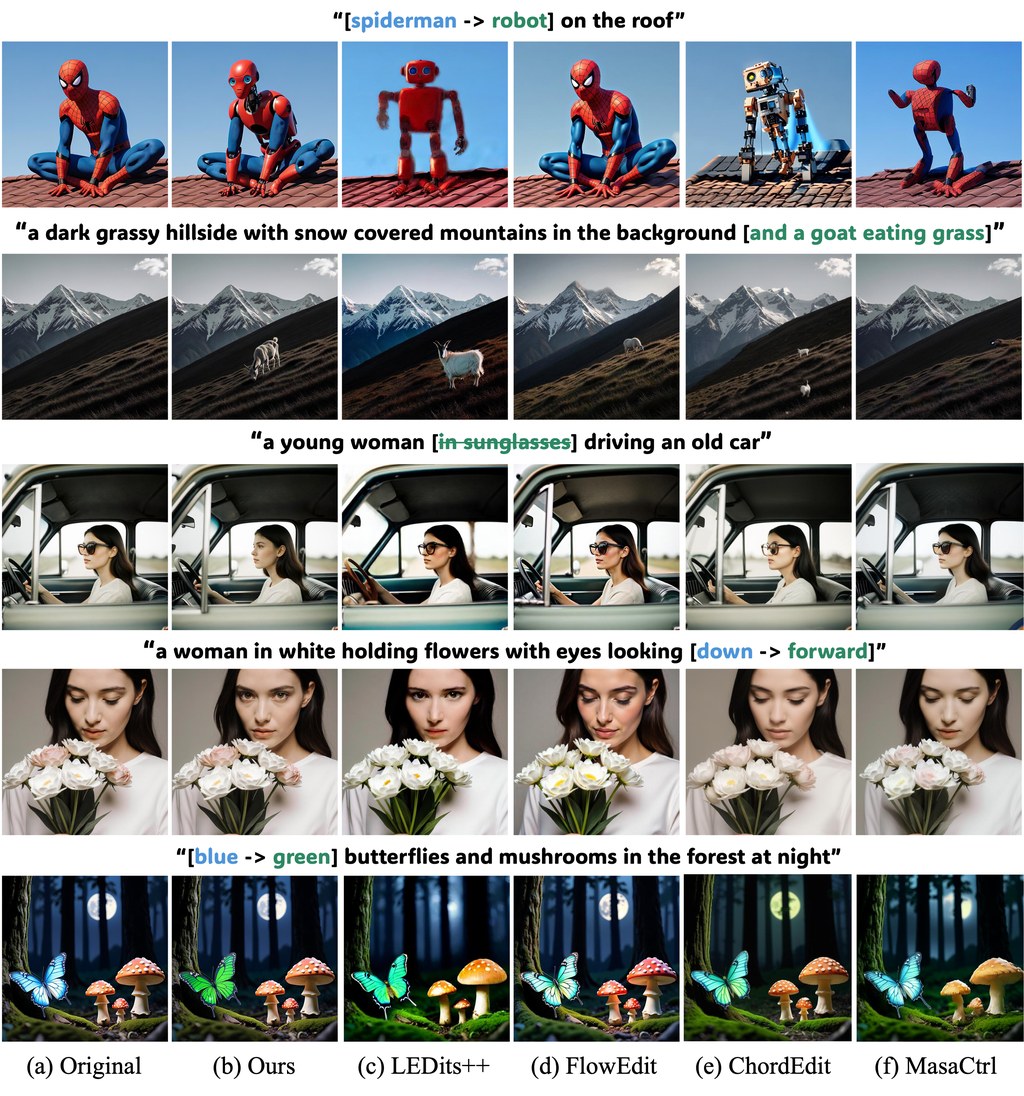
由 source prompt 改成 editing prompt 時,RefineEdit 會先生成來源圖,再重用中間 refinement state,讓 1024 × 1024 編輯結果較容易保留原有內容。這個項目屬於免訓練的 prompt-to-prompt 影像編輯方法,實際處理的是文字驅動編輯中「改變指定內容」與「維持畫面穩定」之間的取捨。

GRN 負責生成流程,HBQ tokenizer 和 UMT5 encoder 會一同載入;RefineEdit 本身沒有額外 checkpoint。source-anchored bit routing 先選出可編輯座標,再配合 adaptive spatial freezing(AdaSF)及 finite bit locking(FBL)限制後續變化,毋須外部 editing mask。

RefineEdit 需要 Linux、支援 BF16 的 CUDA GPU,以及官方 GRN 預訓練權重;A100 80 GB 是參考配置,項目並不適合低記憶體 GPU 或 CPU 推理。FlashAttention 2 可加速原始流程,未能安裝時可改用 PyTorch scaled dot-product attention,但速度、記憶體消耗和數值結果都可能不同。

  • 不需額外訓練、RefineEdit checkpoint 或外部遮罩
  • 只支援由提示詞內部生成的來源 refinement trajectory
  • 不直接編輯任意真實圖片,應用範圍比一般照片編輯流程窄
  • 附有 mask summary/step PNG 及 adaptive bit lock stats.csv,方便檢查座標選擇和鎖定狀態

它適合研究文字生成影像編輯、需要可重現實驗的團隊,以及已有 GRN 推理環境的開發者。儲存庫未提供統一 benchmark 數字,不能單靠 1024 × 1024 輸出判斷畫質;不同 attention backend 即使使用相同 seed,也不保證產生逐像素一致的結果。

GitHub

Categories: 開源, 模型訓練, NVIDIA, Image, 提示詞, Linux, Python, 庫, Dataset 數據集

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

XGEN-JING 世界模型開源:邊走邊生成影片與音效

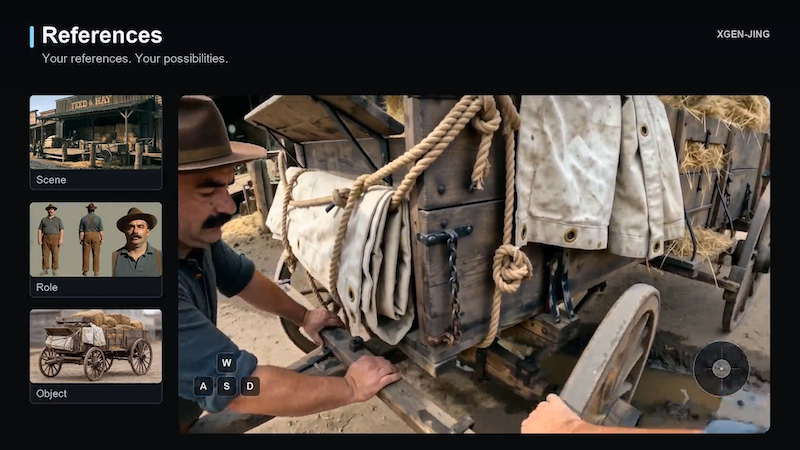
XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

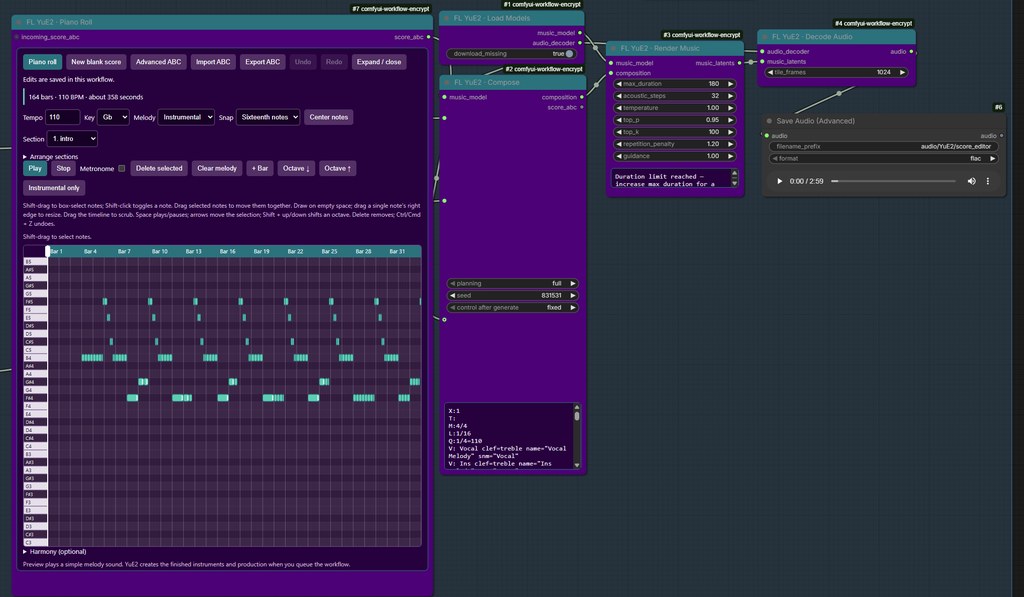
ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

ComfyUI-DLSS5-Enhancer:強化影片材質細節

直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。

適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。

GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

pipeline

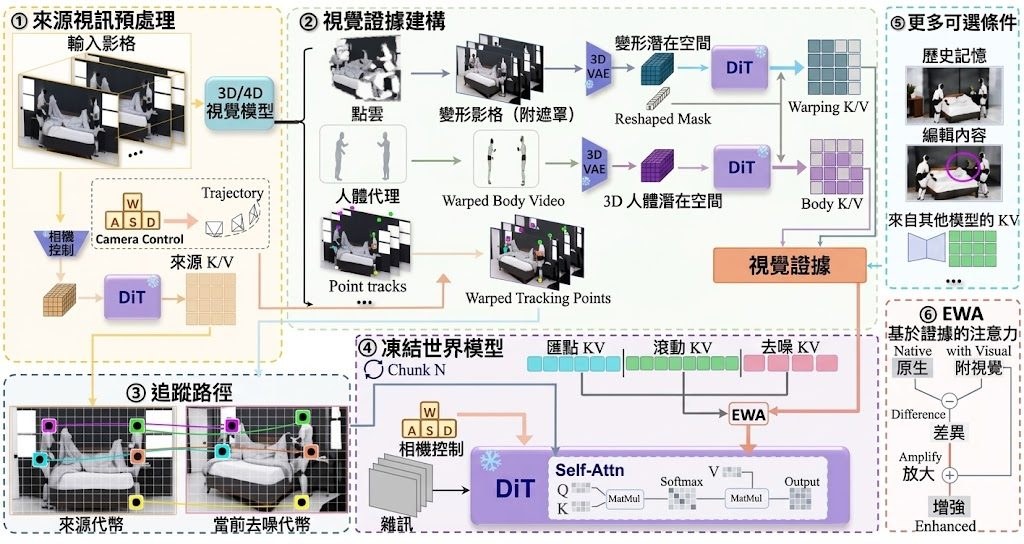
對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

Edge0 開源框架:Mac 本機推論 35B MoE,記憶體僅佔用 2.9 GB

Edge0 是一套開源串流 MoE 推論框架,靠 SSD 專家卸載搭配 LoRA 還原與前置路由器,在 Apple Silicon 上把 35B 等級的 MoE 模型壓到 2.9 GB 活動記憶體就能跑,對想在筆電本機玩大型稀疏模型的人來說是個務實的選擇。

edge0

MoE 模型參數規模愈推愈大,但真正能在消費級硬體本機跑得動的方案一直不多。Edge0 想處理的就是這個落差:它把 SSD 專家卸載、Recover-LoRA 還原、以及 prerouter 路由預測這三招組合成一套可擴展框架,目前以 MLX 後端跑在 Apple Silicon(M1 至 M4)上,CUDA 後端列在路線圖但尚未支援。

隨框架釋出兩個模型檔:edge0-35b(基於 Qwen3.5-MoE 35B-A3B)與 edge0-8b(基於 Ling 3.0 bailing 混合架構),皆以 4-bit 量化釋出。LoRA 配重與 prerouter 頭已隨 checkpoint 一同發佈,edge0 serve 即可直接載入訓練好的完整管線,不用額外拼湊組件。短上下文情境下,edge0-35b 峰值活動記憶體約 2.9 GB,edge0-8b 約 1.0 GB;專家權重以 mmap 方式按需讀取,不會預先佔用 RAM。

TierReleased checkpointInference profile
edge0-35bEdge0/Edge0-35B-A3B-preview4-bit, 40 layers, 256 experts, prerouter K=4
edge0-8bEdge0/Edge0-8B-A1B-preview4-bit, 24 layers, 128 experts, prerouter K=8

使用介面提供 AutoModel、AutoConfig、AutoEngine 自動按模型名稱解析層級。所有 MLX 程式碼集中在 edge0/backends/mlx/,核心邏輯只依賴抽象層,因此日後加入 CUDA 等後端時不必重寫調度邏輯。

  • 類型:開源 MoE 推論框架(搭配兩個預訓練 checkpoint)。
  • 資源門檻:4-bit 35B 模型約 23 GB 磁碟、2.9 GB 活動記憶體;8B 模型約 4.2 GB 磁碟、1.0 GB 活動記憶體。
  • 硬體限制:目前僅支援 macOS Apple Silicon,CUDA 仍在規劃中。
  • 目標用戶:想在 M 系列 MacBook 上本機試跑大型稀疏模型的研究者、開發者,以及對 VRAM 不夠、又不願完全依賴雲端推論的團隊。
  • 差異化:相較純量化或純卸載方案,Edge0 把 prerouter 預測與 LoRA 還原包進同一條管線,讓卸載後的精度損失有明確補償路徑。

Edge0 屬於「先把本地大型 MoE 跑起來」這個務實路線上的工具,限制也很清楚:必須在 Apple Silicon 上跑、長上下文 KV 會額外吃記憶體、目前沒有非 Apple 平台的後端可用。對想驗證稀疏模型在消費硬體可行性的人,這套框架省去了自行整合卸載與適配器還原的功夫;對 NVIDIA 用戶,則要等 CUDA 後端落地。

GitHub

Categories: 開源, 模型, Qwen, NVIDIA, 框架, 工具, Mac, 蘋果

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorld、yyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

Page 7 of 17
1 … 5 6 7 8 9 … 17