NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

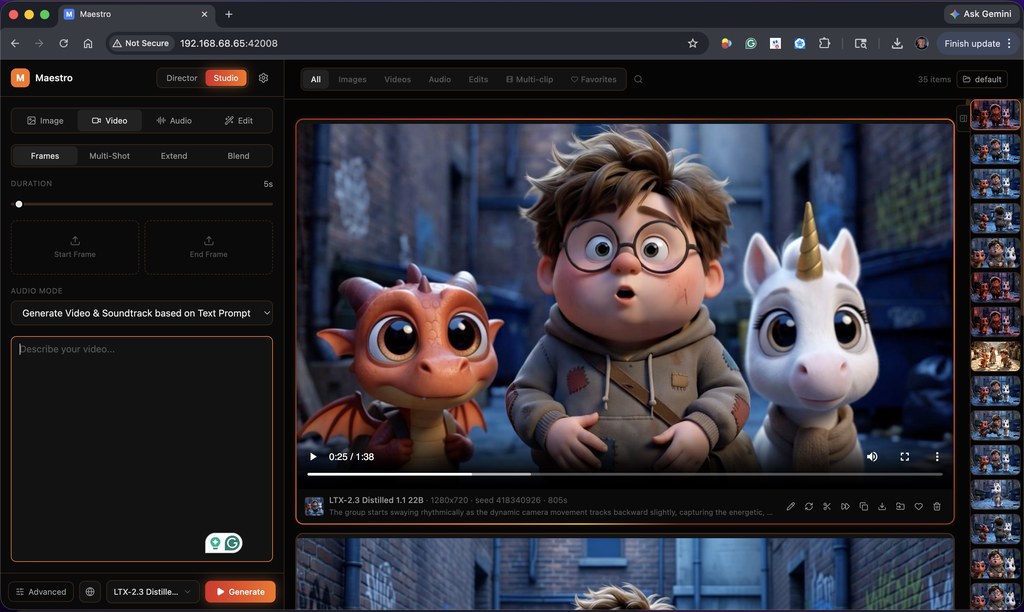
Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

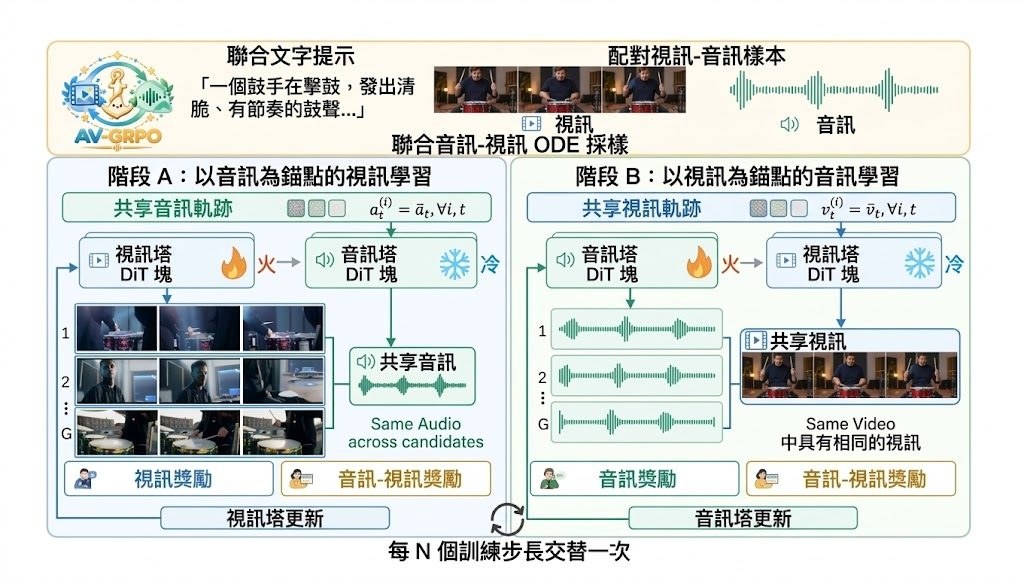
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

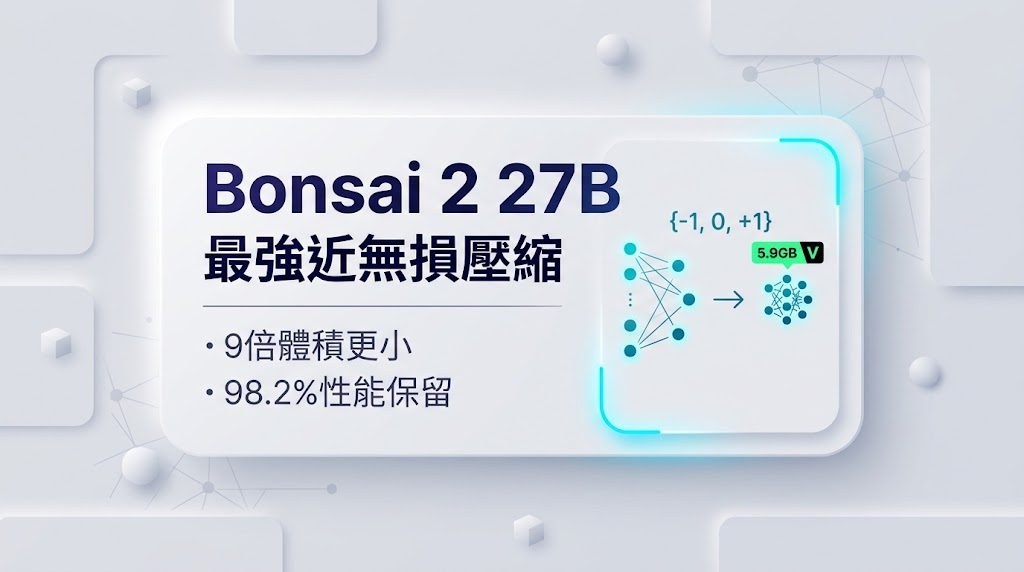
Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

LTX-2.5 加入多圖與聲音參考控制

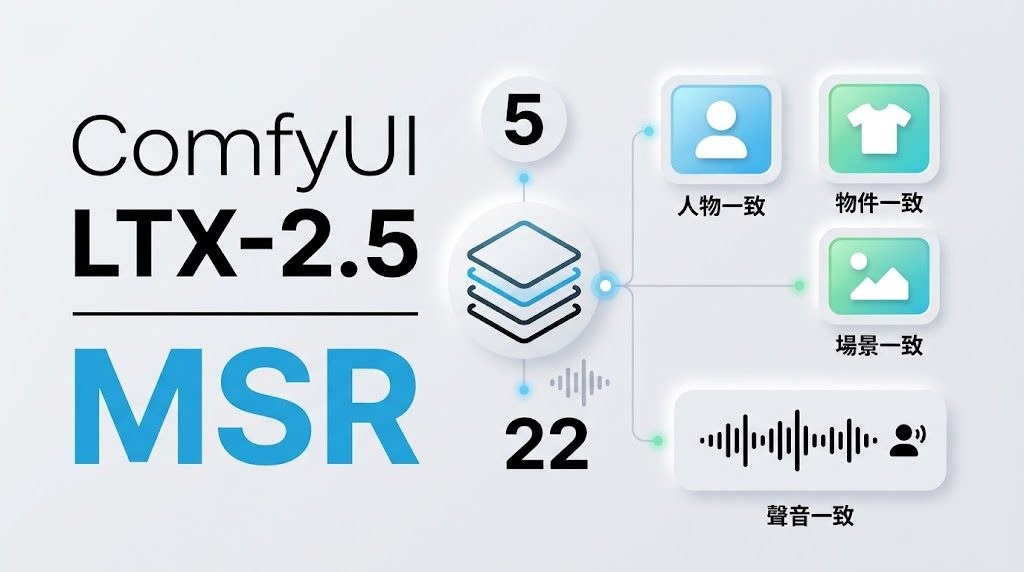
想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

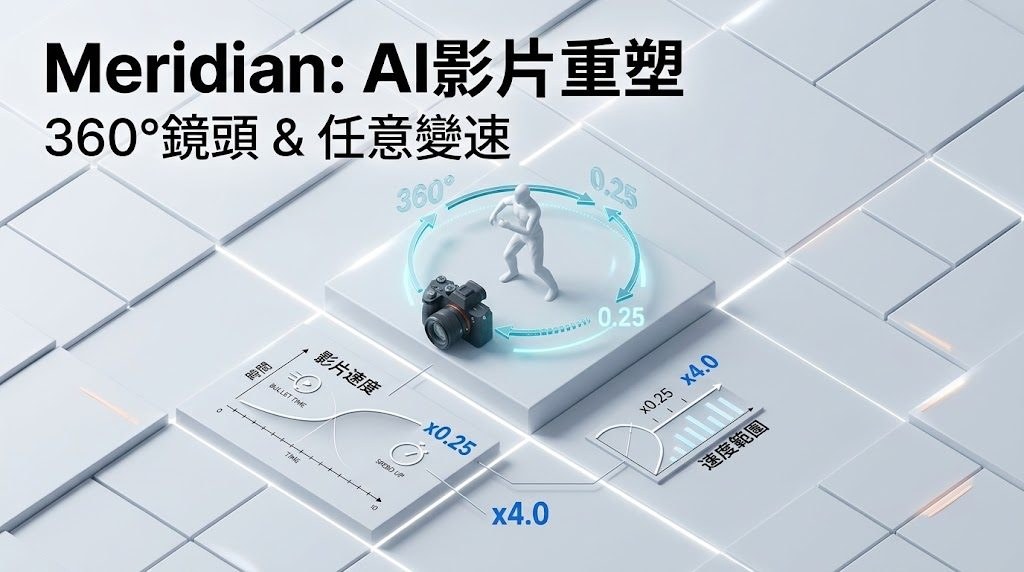
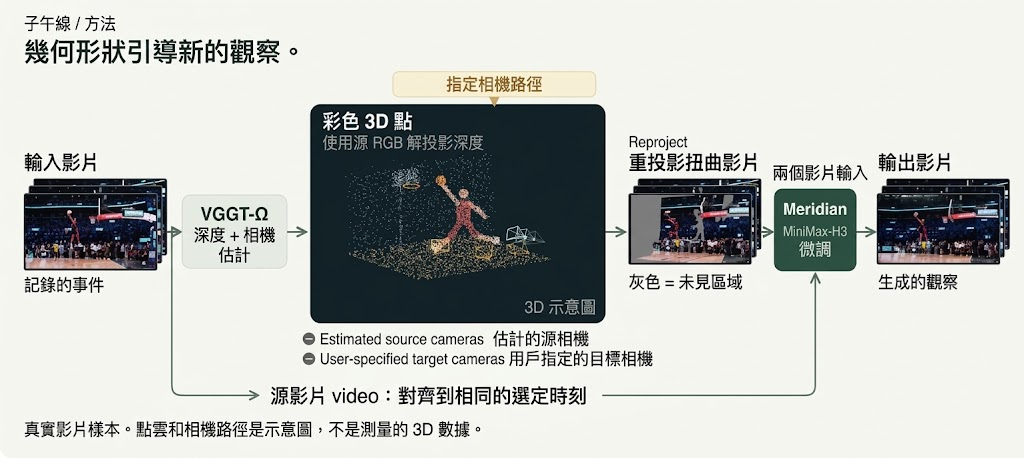
Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

ImIR 免提示詞處理六類影像修復,

ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

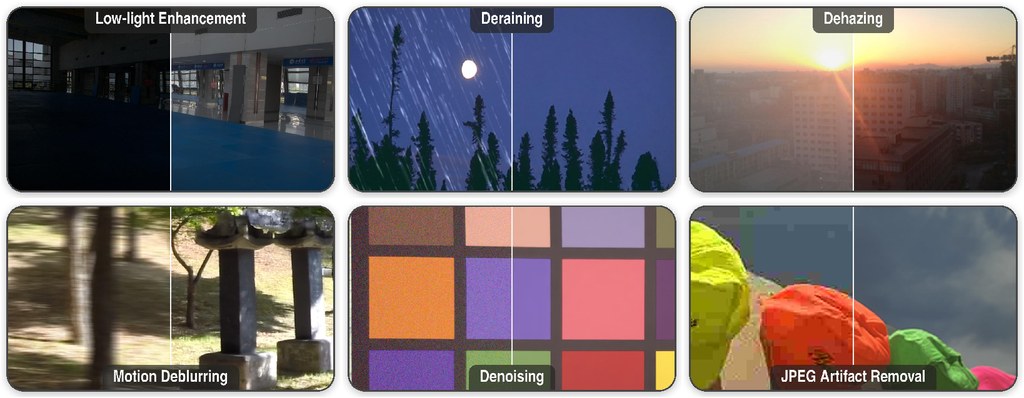
ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

Page 6 of 17
1 … 4 5 6 7 8 … 17