Sol-Attn:免訓練稀疏注意力 影片生成加速達 2.1 倍

Sol-Attn 用一套即時運作的稀疏注意力機制,讓預訓練好的影片與圖像生成模型無須重新訓練,就能跑得更快兼保留畫質。對本地部署或自建生成管線的人來說,等於多了一個現成的加速選項。

Og image

影片生成模型愈來愈強,但推理速度依然是開發者和創作團隊最常卡住的地方。NVIDIA Research 提出的 Sol-Attn,正正針對這個矛盾:它把「訓練用嘅成本」同「推理時嘅效率」分開處理,讓預訓練模型無須重新訓練就可以直接加速。

Sol-Attn 屬於免訓練(training-free)嘅稀疏注意力機制,做法是動態計算一個 query 相關嘅閾值,即場篩走低貢獻嘅注意力區塊,同時把未選中嘅分數重用做近似補償,整個過程喺一次 online-softmax 內完成。換句話講,它毋須事先計好一張路由表,亦唔會直接丟棄被跳過嘅區塊,因此能保留長尾分佈對最終畫面嘅影響。

喺 Wan 2.1、Hunyuan 1.5、LTX 2.3、Bernini 等多個主流模型上,Sol-Attn 都做到約 2 倍嘅速度提升,同時畫質幾乎唔受影響。若配合 Sol-Engine 中其他加速技巧,仲可以推到 5 倍嘅端到端加速。對於要跑長影片、做後製編輯,或者本地有限顯示卡環境嘅使用者來說,呢個幅度算係幾實用嘅改進。

對比以往「離線先揀一次、再丟棄」嘅做法,Sol-Attn 最大嘅差異在於即場判斷同重用機制。讀者如果本身就喺度搵方法縮短生成等待時間,又唔想額外花資源微調模型,呢套方案值得留意。

項目主頁 · GitHub

Categories: 視頻模型, 模型訓練, NVIDIA, Video, Image, LTX

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

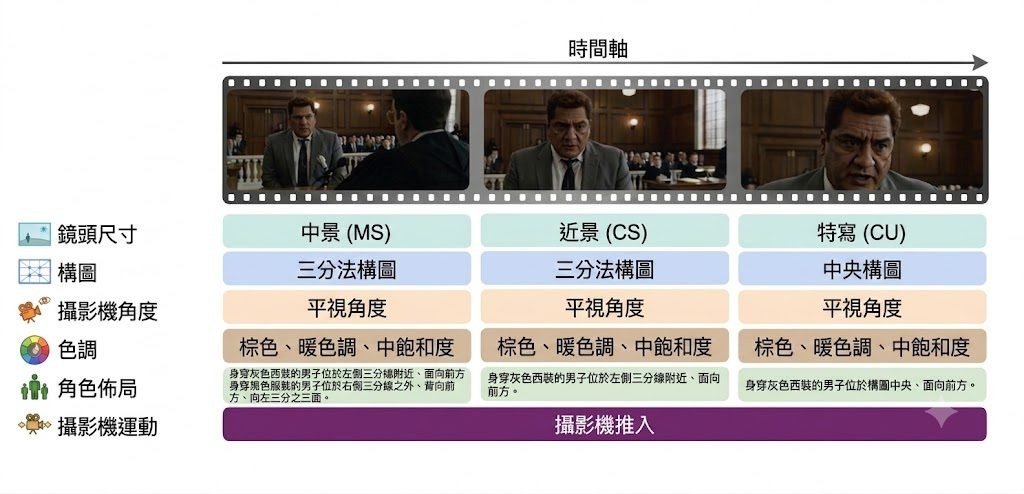
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

GraphVid 把圖生影片拆解成圖節點關係圖

GraphVid 用一張關係圖重新組織影片生成流程,讓畫面之間的動作轉折更像被刻意安排,而非逐格拼湊。

Og image

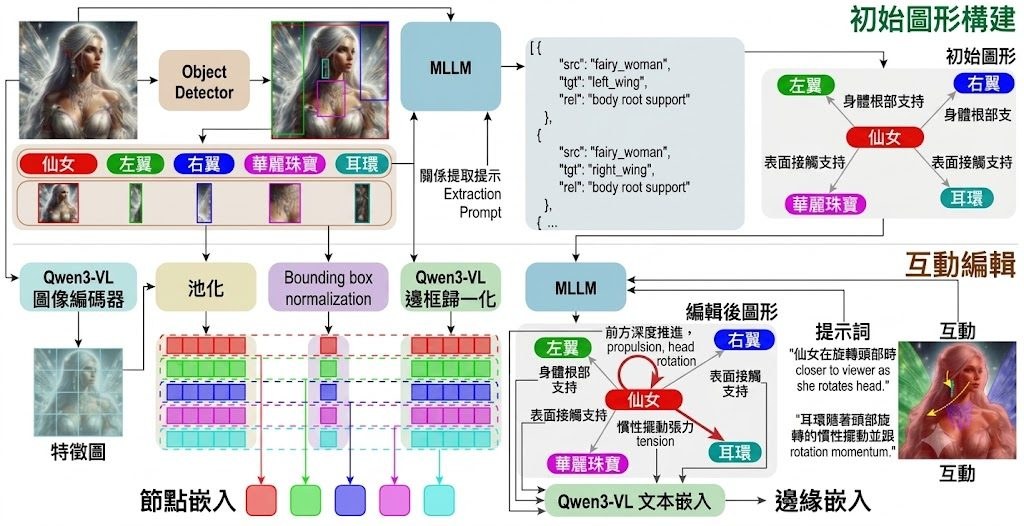
PLAN-Lab(伊利諾伊大學厄巴納-香檳分校)開源的 GraphVid 採用 Diffusers 框架,用 Stable Diffusion 類的 Diffusion Pipeline 配 bfloat16 精度載入,適用於 CUDA 與 Apple MPS 裝置。這個名稱裡的「Graph」不是社群網絡圖,而是把影片拆成多個關鍵畫面節點,再用一張小型關係檔 graph.pth(約 118 MB)描述節點之間如何銜接——模型先理解這些畫面該怎樣排序與過渡,再交由 transformer、VAE 等模組逐段生成。

頁面沒有公開 base model 來源,也沒有說明訓練資料或評測指標,因此難以判斷它的整體品質,只能從架構面推測它把控制粒度從「逐幀文字描述」轉移到「節點拓樸」。使用 DiffusionPipeline.from_pretrained 配合 torch_dtype=torch.bfloat16,屬於現今影片擴散模型常見的省記憶體做法。

從模型卡提供的程式碼範例可見,GraphVid 直接接受文字 prompt 即可生成畫面,毋須手動編排節點,這層抽象對一般使用者比較友善;進階用家則可透過 graph.pth 微調節點關係,控制運鏡節奏。整個 gvc_ckpt_folder 容量約 64.3 GB,包含 scheduler、text_encoder、tokenizer、transformer、VAE 等標準組件,搭配 Hugging Face 提供的 Colab / Kaggle 範例即可快速試跑。

  • 關係圖驅動:以 graph.pth 定義畫面節點與時序關係,再交由擴散模型生成影片。
  • Diffusers 相容:透過 DiffusionPipeline 載入,支援 bfloat16 與 CUDA / MPS。
  • Apache-2.0 授權:可自由下載研究與再分發,但頁面未提供量化版本。
  • 硬體需求高:完整 checkpoint 約 64.3 GB,建議使用高階 GPU。
  • 缺乏評測數據:原始頁面沒有提供基準分數或與其他影片模型的直接比較,採用前宜自行測試。

若以本地消費級 GPU 試跑,建議先把 torch_dtype 設為 bfloat16,並留意 VRAM 是否足以容納 transformer 與 VAE 的權重;想進一步壓縮,可留意社群後續是否釋出量化或 LoRA 版本。

項目主頁

Categories: 開源, Google, NVIDIA, Stable Diffusion, Image, 框架, 教學, Python, 蘋果

eeg-difflogic:邊緣 EEG 分類改用邏輯電路

這個項目把 EEG 分類從浮點神經網絡,轉向可直接編譯成布林電路的 Diff-Logic。你可以把它理解成一種更貼近邊緣裝置限制的做法,重點放在低延遲與記憶體壓力。

Workflow for EEG classification using differentiable logic gate networks

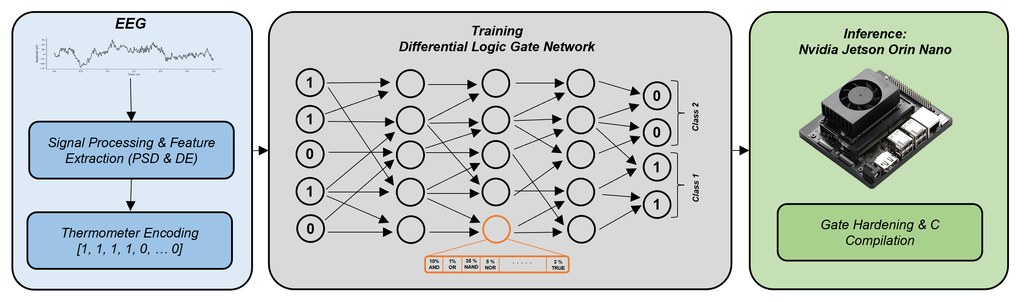
這份項目對準的是要在邊緣裝置即時分析 EEG 的場景,核心矛盾很直接:傳統神經網絡雖然準,但浮點運算和記憶體開銷會拖慢部署。它屬於研究型工具/框架,處理的是把 Differentiable Logic Gate Networks (Diff-Logic) 用在 EEG 分類,並在推理階段編譯成 Boolean circuits,以 bitwise CPU operations 跑得更輕。

作者同時看了兩類任務:臨床失智分類與情緒辨識。前者用 Power Spectral Density (PSD),後者用 Differential Entropy (DE),再配合 fold-wise Min-Max normalization、thermometer encoding 和多層 differentiable logic gates,最後把學到的 soft gates 硬化成可執行的布林電路。

和 Multi-Layer Perceptrons (MLPs) 及 Binarized Neural Networks (BNNs) 比起來,這個項目不追求單純堆大模型,而是用 iso-parameter evaluation 去看同等參數量下的表現與效率。論文報告在 dementia screening 上 Diff-Logic 拿到 80.2% Macro F1,較 MLP 高 6.8%;在 emotion recognition 上 MLP 準度略有優勢,但部署到 NVIDIA Jetson Orin Nano 單核心 CPU 時,延遲高 2.3 倍、模型體積大 14 倍。

  • 推理路徑清楚:先訓練,再轉成 Boolean circuits 做 inference
  • 適合關心低延遲、低記憶體、能在 edge device 跑的 EEG 系統
  • 評測覆蓋 CN vs. AD、CN vs. FTD,以及三類情緒辨識資料集
  • 在較大規模下,Diff-Logic 的推理時間幾乎保持不變
  • 這個項目最有價值的地方,不在於取代所有 EEG 模型,而是在資源受限環境下提供另一條更貼近硬件的路線

GitHub · Paper

Categories: 開源, 模型, NVIDIA, 框架, Medical醫學, Dataset 數據集

CrisperWhisper 把語音逐字稿變成可控制輸出

同一段錄音,可以要逐字保留停頓與口吃,也可以要乾淨可讀版本。CrisperWhisper 把語音辨識最常混在一起的兩種需求分開處理。

Repository image for nyrahealth/CrisperWhisper

做會議紀錄、訪談整理或臨床語音分析時,最大落差往往唔係辨識到幾多字,而係系統究竟寫出「講咗乜」定「本來想表達乜」。CrisperWhisper 屬於開源語音辨識模型項目,核心價值係將 verbatim 同 intended 兩種轉錄模式變成可明確控制的輸出,令逐字稿唔再受訓練資料風格左右。

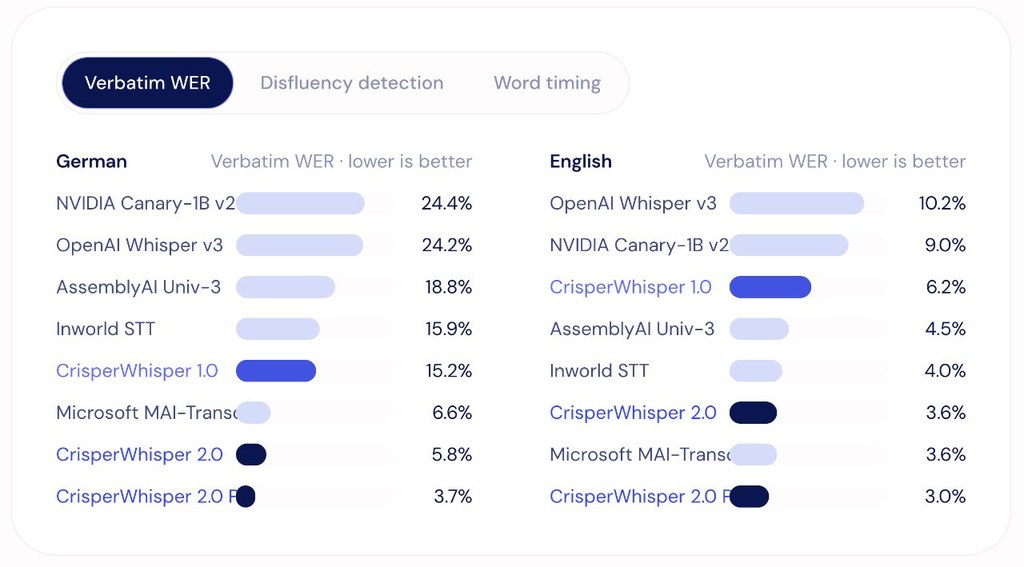
呢個取向同一般 speech-to-text 系統好唔同。常見做法會不一致地刪走 filler、重複、停頓同 cut-off,CrisperWhisper 2.0 就刻意保留呢啲語音細節,或者按需要輸出整理後版本;同一段錄音可以得出兩份用途完全不同嘅文本。對做 TTS 資料整理、醫療或研究訪談分析、需要精準字幕時間碼嘅團隊,呢種分流比單純追求可讀性更有用。

項目另一個關鍵位係時間對齊同長音訊處理。它提供 word-level timings,讀稿語音平均邊界誤差約 30 ms,對話語音約 41 ms;長音訊則用 conditional continuation 避免一般分段轉錄常見嘅重複漏字。README 亦提到推理端基於 CTranslate2,配合 speculative decoding,同時減輕 Whisper 常見 looping-hallucination 問題,方向明顯係朝住 production inference。

  • verbatim 與 intended 兩種模式分開控制,適合同一錄音對應不同工作流
  • 支援 multilingual,覆蓋多數 Whisper 支援語言
  • 可用 Verbatimize 依據音訊加乾淨文本補回真實語氣詞與口誤
  • 長音訊轉錄著重連續性,減少 chunk 邊界造成嘅錯漏
  • Nyra Verbatim Speech Benchmark 以 disfluency F1 等指標衡量保真能力

安裝與部署方向相對清晰:模型可經 PyPI、Hugging Face 同文件使用,推理路線圍繞 CTranslate2 runtime,而唔係只停留喺研究展示。要留意嘅取捨亦好直接,當你要的是可讀、可發布文本,intended 模式更合適;當你要保留猶豫、重複、笑聲同語音事件,verbatim 模式先真正發揮價值。呢個項目唔係單靠更高 WER 成績去吸引人,而係重新界定逐字稿應否忠於說話表面形式,並且用 benchmark 將呢件事量化。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, NVIDIA, Medical醫學, 語音, Dataset 數據集

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

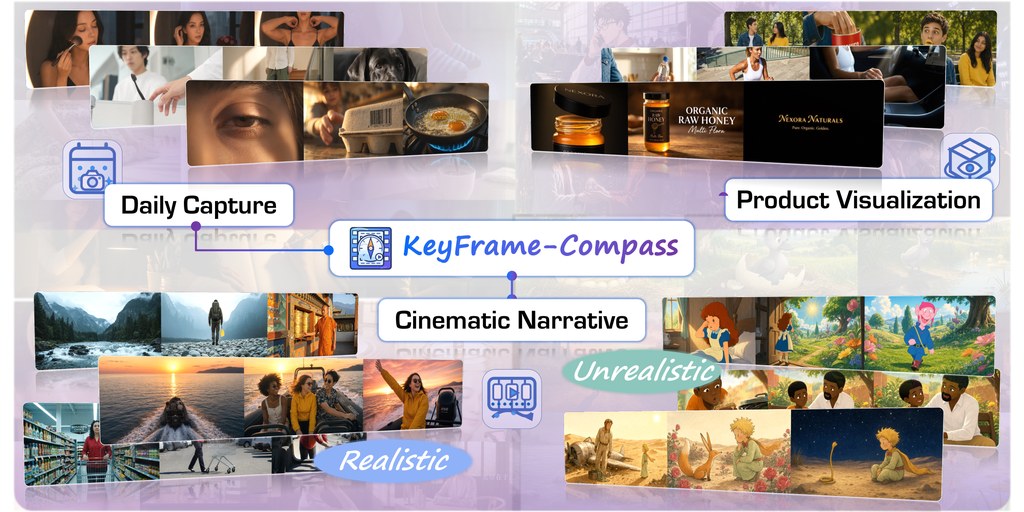
KeyFrame-Compass benchmark domains and examples

KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envsassetsall 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

MedPMC 把醫學圖文資料做成可訓練基座

想做醫學影像與文字理解,卡位通常唔係模型,而係乾淨又夠大的圖文配對。MedPMC 把這件事連同訓練流程一併開放,方向相當務實。

Repository image for Yale-BIDS-Chen-Lab/MedPMC

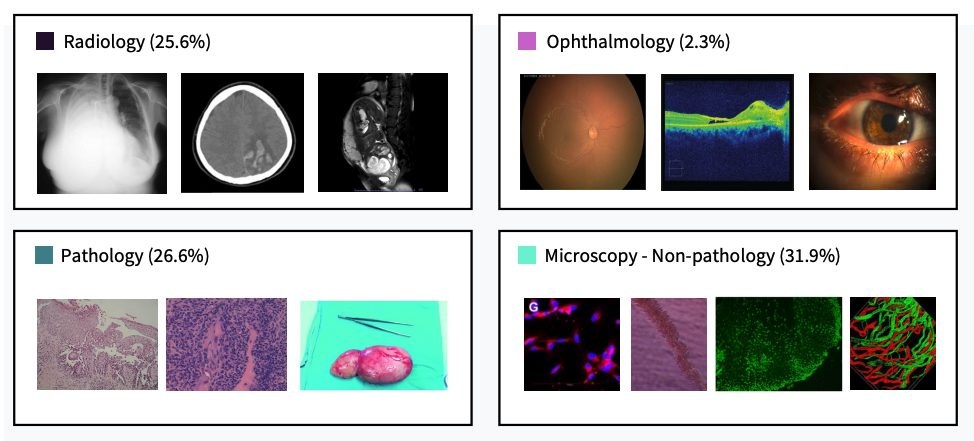
做醫學多模態模型,最難往往不是再堆一個新架構,而是先整理到可用的圖文資料。MedPMC 屬於Dataset 數據集加模型訓練程式碼項目,核心價值是把 PubMed Central (PMC) 文獻中的醫學圖片與文字抽取、清理,再接上訓練與評估流程,處理的是醫學 vision-language 資源長期分散、難重現的問題。

目前最值得留意的是 MedPMC Dataset 首個版本,提供約 1,100 萬組 medical image-text pairs;同時亦有基於 MedPMC-11M 訓練的 MedPMC-CLIP。這種做法與不少只放模型權重、或只交出資料連結的項目不同,它把 dataset curation、preprocessing、model training、evaluation 放在同一個代碼庫,較適合研究團隊沿住同一條流程再做微調或重跑實驗。

部署與測試的理解方式很直接:資料集與模型都已放到 Hugging Face,現階段較像給研究者先下載資料、檢查抽樣品質、再接入自家訓練管線。README 未提供很完整的操作文件,dataset viewer 亦未必可直接預覽,所以短期內它比較偏向有 Python 與資料處理能力的團隊,而不是即開即用的線上服務。

  • 約 1,100 萬組來自 PMC 的醫學圖文配對,是項目現時最重要資產
  • 連同 MedPMC-CLIP 一併釋出,方便由資料走到模型驗證
  • 重點不在花巧介面,而在可重現的資料整理與訓練流程
  • 文件仍在補完中,benchmarks 與更多 training recipes 尚待發布

以現有資訊看,MedPMC 的強項是規模與研究流程整合,限制則是文件與基準結果仍未齊備,暫時較難單靠公開頁面判斷模型表現上限。對醫學 AI、視覺模型、RAG 前處理,或需要建立醫學圖文檢索基座的團隊來說,這個開源項目已有不錯參考價值;相關模型現時可確認的是 MedPMC-CLIP

項目主頁 · GitHub · 模型

Categories: 開源, RAG, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Image, Medical醫學, Python, Dataset 數據集

ReChannel:用生成模型做密集預測

同一張圖直接讀出深度、法線、去背甚至文字指向分割,ReChannel把 text-to-image 模型變成實用視覺讀取器。它吸引人的地方,不在於加大模型,而是幾乎只靠輕量 LoRA 與線性頭完成轉向。

demo

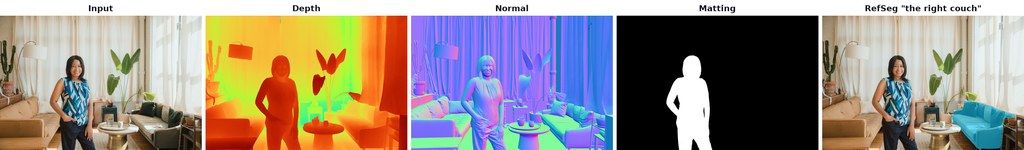
一張 RGB 圖像想同時拿到深度、surface normal、matting 同 referring segmentation,通常意味住要換幾套模型;ReChannel偏偏反其道而行,將預訓練 text-to-image DiT 的空間 token 直接改作密集預測讀出。這不是完整訓練流程釋出,而是偏向 inference/質性展示的 GitHub 項目,定位很清楚:展示 FLUX-Klein 骨幹除咗生圖,亦可以做 pixel-space dense prediction。

它的類型更接近研究型模型讀出方法+推理示範工具,實際解決的是「可否沿用生成模型已有的空間表示,避免為每個密集任務重建一套重型解碼器」。做法上,骨幹維持 frozen,只為每個任務加 LoRA,再配一個 token-local linear head;標量任務頭部大約 33K 參數,surface normals 約 99K,沒有 convolution、沒有 upsampling,也沒有 target-side VAE decoder。

同類方法很多會把功夫放在額外解碼器或多尺度結構,ReChannel的取向剛好相反:盡量把空間結構留在 DiT token field 內,最後只做通道重映射。這種設計夠輕,但取捨亦直接,現有儲存庫沒有完整 benchmark pipeline,姿態估計亦未放入最小示範,所以更適合用來理解方法潛力,而非直接拿來做嚴格橫向比較。
  • 支援單張圖片推理,可輸出 depth、normal、matting、refseg,refseg 需要輸入文字描述
  • 依賴 CUDA GPU,首次執行會自動下載 black-forest-labs/FLUX.2-klein-base-4B 與對應 LoRA、線性頭權重
  • depth、normal、matting 會保留長寬比並可用 horizontal-flip TTA;refseg 固定在 512² 單次前向
  • 已公開的是 demo/inference 版本,不是論文表格所用的完整評測流程

受益最大的人,會是研究 dense prediction、生成模型再利用、或者想測試 LoRA 能否把同一骨幹轉成多任務視覺讀出的團隊。相關模型核心是 black-forest-labs/FLUX.2-klein-base-4B,再疊加每任務 LoRA adapters;對想研究生成模型表示能否外借到視覺理解工序的人,這個項目相當值得留意。

GitHub

Categories: 開源, 香港科技大學, NVIDIA, Stable Diffusion, Image, 影像處理, txt2img, Dataset 數據集

Page 5 of 11
1 3 4 5 6 7 11