AdaVoMP 讓 3D 場景有可互動物理材質

AdaVoMP 會為 3D 物件補上物理材質資料,令模擬更真實,亦更高解像與省記憶體。

Og image

不少 3D 資產只有外形,欠缺 Young’s modulus(E)、Poisson’s ratio(ν)同 density(ρ)等物理資料,結果做模擬時只係「睇落似」,但受力、變形同碰撞未必可信。AdaVoMP 就係針對呢個缺口,為輸入 3D 物件預測高密度、空間可變的物理屬性場,令數碼世界更接近可互動、可模擬的狀態。

同前一代 VoMP v1 比,AdaVoMP 的重點唔止係更清晰,而係改用 sparse and adaptive voxel structure(SAV)同 sparse transformer encoder-decoder,將固定體素表示換成可自適應結構。頁面指出,它可生成高出 16^3 倍解析度的屬性場,亦支援 test-time 調整解析度,兼顧準確度、記憶體效率同細節保留。

AdaVoMP short video [ICML 26]

AdaVoMP 展示咗幾種直接可理解的用途,例如將 Gaussian Splat + mesh 場景轉成可互動世界、為純 mesh 或 gaussian splats 場景做較真實的物理模擬,以及配合 RoboLab 與 Isaac Sim 建立機械人測試環境。對做 robotics、simulation、數碼孿生,或者想將 NeRF、Gaussian Splat 資產變成可操作場景的人,呢類流程會特別有參考價值。

  • 補回 3D 資產常見缺失的物理材質資訊
  • 比 VoMP v1 提供更高解析度與可縮放輸出
  • 同時支援 mesh、Gaussian Splat 等不同表示
  • 可用於 Isaac Sim 機械人基準測試與互動場景建立

從頁面資料看,AdaVoMP 亦有同 NeRF2Physics、PUGS、Phys4DGen、Pixie、VoMP 及 Ground Truth 作視覺比較,重點放在 physics material fields 的品質。若要自行測試,查看 Code 同 Model/Data,再留意它在自己場景表示、模擬器同資產格式上的接入成本。
項目: https://research.nvidia.com/labs/sil/projects/adavomp/

Categories: 開源, 模型, NVIDIA, Robotic, 3D

RATs 用多代理玩出機械人技能庫

RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

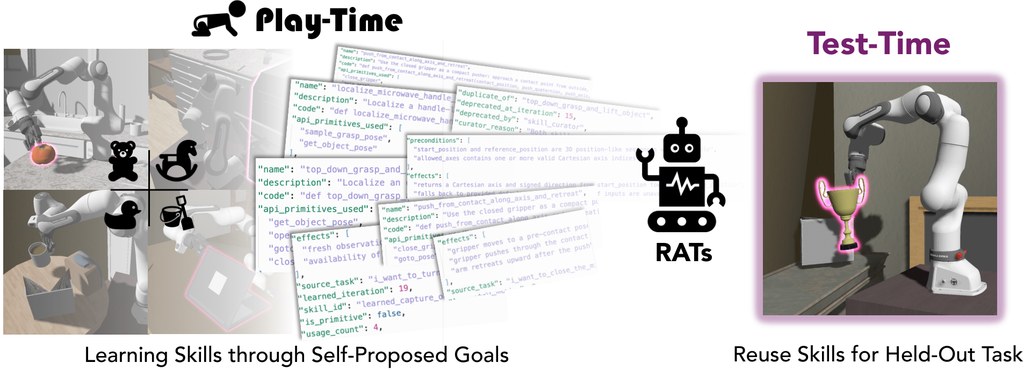
現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda

GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, , Skill 技能

Nemotron:NVIDIA 打造 Agentic AI 模型家族

Nemotron 不只是單一模型,而是一套面向 agentic AI 的開放模型與訓練資源。由邊緣裝置到資料中心,都有對應版本。

Watch the Nemotron Overview

Nemotron 是一個面向 agentic AI 的模型家族加開發資源項目,重點不是只放出權重,而是連 training recipes、deployment guides、資料準備與 use-case examples 一併提供,目標是縮短由研究到部署的距離。對想建立 AI agents 的團隊來說,這種整理方式比單獨下載模型更實用。

這個項目最實際的看法,是它把不同算力環境分得很清楚:Nano 針對 edge 和 PC,Super 主打單 GPU 高吞吐,Ultra 面向 multi-GPU datacenter applications。若你想先試概念,可由 Hugging Face 上的 Nemotron 模型開始,再按項目內的指引查看對應版本的訓練與部署資料。

創新點在於它不只講文字模型。Nemotron 3 Nano Omni 是 30B-A3B hybrid Mamba-Transformer MoE,原生支援 text、image、video、audio,定位為 agentic AI 的 multimodal perception sub-agent。這代表它較像多模態代理系統中的感知核心,而不只是一般聊天模型。

項目內容亦涵蓋 curate/、data prep/、sdg/ 和 translate/,即是連資料整理、Synthetic Data Generation (SDG) 與 corpus translation 都納入流程。這種由數據到模型再到部署的完整鏈條,對企業、研究團隊,以及想建立可重複流程的開發者尤其有吸引力。

  • 提供 Nemotron Nano、Super、Ultra 等級,對應不同硬件規模
  • 涵蓋 training recipes、deployment guides、資料處理與 SDG
  • Nemotron 3 Nano Omni 支援文字、影像、影片、音訊多模態輸入
  • 可配合 TensorRT-LLM 與 NIM microservices,部署彈性較高
  • 適合 agentic AI、Computer-use agents、企業內部 AI workflow 測試

如果你想找的是一個可直接抄答案的成品,Nemotron 未必是最快捷的選擇;但若你需要一套可追溯、可調整、可延伸的開放模型項目,它的結構相當完整。現有資料顯示它更偏向給認真做產品化或研究驗證的人使用,而不是單次玩票式體驗。

GitHub: https://github.com/NVIDIA-NeMo/Nemotron

Categories: Agentic, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, Anthropic, AGI

BadWorld:如何解決癱瘓視覺世界模型的未來推演

香港理工大學團隊提出無需標籤的對抗攻擊框架,揭露 Matrix-Game-2.0 與 Astra 等世界模型在單一擾動圖下即可能全面崩潰的結構性脆弱。

Chart

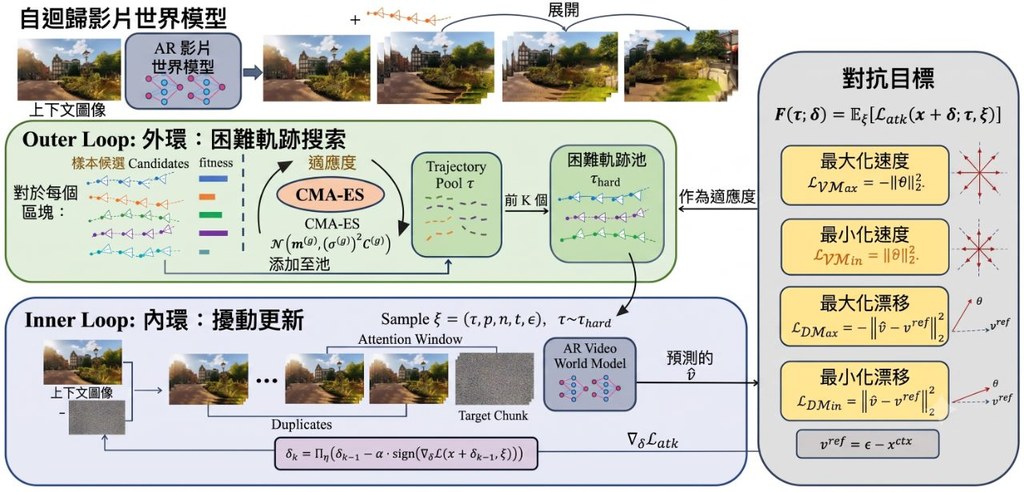
視覺世界模型(Visual World Models, VWMs)能從一張起始圖片,根據使用者動作序列合成出互動式的未來影片。現有做法多數沿用文字生成圖像或文字生成影片的對抗攻擊範式,但這類方法通常假設有固定的參考輸出或可取得的未來幀標籤。BadWorld 的作者指出,攻擊 VWMs 面對兩道根本限制:攻擊者根本拿不到真實的未來影片當作監督訊號,也無法預測使用者接下來會輸入什麼動作,因此傳統攻擊範式無法直接套用。

為此,團隊提出 BadWorld 框架,屬於一種安全研究工具,專門用來壓力測試自回歸式世界模型的時序穩健性。它繞過「需要未來監督」這道牆,採用自監督的速度擾動攻擊(self-supervised velocity attack),直接破壞模型早期的去噪動力學;同時,為了讓攻擊在未知動作下仍然有效,設計了軌跡自適應雙層優化(trajectory-adaptive bi-level optimization),主動挖掘困難的動作序列以鍛造「對動作無感」的擾動。

從測試結果來看,視覺上幾乎無法分辨的對抗圖片,能可靠觸發後續推演的災難性退化,出現去噪不完全、結構崩塌、控制訊號前後不一致等現象。這些發現對準備把世界模型應用於自動駕駛、機器人等安全關鍵場景的開發者是一記警鐘,同時也提供了一種可操作的隱私保護機制。

如果想自行驗證,可以針對 Matrix-Game-2.0 與 Astra 兩款開源世界模型測試。Matrix-Game-2.0 需約 32GB 顯示記憶體,Astra 則需 80GB,環境需要搭配 FlashAttention 與 NVIDIA Apex 等加速庫,並從 Hugging Face 下載預訓練權重。

  • 屬於安全研究工具,針對視覺世界模型做對抗壓力測試。
  • 突破傳統攻擊需「未來監督」的限制,採自監督速度擾動。
  • 透過軌跡自適應雙層優化,鍛造對未知動作仍有效的擾動。
  • 已在 Matrix-Game-2.0 與 Astra 上展示結構性崩潰。
  • 對自駕、機器人、遊戲模擬等安全關鍵部署具警示意義。

GitHub: https://github.com/LinghuiiShen/BadWorld

Paper: https://arxiv.org/pdf/2606.16519

Categories: 開源, 香港理工大學, 清華大學, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 框架, 香港, 工具, , 安全, 深度學習

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

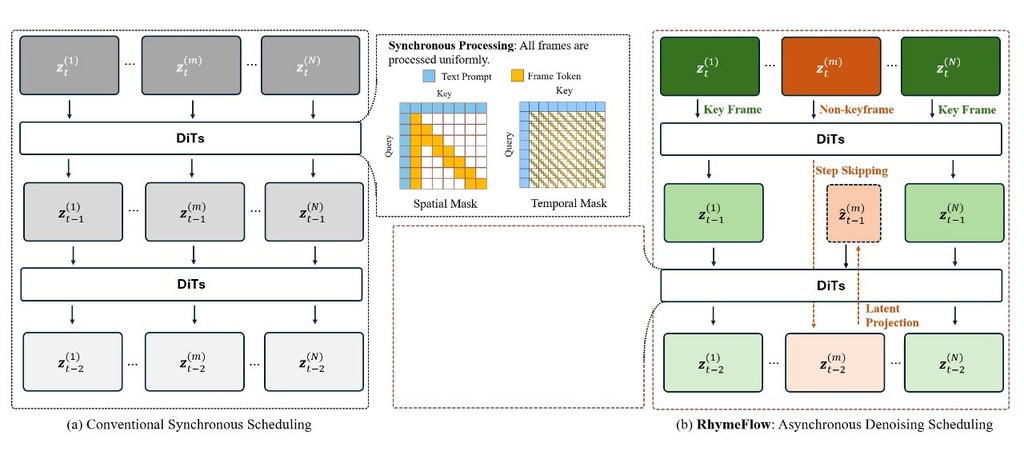
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。

GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

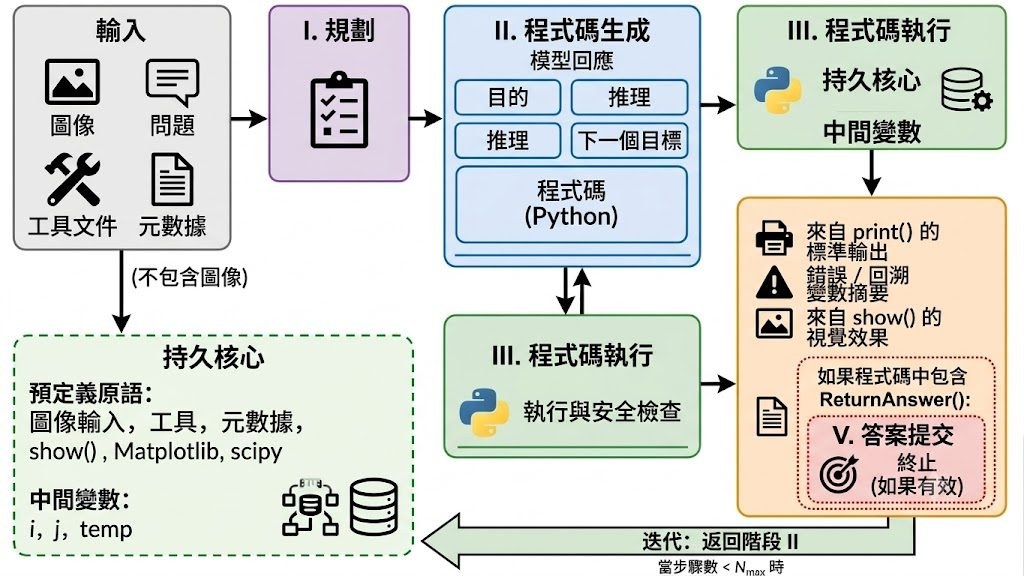
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentationDepth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

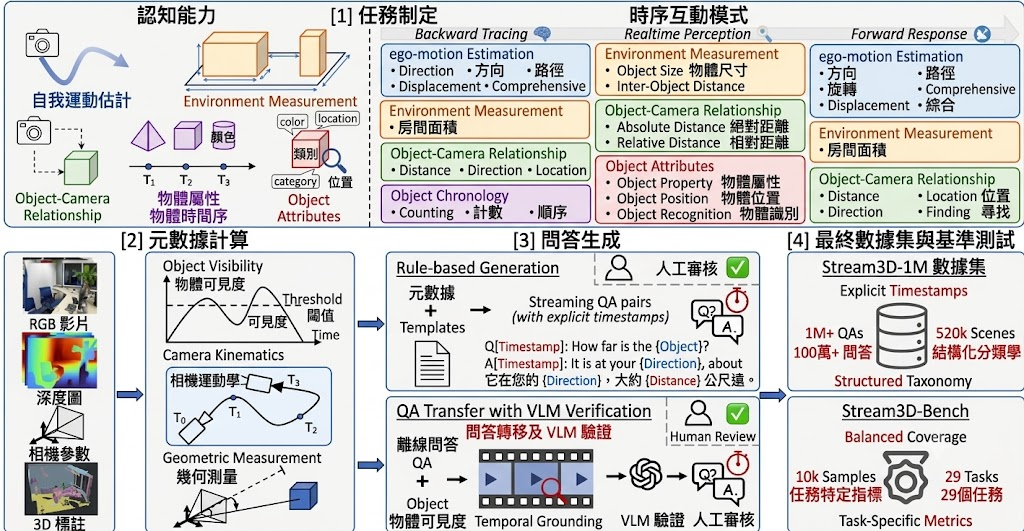
使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

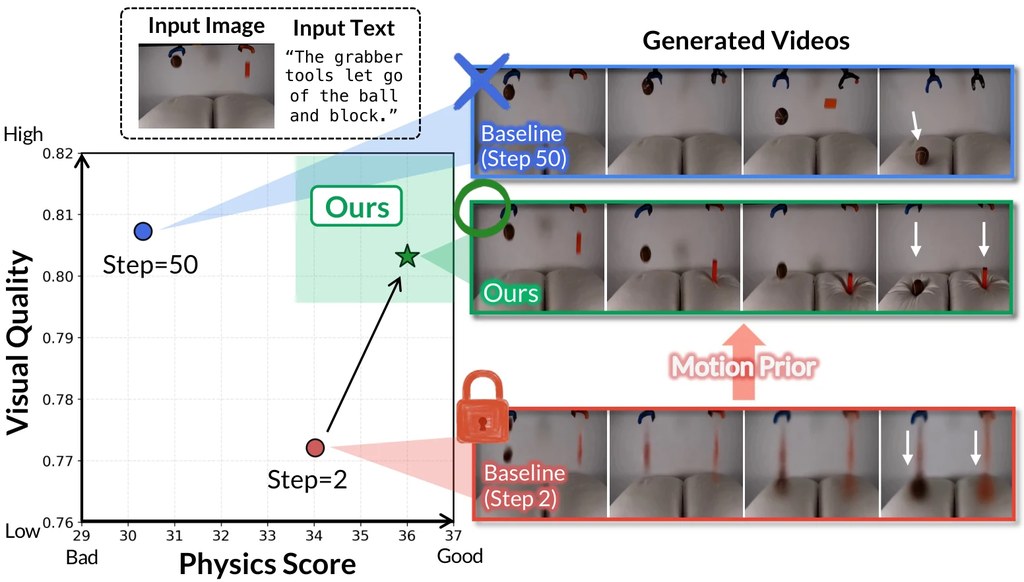
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

OmniDreams:NVidia 點樣重塑自駕模擬

OmniDreams把單張畫面、文字提示與地圖軌跡結合,實時生成多鏡頭擬真影片。這類 world model,正改變自動駕駛模擬的可擴展性。

Repository image for nv-tlabs/omni-dreams

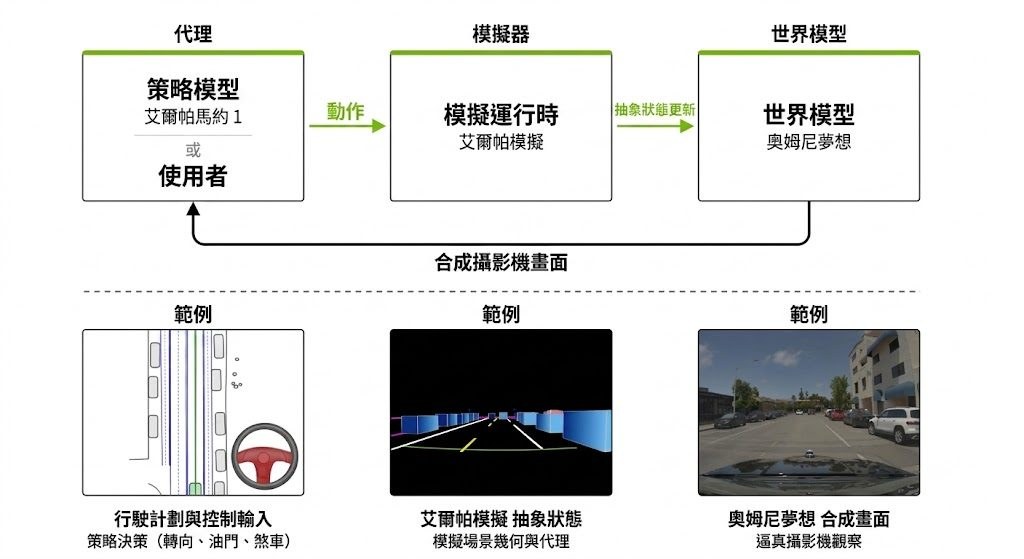
NVIDIA OmniDreams 是一個用於自動駕駛模擬的 world model,重點不在重播已錄好的路面片段,而是在系統提供條件後,持續生成多鏡頭、近乎寫實的影片畫面。它吃進一張真實 RGB 起始影像、文字提示,以及每幀的 coarse HD map image 和 trajectory poses,再以分段方式推進後續畫面。

這個項目想處理的核心問題,是傳統神經模擬器雖然可以很像真,但通常受限於原本拍到的資料,遇到少見天氣、突發交通行為或未見過的場景時,彈性不足。OmniDreams 走的是自回歸生成路線,會根據過往畫面、模擬器狀態與即時駕駛動作,繼續生成下一段感測畫面,較接近 closed-loop simulation 的需要。

從公開資料看,它的創新點在於把 Cosmos diffusion model 的視覺先驗,延伸成可即時反應動作的生成式 world model,並且支援 multi-camera photorealistic video。論文亦提到它曾在 21k 小時駕駛場景上做 mid-training 與 post-training,目標是覆蓋更多傳統模擬器難以刻畫的情境。

使用這個項目時,較適合把它視為研究與後訓練樣本發佈點;互動式推論與 live driving demo 則放在配套項目 FlashDreams。倉庫亦提供 post-training 樣本,圍繞 Cosmos2 SV-HDMap world model 微調,並提到 student-init、bidirectional teacher 與 self-forcing distillation 等訓練路線,但硬件門檻不低,官方列明最低為單個 8-GPU Ampere/Hopper 節點。

  • 可從單張真實畫面開始,生成連續多鏡頭影片
  • 輸入條件清晰,包括文字提示、HD map 與 trajectory poses
  • 重點場景是 closed-loop autonomous vehicle simulation
  • 相關模型與系統包括 Cosmos diffusion model、Cosmos2 SV-HDMap、FlashDreams、Alpamayo 1、AlpaSim、WAM
  • 論文初步結果指出,從 OmniDreams 後訓練出的 WAM 在 Physical AI Autonomous Vehicles NuRec 上表現不俗,且總參數量少於 VLA-based Alpamayo 1.5 的五分之一

整體來看,OmniDreams 不是一般開箱即用的消費級工具,而是面向自動駕駛研究、模擬平台與生成式 world model 開發流程的關鍵項目。對研究團隊、模擬系統工程師,或者想追蹤 NVIDIA 在 Physical AI 與 AV simulation 方向的人來說,這個項目很有參考價值。

GitHub: https://github.com/nv-tlabs/omni-dreams

項目: https://research.nvidia.com/labs/sil/projects/omnidreams-blog/

Categories: 開源, 世界模型, NVIDIA

Page 9 of 11
1 7 8 9 10 11