EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

EO-WM overview

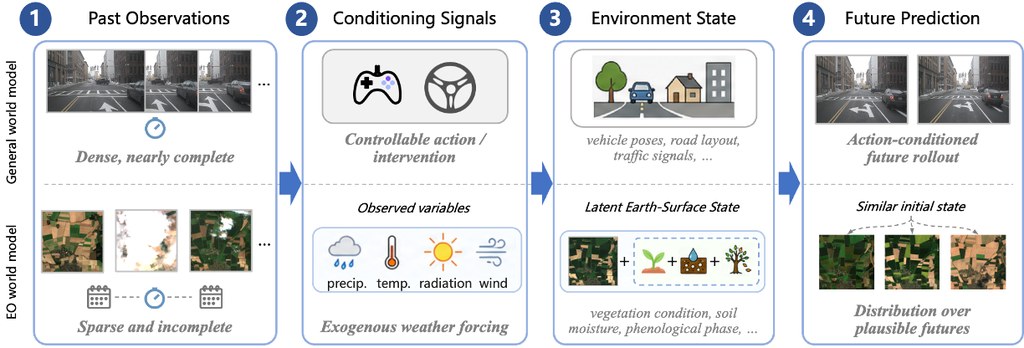
這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。
GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, 庫, 深度學習

LISA:讓 ControlNet 訓練快 2.78 倍的正則化方法

香港科技大學團隊提出的 LISA 正則化技術,能在不增加推理成本的前提下,加速視覺條件可控生成模型的訓練並提升生成品質。

Arxiv

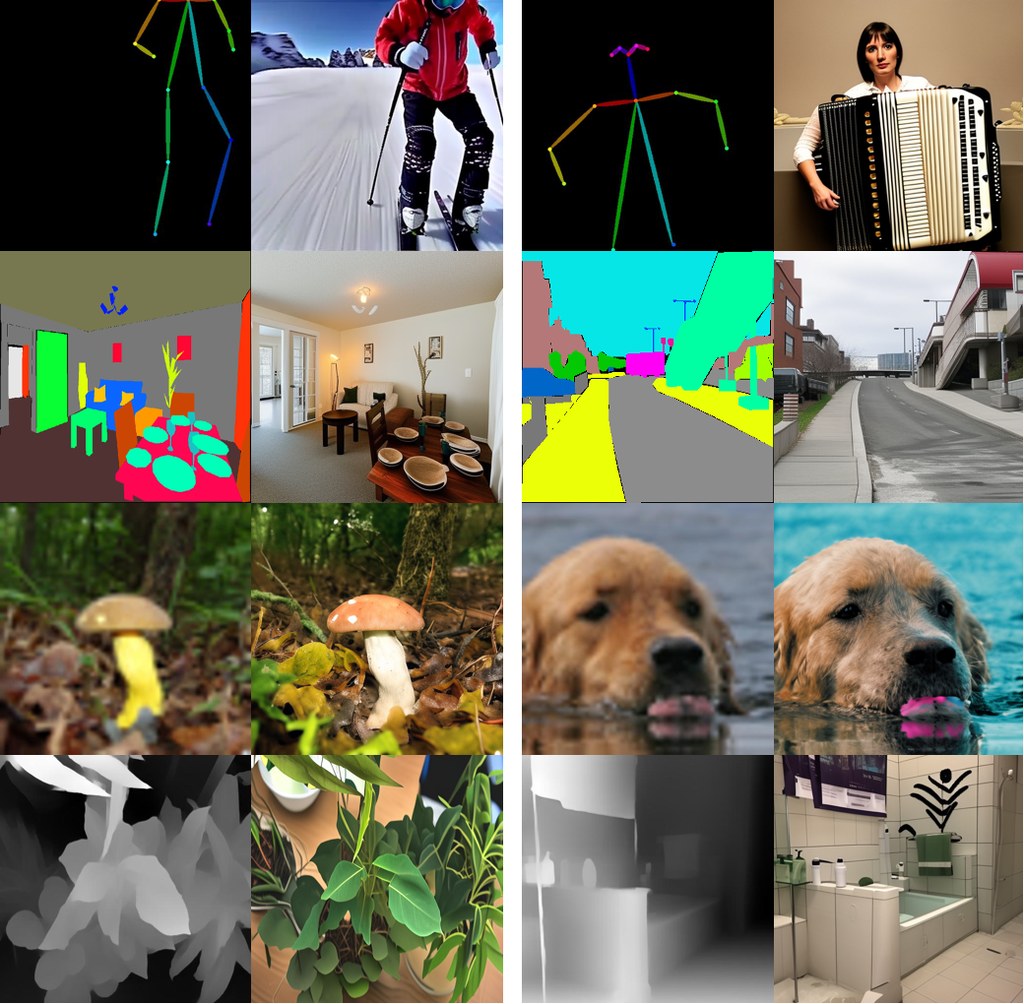
LISA(Likelihood Score Alignment)是一種訓練正則化方法,專門用於加速視覺條件可控生成模型(例如 ControlNet)的訓練過程,同時提升最終生成結果在感知品質與條件遵循度上的表現。

現有做法普遍採用「雙分支範式」(dual-branch paradigm):訓練一個側網絡(side network)來編碼視覺條件,再將其中間層特徵融合到凍結的預訓練主網絡中。這個範式雖然效果顯著,但側分支的角色定位與訓練效率長期未被深入研究。LISA 從基於分數的生成建模(score-based generative modeling)角度重新審視這個範式:主網絡負責提供先驗的無條件分數(unconditional score),側網絡則透過隱式方式貢獻似然分數(likelihood score)。

LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。

根據論文實驗結果,LISA 在多種圖像與影片任務、不同網絡架構(UNet/DiT)以及擴散與流匹配模型上均表現穩定,能夠實現超過 2.78 倍的訓練收斂加速(例如在 ControlNet 上),同時帶來可忽略的額外訓練成本與零推理成本。

這項技術特別適合需要快速迭代 ControlNet 或類似條件控制模型的團隊,例如從事姿態引導圖像生成、組合條件生成或可控影片生成的研究人員與開發者。

重點摘要:

  • 方法類型:訓練正則化技術,適用於雙分支視覺條件可控生成框架
  • 核心創新:將側網絡特徵對齊近似似然分數目標,取代純粹依賴擴散損失的訓練方式
  • 訓練效率:在 ControlNet 等場景實現超過 2.78 倍的收斂加速
  • 推理成本:零額外推理開銷,解碼器僅在訓練階段使用
  • 適用範圍:圖像與影片生成任務,兼容 UNet 與 DiT 架構,支援擴散與流匹配模型

GitHub · Paper

Categories: 開源, 香港科技大學, 華為, 模型, 視覺模型, 模型訓練, 框架, 香港, IDE, 深度學習

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

walker run

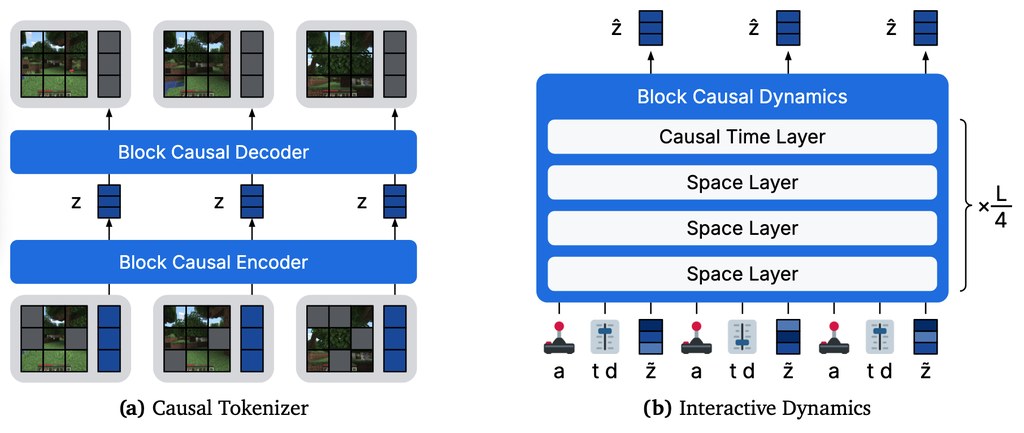
MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

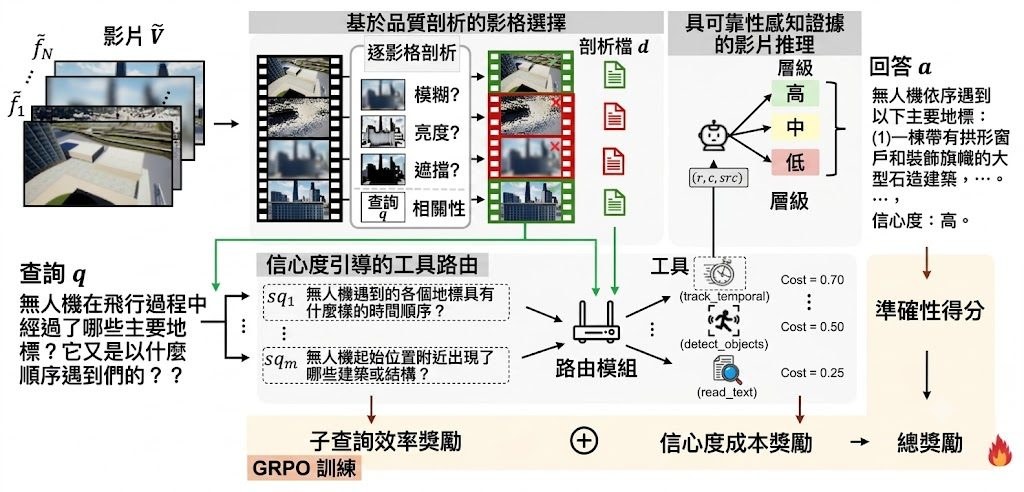
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

Hermes3D:把 AI 團隊放進 3D 辦公室協作

Hermes3D 將 AI agents 的工作流程搬入自建 3D 辦公室,讓協作、程式碼審查和 QA 監控變得可見。

Hermes3D

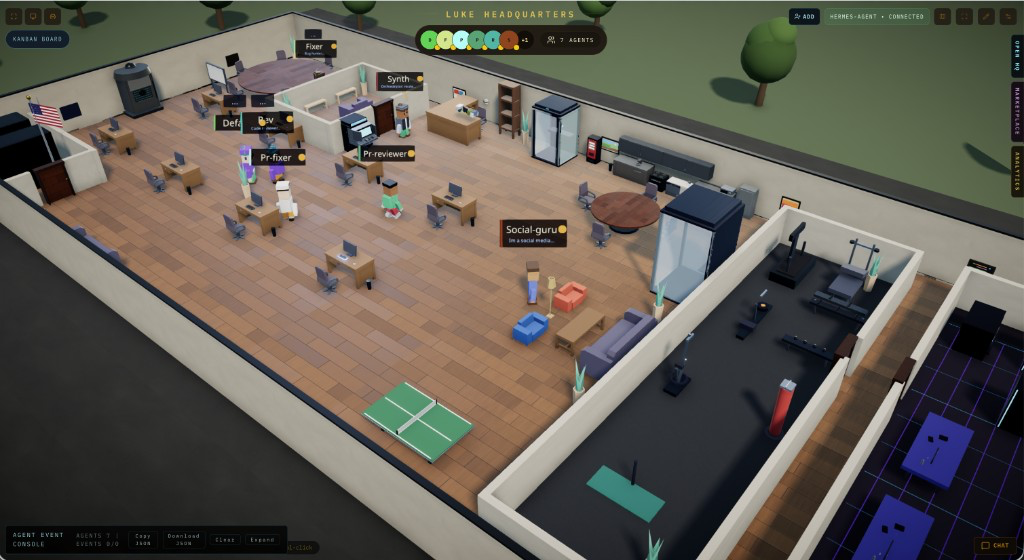
將 AI agents 的協作、standup、Pull Request 審查和 QA pipeline 放進同一個可行走的 3D 空間,Hermes3D 便是一個自建的 3D 虛擬辦公室項目,處理的是 AI 工作流程難以觀察和管理的問題。它把原本分散在 dashboard、GitHub、Jira 和 logs 的活動,集中到共享辦公室內呈現。

Hermes3D 本身只是 visualization and interaction layer,Gateway 則負責控制和連接後端。項目支援內置 Gateway adapter,讓 Hermes 透過 WebSocket 接入;亦可使用 direct HTTP custom runtime provider 連接其他 orchestrator-backed stacks,另有 built-in demo gateway,方便先探索辦公室功能而毋須接入真正的 agent framework。

使用者可先用 demo gateway 檢查 3D 辦公室、代理協作和介面流程,再按需要接駁 Hermes、GitHub、Jira 或自訂 HTTP runtime。README 暫未提供完整安裝步驟或效能基準,因此較適合視為仍在發展中的 self-hosted workspace,而不是可直接取代現有監控系統的成熟平台。

  • 以 3D 場景即時查看 AI agents 的工作狀態
  • 在辦公室內進行 standup、Pull Request 審查和 QA 監控
  • 透過 gym 訓練 agents 發展新技能
  • 以 janitor system 重設 session 和清理 context
  • 支援 Hermes、custom runtime 及 demo gateway

對管理多個 AI agents、需要追蹤程式碼交付流程,或希望資料留在自家基礎設施的個人開發者和小型團隊,Hermes3D 提供了比純文字 logs 更直觀的觀察方式。代價是 3D 顯示層會增加系統複雜度,是否適合正式工作流仍要以團隊自己的 runtime 和整合測試為準。

GitHub

Categories: 開源, Agentic, 框架, 3D

ViQ 想把影像變成更懂語意的離散碼

ViQ 是把影像量化成離散表示的研究框架,目標是在語意理解與細節保留之間取得平衡。它也支援任意解析度輸入,對多模態訓練效率有明顯吸引力。

hunyuan logo

ViQ 是一個視覺量化表示研究框架,也是把影像轉成離散 codes 的模型方法。它要解決的問題,是讓圖片像文字 token 一樣可交給多模態大模型處理,同時盡量不要在量化過程丟失太多語意與畫面細節。

現有做法常見兩條路:一類偏重重建,還原畫面能力較好,但語意資訊不足;另一類依賴 contrastive vision-language learning 的連續特徵,語意較強,卻不容易直接變成高品質離散表示。ViQ 的切入點是先做 Text-Aligned Pre-training,再做量化學習,把「先對齊語言語意、後逐步離散化」拆成清楚兩段。

它的核心設計有幾個辨識度很高的部件:以 pretrained language model 監督視覺編碼器、用 resized positional embedding 與 native patchify 支援 any-resolution input、再用 Proximal Representation Learning 配合 L∞-norm 約束,把特徵逐步推近量化錨點,最後交給 position-aware、head-wise FSQ(Finite Scalar Quantization)處理。論文亦提到基座可接 SigLIP2 vision tower、Qwen2.5 backbone,並透過 LoRA 等輕量組件訓練量化部分,而不是全面微調整個系統。

  • 支援任意解析度輸入,不用被固定尺寸綁死
  • 目標不是只重建圖片,而是兼顧語意理解與細節
  • 多模態訓練可直接吃離散視覺 codes,論文稱效率可提升約 20% 至 70%
  • 已公開訓練與推論程式,並提供 HuggingFace 權重

從部署與測試角度看,這個 GitHub 儲存庫較適合當研究實作與模型驗證項目來理解:可先用已公開權重跑 inference,觀察影像如何被編成離散 codes,再進一步重現單階段訓練示例,之後才嘗試論文中的兩階段 recipe。較受惠的會是做 MLLM、視覺 tokenization、影像重建或訓練加速的團隊;限制則是概念與訓練流程都不算輕,重點較偏研究價值,未必是即裝即用的通用工具。

GitHub: https://github.com/yuxumin/ViQ

Paper: https://arxiv.org/pdf/2606.27313

Categories: 開源, 清華大學, 騰訊, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

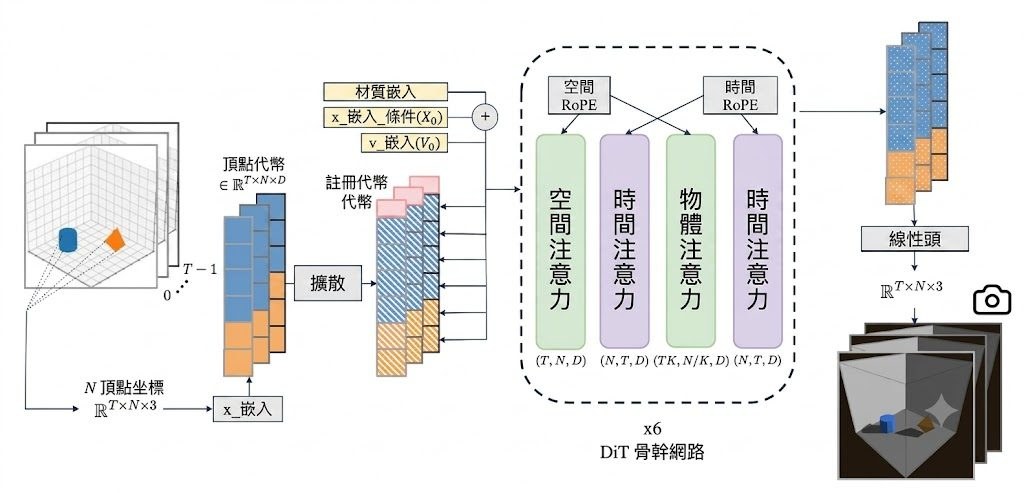
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 以 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

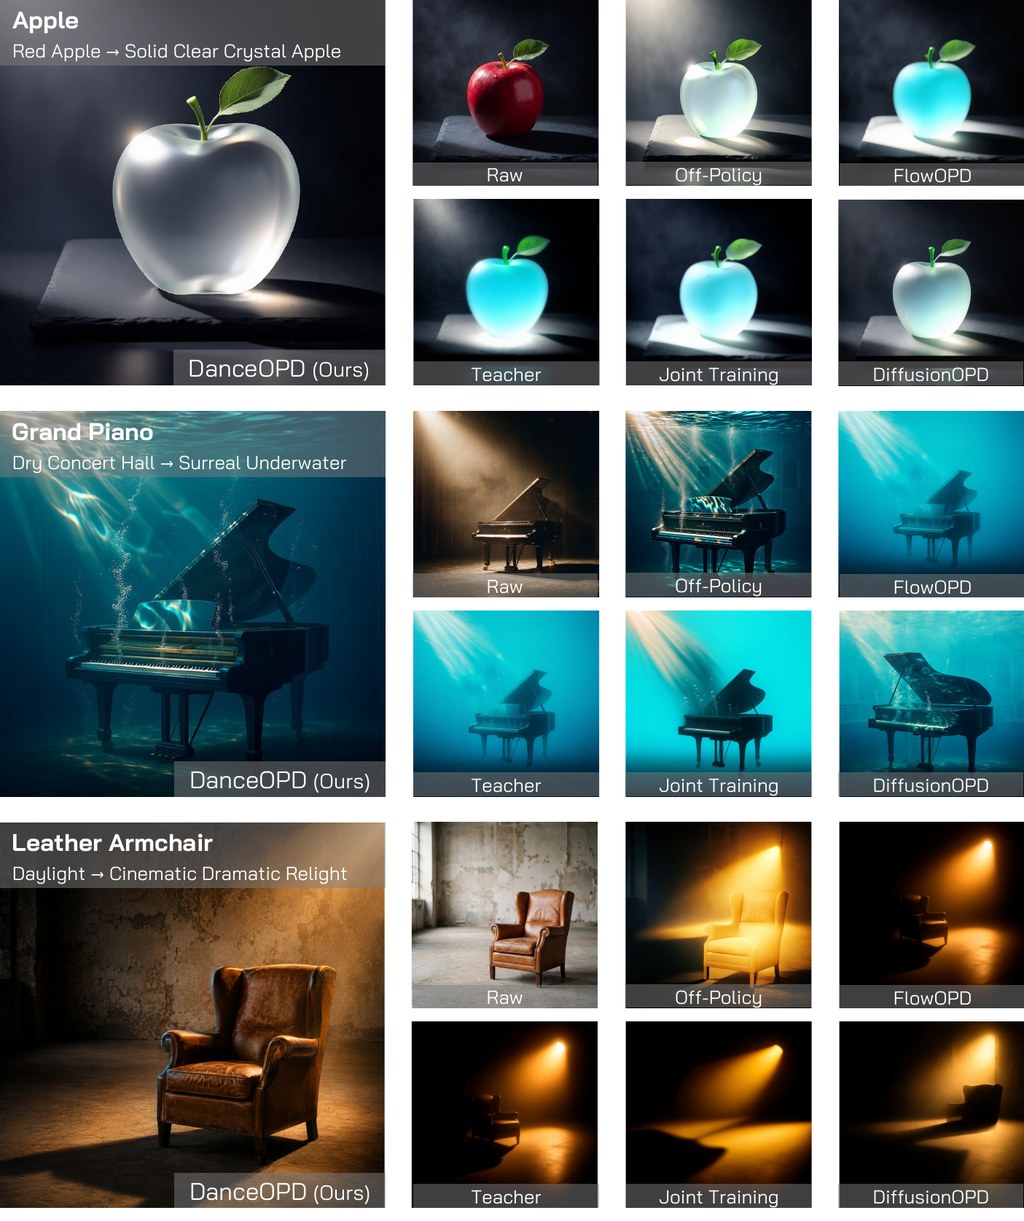
DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

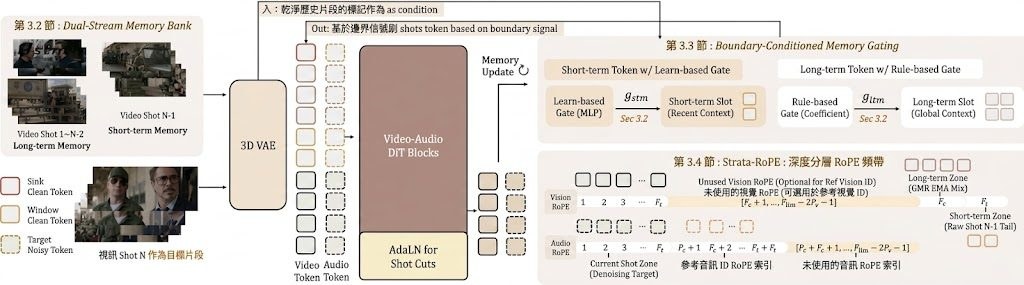
UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots

項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, 庫, 語音, LTX

Page 21 of 34
1 … 19 20 21 22 23 … 34