CoVEBench 檢查影片編輯模型的真功夫

這是用來驗證影片編輯模型表現的基準項目。它特別擅長揭出複合指令下常被忽略的失誤。

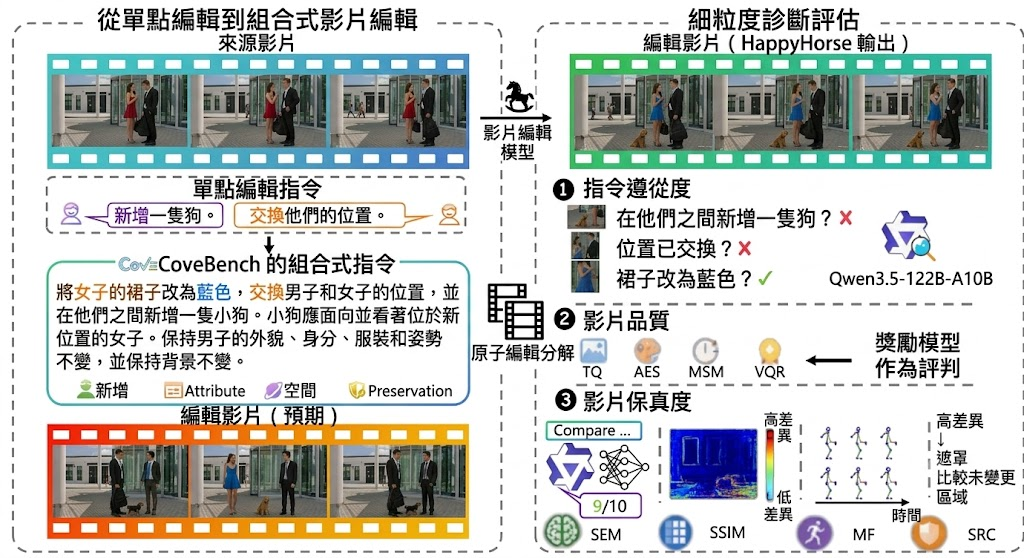
近年不少影片編輯模型已能根據文字改片,但一遇到多個要求同時出現,例如一邊改主體、一邊保留背景與動作連貫,表現就容易失準。CoVEBench 是一個診斷型 benchmark,專門檢查 compositional instruction-guided video editing 在複雜條件下是否真的做得到。

這項目的判斷方法比一般「整體看起來差不多」更嚴格。它把表現分成指令完成度、畫質與來源保真度三條線來看,並用細緻 checklist 檢查多個編輯點有沒有同時成立;就算模型個別要求做到幾項,只要無法通過 union criterion,分數仍然不高,這種設計能更早看出模型短板。

如果想了解它的內容,較合適的做法是先看示範頁與資料集規模,再對照評估指標。CoVEBench 收錄 416 段來源影片、626 條多重指令、9,990 個細項檢查點,預設會抽取 10 張等距 frame 做 frame-level metrics;AES、VQR、MSM 則只針對 edited videos 計算,方便把「改得夠不夠」與「有沒有改壞其他地方」分開分析。

  • 核心用途是評測 video editing models,不是直接拿來剪片
  • 主要指標包括 Union Accuracy(UAS)、Instruction Following Score(IFS)、Video Realism Score(VRS)、Semantic Consistency(SEM)
  • 設計重點在細粒度 checklist,而非只看單一總分
  • 結果顯示強模型未必兼顧保留原片內容,編輯力度與保真度存在拉扯
  • 項目亦比較了 joint editing 與 stepwise decomposition 的差異,前者表現更好

從公開資訊看,CoVEBench 的價值在於它把失敗原因拆得夠清楚,適合研究團隊、評測人員,以及想比較閉源與開源方案的人參考。相關模型包括 Wan2.7 與 HappyHorse1.0;即使領先系統在複合編輯上較強,UAS 仍未算高,反映這個領域離穩定可靠還有一段距離。
GitHub: https://github.com/NJU-LINK/CoVEBench

項目: https://nju-link.github.io/CoVEBench/

Categories: 開源, 影像處理, 框架

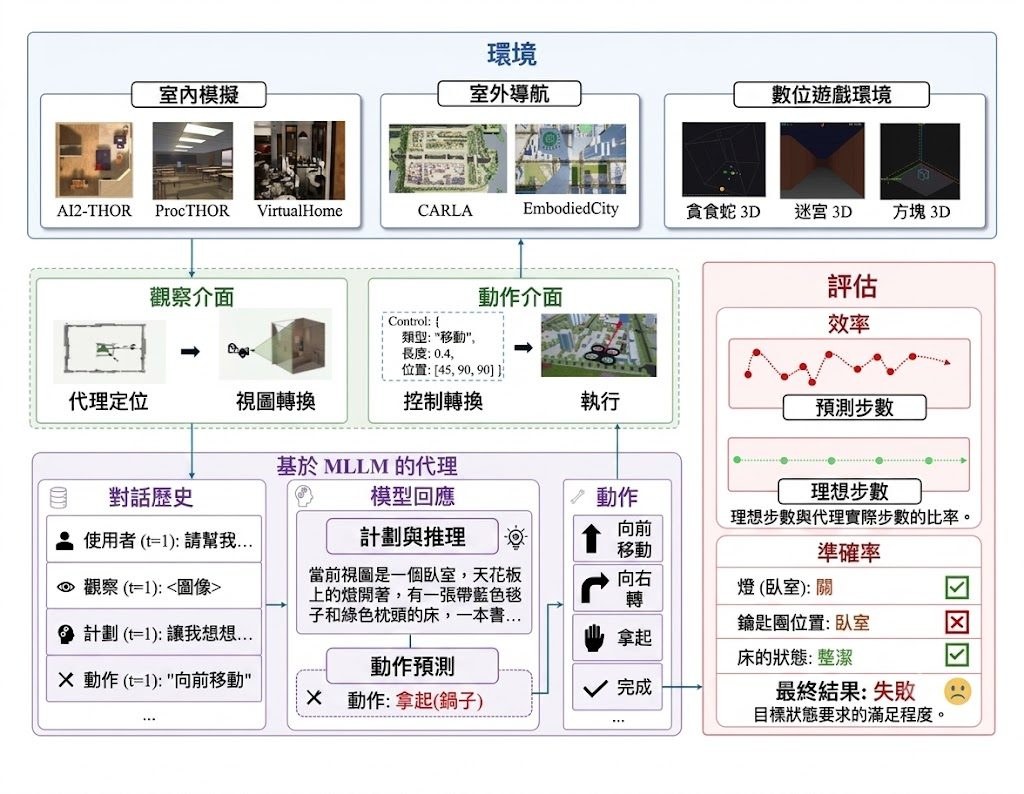
SpatialWorld:測試多模態代理空間理解的統一基準

SpatialWorld 用統一介面評估多模態代理在 3D 任務中的空間理解。數據亦顯示,現有模型距離可靠完成任務仍有明顯差距。

SpatialWorld framework overview

SpatialWorld 是一個用來測試 Multimodal Large Language Models(MLLMs)與代理能力的 benchmark。它把 8 個不同的 3D 模擬後端整合成同一套 observation–action 介面,讓模型只靠自然語言指令、第一身 egocentric RGB 畫面,以及統一的文字動作指令完成任務。

如果你想知道一個模型是否真的懂得在環境中探索、轉向、移動、判斷位置與完成多步驟任務,SpatialWorld 提供了較一致的測試方法。它包含 760 個人工標註任務,覆蓋家居、出行、協作與數碼 3D 遊戲等場景,並以 human-validated terminal-state verifiers 判定結果。

讓代理輸入文字動作,例如 Move、Rotate,再由 action parser 轉成各個模擬器原生指令。這種做法的重點,是避免每個 simulator 各有一套流程,令不同模型之間較容易作橫向比較。

  • 統一 8 個 3D backends,減少 simulator-specific pipelines 帶來的比較困難
  • 只提供 vision-only partial observability,更接近代理逐步探索的情況
  • 除了 task success rate(TSR),亦會看 step efficiency(SE),不只比較有沒有完成
  • 已評估 15 個代理,方便對照現有模型表現

從公開結果看,這個項目揭示了目前模型的限制。GPT-5 的平均 TSR 為 17.4%,領先的 open-source 模型 Qwen-3.5 為 14.1%;若看 Physical Overall TSR,GPT-5 只有 14.4%,Qwen-3.5-397B-A17B 為 12.2%。這表示模型即使能理解圖片與文字,也未必能穩定完成需要空間推理與長步驟規劃的任務。

相關模型有 GPT-5、Qwen-3.5、Qwen-3.5-397B-A17B 與 Gemini-3.1-Pro,其中 Gemini-3.1-Pro 在 digital 3D games 達到 39.0% TSR。若你是做 agent、embodied AI、MLLM 評測,或者想比較不同模型在互動式空間任務的差異,SpatialWorld 會是一個很有參考價值的項目。

GitHub: https://github.com/Hongcheng-Gao/SpatialWorld

項目: https://spatial-world.github.io/

Categories: 香港大學, 北京大學, 清華大學, 多模態模型, 框架

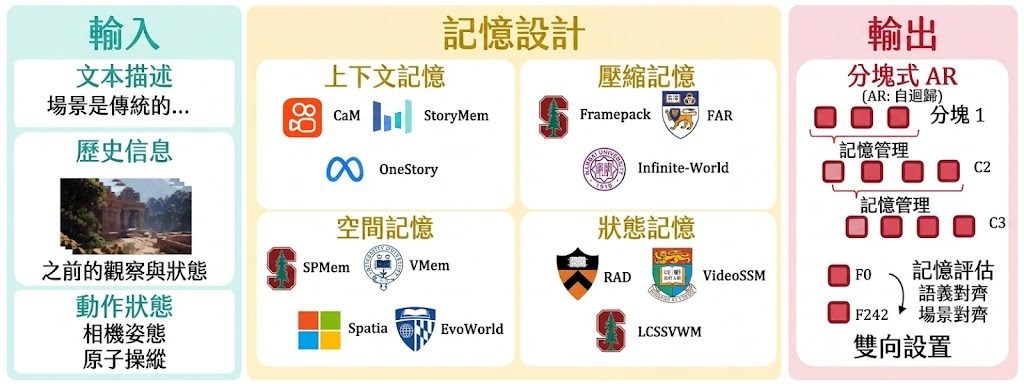
Echo-Memory 讓世界模型認得回家的路

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。

Echo-Memory paper teaser and workflow

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。Echo-Memory 想解的,正是這個讓生成影片失去一致性的老問題。整個研究的設計非常克制:只更換「記憶模組」,其餘一概不動。

Echo-Memory 以同一套 Wan 2.1 1.3B 動作到影片(action-to-video)模型作為共用底座,把記憶方式分成四大類——Context(原始幀滑窗)、Compression(壓縮後的學習 token)、Spatial(顯式空間讀寫狀態)、State-Space(區塊式 SSM 遞迴更新)。所有變體都掛在相同的寫入—讀取介面上,差別只在於「存什麼」和「怎麼取回」。這種單一變因的設定,讓四種記憶家族的表現可以乾乾淨淨地比較。

對研究員和工程師而言,項目提供了開發者指南。Echo-Team 已把訓練到 30,000 步的 Wan 2.1 1.3B 權重放在 Hugging Face 的 Echo-Team/Echo-Memory,並附上 SpatialVID 子集的動態訓練池設定文件,開發者指南亦提供中英雙語流程。評測方面,項目提供 GT replay、in-domain 180 度折返,以及 open-domain 編輯式回訪三種探測腳本,涵蓋靜態回放和場景重訪兩個維度。

要注意的是,目前的權重僅限 Wan 2.1 1.3B(epoch-0),Wan 2.2 以及 5B/14B 多尺度底座、以及超越靜態重訪的動態評測,仍列在路線圖上等待補齊。對於研究世界模型長期一致性、做可控影片生成,或是想在 LoRA/記憶外掛(memory adapter)方向動手的人,這個項目提供了一個難得的可重現基準;對一般讀者來說,它也示範了當鏡頭「回家」時,AI 為何會迷路、又該怎麼讓它記路。

重點摘要:

  • 統一底座、只換記憶:以 Wan 2.1 1.3B 為共用骨幹,比較 Context、Compression、Spatial、State-Space 四種記憶家族。
  • 可控變因設計:所有模組共享寫入—讀取介面,差異集中在「存什麼、怎麼取回」。
  • 完整可重現資源:公開 30,000 步權重、SpatialVID 訓練池設定、雙語開發者指南與評測腳本。
  • 三種回訪探測:GT replay、in-domain 180 度折返、open-domain 編輯式回訪,分別檢驗重播與折返記憶。
  • 未來路線:Wan 2.2、5B/14B 多尺度底座與動態評測仍待補齊。

GitHub: https://github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Memory

項目: https://echo-team-joy-future-academy-jd.github.io/Echo-Memory/

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 框架

LatentSpatialMemory:Mirage 影片世界模型:把 3D 記憶藏在潛在空間裡

微軟與浙江大學等團隊發表 Mirage,把 3D 場景以潛在 token 形式持久保存,讓影片世界模型兼顧一致性與效率。

Latent Spatial Memory logo

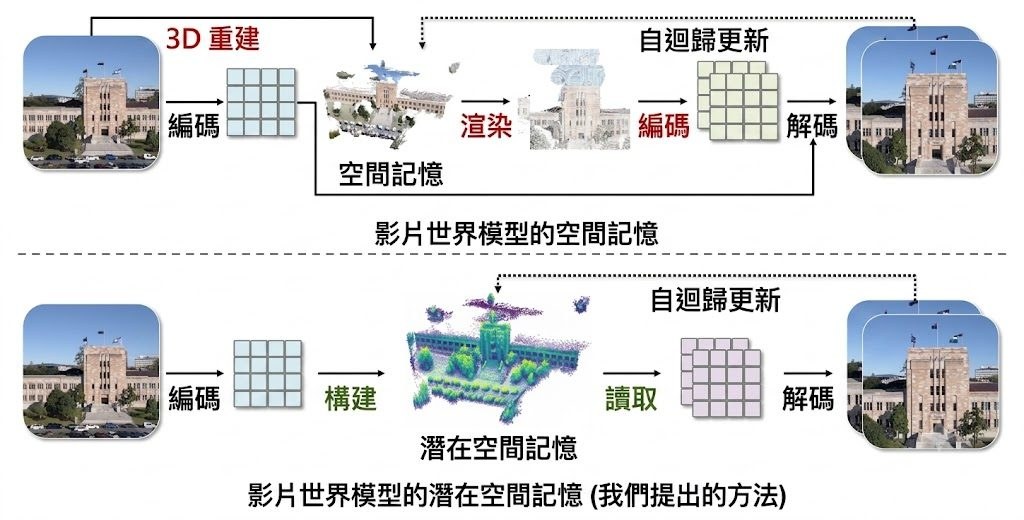
由微軟研究院、浙江大學、阿德萊德大學及 Monash University 共同發表的 Mirage,主打一個名為「Latent Spatial Memory」的方法,目標是讓 AI 影片世界模型在長序列生成時,仍能維持空間一致性。傳統做法會把 3D 場景快取為點雲,再反覆渲染成 RGB 影像重新編碼,Mirage 則直接把靜態場景以 3D latent tokens 儲存,於潛在空間中完成讀取、去噪與更新,繞開了 RGB 來回轉換的開銷。

這個項目想解決的問題很明確:影片世界模型在長時間生成下,3D 快取會愈來愈大、速度愈來愈慢,但場景內容其實變化有限。 Mirage 把「場景記憶」與「生成流程」解耦,用一套 Initialize、Read、Denoise、Update 的記憶生命週期,讓模型在生成每個 chunk 時直接讀寫一份共享的潛在快取,省下重複編碼的成本。

依據官方項目頁公布的 World-R1 基準數據,Mirage 達到約 70.36 的 WorldScore 平均成績,生成速度達到 10.57 倍提升,3D 快取記憶體用量則降低約 55 倍。論文亦提供與 Spatia、Voyager、Gen3C、VMem 等四個基準的定性比較,覆蓋同一軌跡下的條件輸入結果。官方程式碼則標示為「Coming Soon」,目前較適合研究員先閱讀論文與項目頁示範影片。

這個項目特別適合研究影片世界模型、3D 場景理解或擴散模型加速的團隊與學生,亦可作為 generative world model 課程的延伸閱讀。 對一般讀者而言,它展示了把「記憶」留在潛在空間而不還原成像素,是兼顧一致性與效率的可行方向。

重點摘要:

  • 核心方法:以 3D latent tokens 儲存靜態場景,避免 RGB render-and-reencode。
  • 記憶生命週期:Initialize、Read、Denoise、Update 四個步驟跨 chunk 共享快取。
  • 效率數據:World-R1 上生成速度約 10.57 倍、3D 快取記憶體降約 55 倍、WorldScore 70.36。
  • 比較基準:Spatia、Voyager、Gen3C、VMem。
  • 目前狀態:論文已公開,程式碼尚未釋出。

GitHub: https://github.com/microsoft/LatentSpatialMemory

項目: https://microsoft.github.io/LatentSpatialMemory/

Categories: 開源, 模型, 框架

SWE-Explore-Bench:拆解編碼代理如何理解你的程式碼

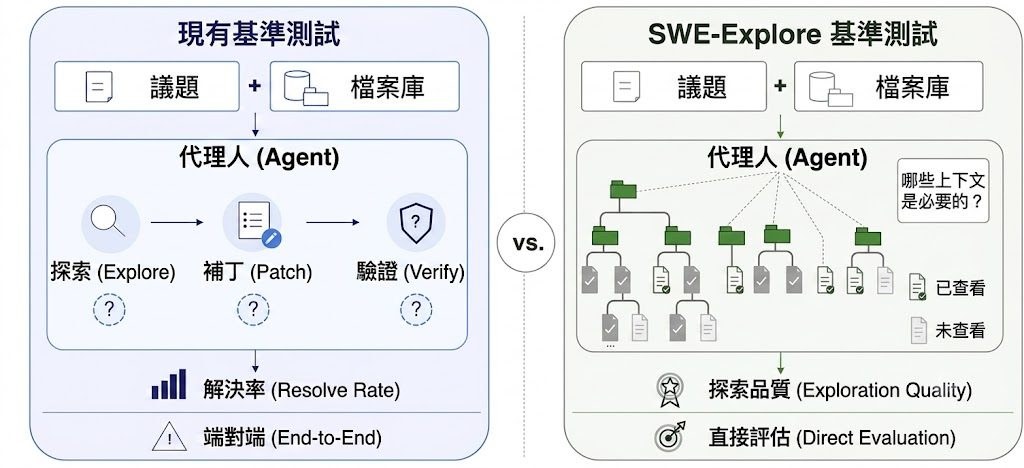
這個基準將編碼代理的探索能力獨立評分,以 848 個真實議題為基礎,衡量代理能否在動手修改前找對行級上下文。

SWE-Explore evaluates repository exploration directly instead of only end-to-end repair.

SWE-Explore-Bench 由上海交通大學、香港中文大學等團隊推出,專門考核編碼代理在「真正落筆修改前」探索程式碼庫的表現。現有的 SWE-bench 等基準只給出最終通過與否的二元結果,難以分辨代理是因為找對位置而成功,還是碰巧蒙對。這個項目把探索這一步抽離出來單獨計分,更貼近診斷代理能力的本質。

具體做法是收集同一議題的多條成功修復軌跡,從中抽取代理實際讀取的程式碼行範圍,整合出共識的核心上下文,再保留部分模型獨有的可選上下文。代理需要輸出一份按行範圍排序的程式碼區域清單,評分涵蓋覆蓋率、排序品質、上下文效率,以及下游受限修補驗證四個維度。這種行級監督比傳統的檔案級定位更細緻,能揭示代理的真正瓶頸。

資料集涵蓋 10 種程式語言、203 個開源項目中的 848 個議題,並提供 OpenAI 相容的端點,方便接駁不同 LLM 進行行範圍精修。實測結果顯示,具備代理能力的探索器明顯領先傳統檢索器,現代方法在檔案層級已相當成熟,但行級覆蓋與高效排序仍是區分頂尖方案的分水嶺。

適合關注 SWE-agent、AutoCodeRover、OpenHands 等代理框架的研究者、開發者及基準設計者使用。對想了解自家代理「讀碼環節」強弱的團隊而言,這是一個值得放入評測管線的參考項目。

GitHub: https://github.com/Qiushao-E/SWE-Explore-Bench

Paper: https://arxiv.org/pdf/2606.07297

Categories: 開源, 香港中文大學, 框架, 編程

GENEB 統整基因組模型評測:跨 100 個任務的統一比較框架

GENEB 以 100 個分類任務、13 個功能類別,統一評比 40 個基因組基礎模型的表徵能力,揭露排行榜不穩定、規模效益有限等關鍵發現。

Repository image for darlednik/GENEB

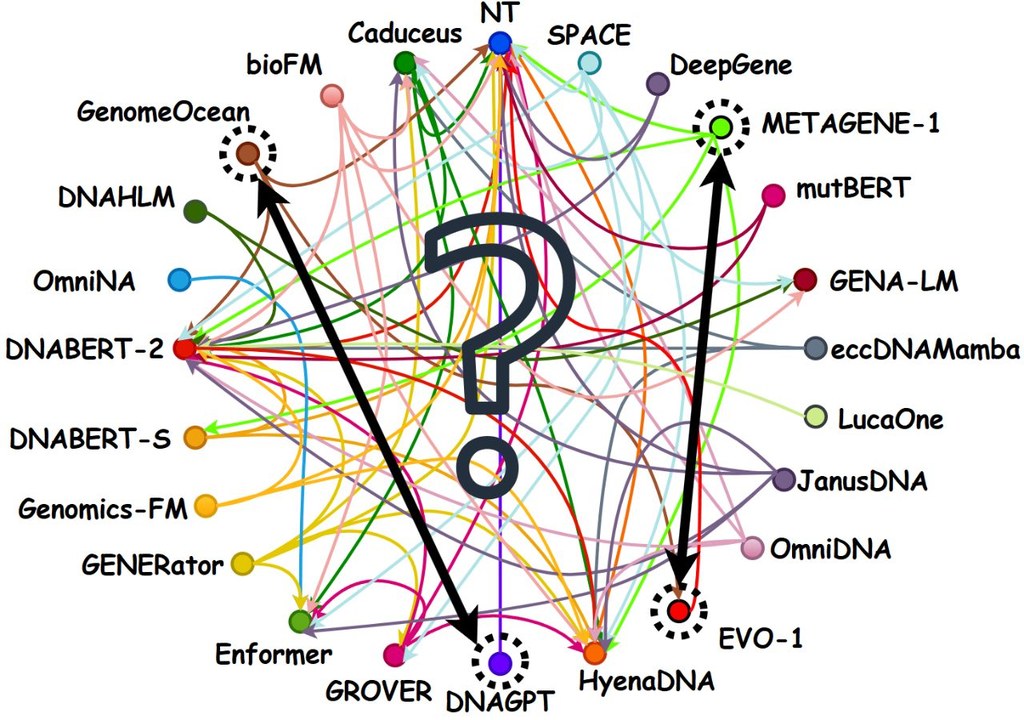
基因組機器學習近十年快速擴張,但模型之間的比較長期處於碎片化狀態。DARLEDNIK/GENEB 正是針對這項痛點設計的統一評測基準,收錄 100 個分類任務、橫跨 13 個功能類別,並透過線性探測(linear probe)方式,在完整、10-shot 與 1-shot 三種情境下評估預訓練模型凍結後的表徵品質。

這個項目最大的特色是統一了過往各家模型各自為政的評測協議。你只需在 harness/extractors/ 撰寫一個小型 embedding extractor,就能用 run_GENEB.py 在固定的 GENEB 任務資料上產生提交檔,並由 CI 自動驗證後合併到排行榜。提交的模型權重並不儲存在儲存庫內,僅保留評測結果與模型卡片,設計上兼顧了可重現性與第三方權重規範。

它可以支援訓練後的評估,例如你訓練完不同 genomic foundation models,拿 GENEB 來比較它們在多任務、多類別上的表現。

GENEB 對 40 個基因組基礎模型進行了系統性比較,包括 DNA-GPT、GENOMEOCEAN、EVO 等知名模型。研究發現,聚合排行榜其實相當不穩定:模型在不同任務類別的排名會大幅擺動,單一總分容易掩蓋細節差異。論文也指出,模型規模帶來的提升有限且不一致,架構與預訓練資料的對齊程度,往往比參數量更影響下游表現。這些結論對領域內「愈大愈好」的直覺提出了務實的提醒。

這個項目特別適合基因組學領域的研究者、模型開發者,以及需要為下游應用挑選合適表徵的工程團隊。對於想了解現有基因組模型相對強弱的人,Hugging Face Space 上的排行榜提供了 macro 分數與單任務分數兩種視角,方便依功能類別做選擇。

重點摘要:

  • 涵蓋 100 個任務、13 個功能類別,並支援 full、10-shot、1-shot 三種評測設定。
  • 採用線性探測協議,統一比較 40 個基因組基礎模型的凍結表徵。
  • 透過 embedding extractor 介面與 CI 流程,確保新模型提交的可重現性。
  • 論文分析顯示聚合排行榜不穩定,模型排名隨任務類別大幅變動。
  • 規模效益有限,架構與預訓練對齊對表現的影響往往大於參數量。

GitHub: https://github.com/darlednik/GENEB

項目: https://huggingface.co/spaces/darlednik/geneb-leaderboard

Categories: 開源, 框架, Medical醫學

SoCRATES:量度 LLM 調解能力的新基準

SoCRATES 用真實衝突場景測試 LLM 調解表現,重點看它能否因應情緒、背景與互動變化作出介入。

Data Intelligence System Lab

SoCRATES 是一個用來評估 Large Language Models(LLMs)在社會衝突中擔任主動調解者的 benchmark。它關注的不是單次答題表現,而是調解過程:兩方在對話中情緒、意圖與情境會不斷改變,模型需要判斷何時介入,以及應該說甚麼,並且不能偏幫任何一方。

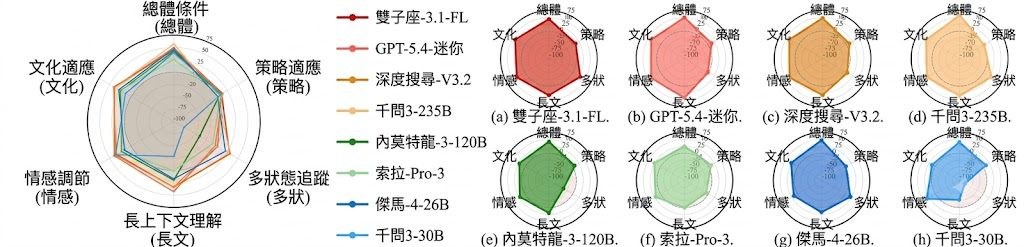
現有測試環境太單一,很多只涵蓋少量由專家撰寫的場景,或者把每一句對話都拿去對照所有議題評分,令結果混入不相關訊號。SoCRATES 則以 agentic pipeline 把真實公開爭議整理成場景,覆蓋八個衝突領域,並沿五條 socio-cognitive axes 測試模型在不同條件下的調整能力。

評分部分採用 topic-localized evaluator,只會在真正推進某個議題的回合上計分,並以三個 metrics 量度調解貢獻,減少離題內容影響結果。

  • 以真實公開衝突建立場景,不限單一領域
  • 測試 strategic posture、party composition、history length、emotional reactivity、cultural identity 五種變化
  • topic-localized evaluator 與人類專家的一致度達 0.82
  • 測試八個 frontier LLMs,最強模型亦只填補約三分一未調解時的共識落差

從目前結果看,SoCRATES 適合研究 LLM 調解能力、社會互動能力與多情境適應性的團隊使用,也適合用來比較不同模型在複雜對話任務中的穩定性。數據顯示,表現會因 socio-cognitive axis 明顯波動,說明這類項目的關鍵不只是語言生成,而是能否隨不同人、不同情緒與不同背景作出合適調整。

項目: https://disl-lab.github.io/SoCRATES/

Categories: 開源, 框架

DIRECT:可調 3D 角度的物件插令合成更自然

DIRECT 以 3D 代理配合分解式條件注入,讓物件插入既可控又自然。它同時兼顧姿態調整、外觀保留與場景融合。

DIRECT Logo

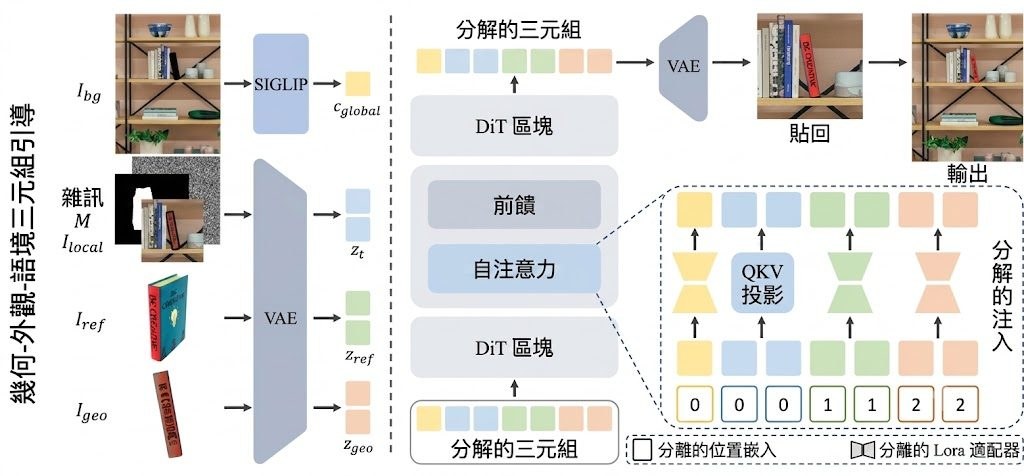
DIRECT(Decomposed Injection for Reference Composition and Target-integration)是一個用來把參考物件放入背景圖片的生成項目,重點不是單純補圖,而是加入明確的 3D 控制。網頁內容指出,現有 diffusion-based 方法多數把這類工作當成 2D inpainting,畫面雖然好看,但物件角度與空間位置較難精準控制。

DIRECT 先把參考物件提升成可互動的 3D proxy,讓使用者在目標場景內直接調整姿態,再把調整後的結果渲染成 geometry guidance。之後,生成器會同時接收參考物件的 appearance guidance、3D proxy 提供的 geometry guidance,以及背景圖片的 context guidance,合成最終插入效果。

它的核心創新在於 decomposed injection,把不同條件分開經由獨立路徑注入,而不是混在一起處理。這樣可減少 feature entanglement,較有機會同時保留原物件外觀、跟隨指定姿態,並令物件更自然融入目標場景。

重點可先留意以下幾點:
– 支援 pose-controllable object insertion,可直接調整物件姿態
– 以 reconstructed 3D proxy 提供明確幾何引導
– 把 appearance、geometry、context 三種訊息分開處理
– 附有 automated data construction pipeline,以提升訓練資料多樣性與質素
– 頁面表示在 geometric controllability 與 visual quality 上優於以往方法

這類項目特別適合影像合成、視覺生成、商品展示與內容製作等場景,當你需要指定物件朝向、位置感與場景一致性時會較有用。若你想跟進研究與重現結果,頁面已提供 Paper、Code,Model 與 Dataset 則標示為 soon。

GitHub: https://github.com/Gong1130/DIRECT

項目: https://gong1130.github.io/DIRECT/

Categories: 影像處理, 框架, 3D

PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

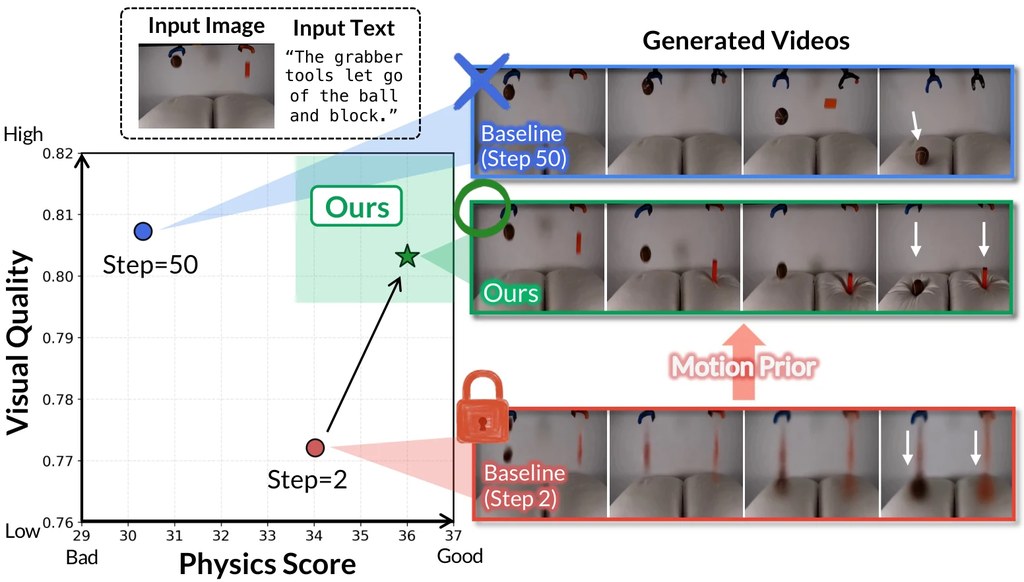
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time、1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1。

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

圖片編輯也要動腦?RE-Edit 幫 AI 學會看邏輯

RE-Edit 是針對圖片編輯推出的多維度推理基準,由浙江大學與香港大學團隊共同推出,並附帶 EditRefine 後修補方案。

Front Page

現時不少 AI 圖片編輯工具,表面上改得唯肖唯妙,細看卻經常出現「睇落合理、其實犯駁」的情況。來自浙江大學 ReLER Lab 與香港大學的團隊推出 RE-Edit,正是針對這個盲點而設計的基準測試。

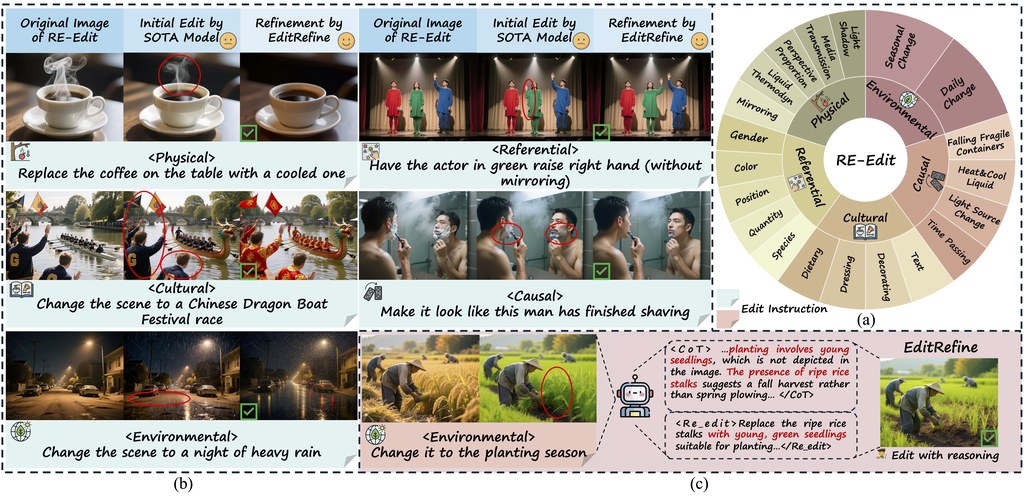
RE-Edit 全名為 REasoning-aware image Editing,包含 1,000 個精選樣本,並劃分成五個推理維度:物理(physical)、環境(environmental)、文化(cultural)、因果(causal)和指涉(referential)。每一條題目都刻意設計成「畫面睇落合理,但忽略了潛在邏輯」的情境,用以測試模型能否理解指令背後的隱含限制。

配合基準,團隊亦提出輕量級的後修補方案 EditRefine。做法是先讓多模態大型語言模型(MLLM)診斷初稿失敗之處,再產生帶有思維鏈(chain-of-thought)的重新編輯指令,由原本的擴散模型執行。這個「診斷—重做」流程可以套用在 FLUX.2 Dev、Qwen-Image-Edit 等不同執行器上,毋須重新訓練底層模型。

整套系統以 YAML 設定檔驅動,輸出會保留原圖、初稿、EditRefine 修補稿、chain-of-thought 文本以及重新編輯指令,方便逐個維度比對。對從事 AI 圖像編輯研究、產品測試或內容審核的團隊而言,RE-Edit 提供了一個可量化邏輯錯誤的測試場;對一般讀者來說,它提醒我們「改張相」背後其實牽涉文化、物理因果等多重常識。

重點摘要

  • 1,000 個樣本橫跨五個推理維度,專門捕捉「畫面合理但邏輯犯駁」的失敗案例。
  • EditRefine 以 model-agnostic 方式插入推理步驟,可搭配 FLUX.2 Dev、Qwen-Image-Edit 等不同模型使用。
  • 評審採用 Qwen3-VL-30B 對 IF、SC 等指標作自動化判分。
  • 設定檔以 YAML 管理,輸出包含初稿、refined 稿、CoT 文本與重編指令,方便追溯。
  • 適合研究 AI 圖像編輯、內容審核及多模態推理的團隊作為統一基準。

GitHub: https://github.com/Yixuan-Ding-ZJU/RE-Edit

Categories: 開源, 香港大學, 影像處理, 框架

Page 20 of 26
1 … 18 19 20 21 22 … 26