JIT-Agent:讓模型即時寫出專屬代理框架

JIT-Agent-27B會按任務即時組合可執行的代理框架,令同一個 Agentic LLM 更貼近研究、辦公及規劃工作。

JIT-Agent

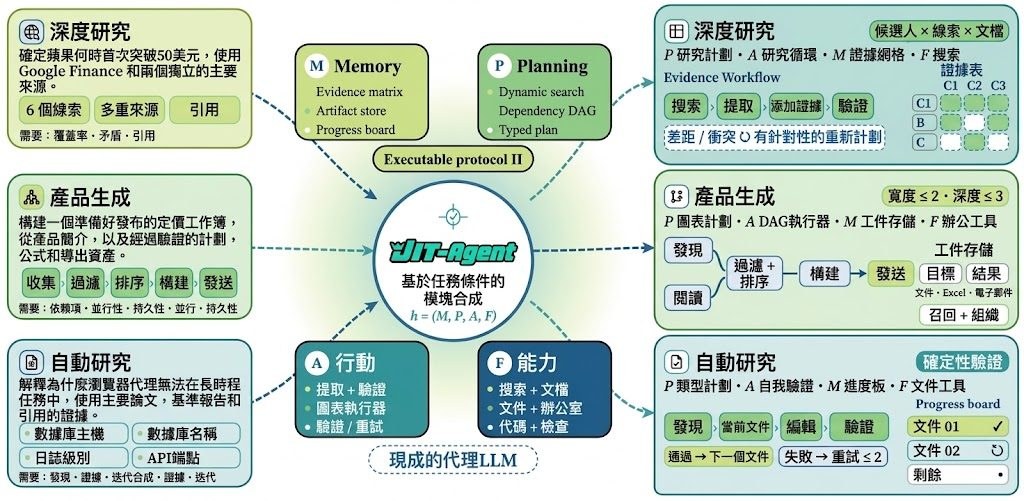
面對深度研究、日常工作或工作區操作等不同任務,固定不變的代理框架未必能有效轉用。JIT-Agent 屬於一個 meta-agent 模型項目,接收任務規格、協議、工具及技能註冊表,再為現成的 agentic LLM 生成特定任務的可執行 harness,處理代理流程難以適配的問題。

JIT-Agent-27B 並非直接取代底層模型,而是負責組合包裝模型的工作方式。每個 harness 由 memory、planning、action 及 capability orchestration 四個模組組成,並透過 HarnessFactory 的共享介面輸出結構化程式碼,避免每次都由模型自由撰寫整套代理程式。

  • 按任務生成不同的記憶、規劃和行動流程
  • 可包裝不同的 off-the-shelf agentic LLM
  • 測試期間會根據 trace 與 feedback 修訂 harness
  • 生成器保持 frozen,改進內容寫入 harness archive
  • 涵蓋研究、辦公、規劃及 workspace 類代理基準

同類方案通常先準備一個通用 scaffold,再期待它在不同任務中轉移;JIT-Agent 將可轉移的能力放在 harness 生成與演化,而不是只依賴 base model 擴大。代價是系統需要任務規格、工具註冊表、過往 harness 及測試回饋,生成品質亦會受這些輸入影響。

JIT-Agent 把 jit/、scripts/、harness_factory/、benchmark/ 及 dataset/ 分開,涵蓋生成與修復提示、代理核心、評估器和基準適配器。 JIT-Agent-27B 在九個代理基準中領先八個。適合研究代理架構、需要為多類工作測試流程的團隊,以及想比較「擴大底層模型」與「改進 harness」效果的人員。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 編程, Dataset 數據集

OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

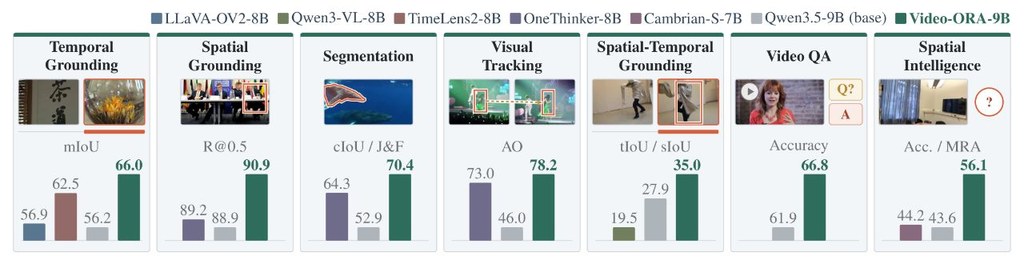
同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

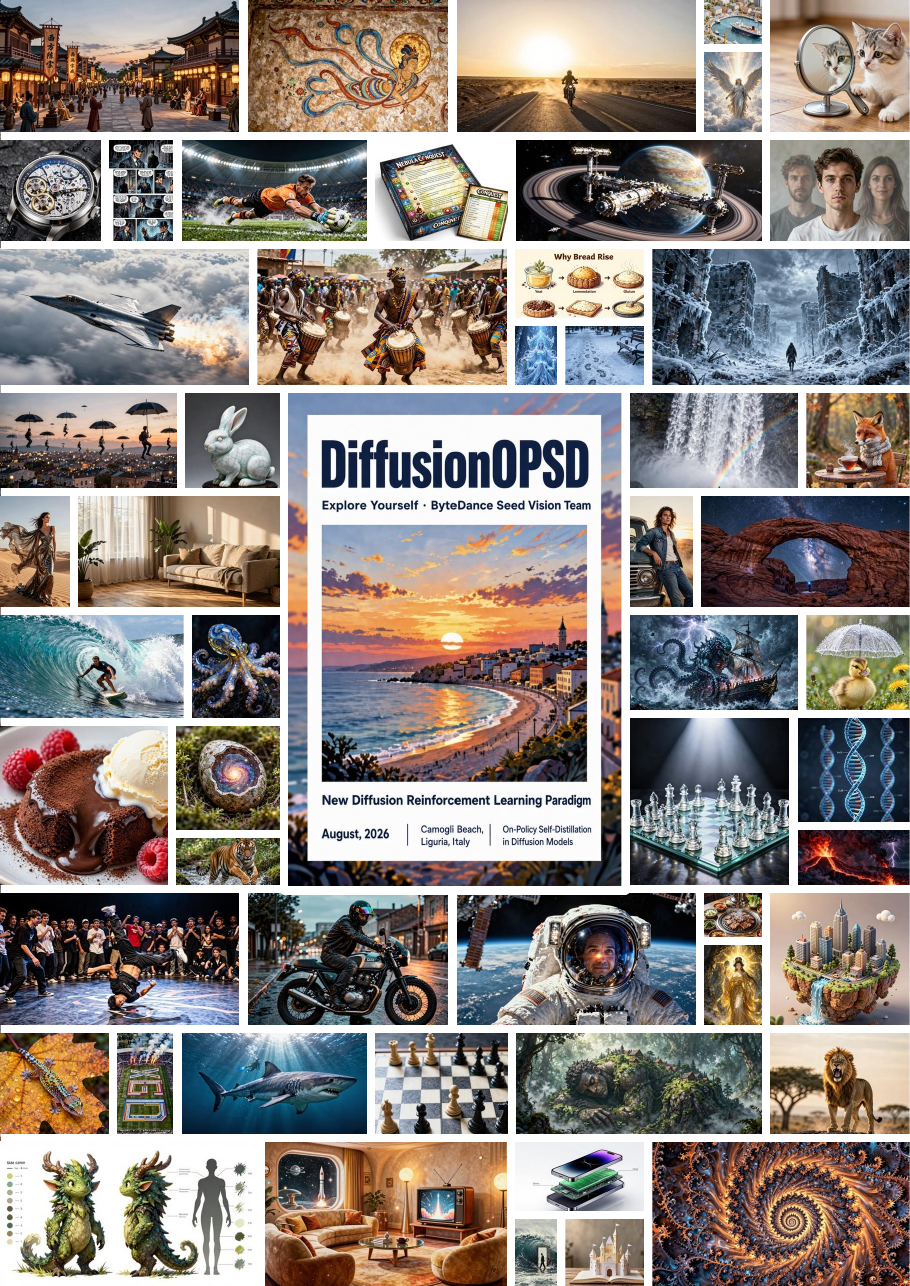
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

AutoSaddler 重新整理 LLM Agent Harness

AutoSaddler 會從執行失敗紀錄入手,幫 LLM agent 自動調整提示詞、工具同中介層。它唔只修一條路徑,仲會檢查改動能否推廣到其他情境。

AutoSaddler Overall Framework

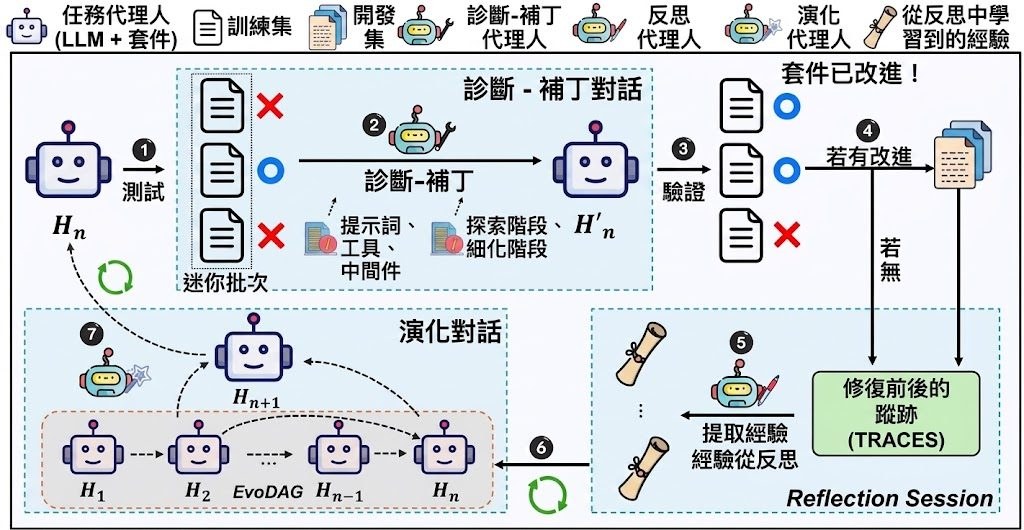
Microsoft 研究團隊聯同 POSTECH、KAIST 及南方科技大學開發 AutoSaddler,針對長流程 AI Agent 容易因小錯誤累積而失敗的問題,建立自動優化 harness 的方法。

AutoSaddler 係一個用嚟自動優化 LLM agent harness 嘅開源項目,處理嘅係長流程任務入面,agent 因為提示詞、工具或控制邏輯有少少偏差,就一路累積錯誤而失敗呢個問題。佢唔係單靠反覆改 prompt,而係將 harness 當成程式去診斷同修補。

佢會分析執行 trace,找出失敗根源,再按既定補丁分類去改 prompts、tools、middleware 同 agent-loop logic。資料夾同 佢用 durable、plugin-based 方式記錄狀態,適合要反覆試驗、回復同追蹤修改歷程嘅工作流。

同類方法通常只改少量提示詞,AutoSaddler 就將搜索範圍擴大到整個 harness,仲會用 validation 去挑選較能泛化嘅更新。初步結果顯示,佢喺 GAIA2、SWE-Bench Pro 同 Terminal-Bench 2.0 都帶來約 9 到 10 個百分點嘅 Pass@1 提升。

對做 agent 系統、評測框架或者自動化工作流嘅團隊特別有用,因為佢處理唔係單一模型輸出,而係整套執行環境點樣更穩定。項目要求 Python 3.12-3.14、uv 同 Git,官方建議用 uv run 去執行 Python 指令,代表佢偏向可重現同可追蹤嘅研究與工程整合。

  • 以 failure trace 診斷問題,唔係淨係做表面反思
  • 改動範圍包括 prompt、工具、middleware 同 agent loop
  • 會驗證更新喺其他情境可唔可以保持效果
  • 初步 benchmark 結果顯示有明顯提升
  • 適合要持續調整 LLM agent harness 嘅團隊

項目主頁 · GitHub

Categories: 開源, Agentic, 微軟, 框架, 工具, Python, Dataset 數據集

AutoResearch:AI 研究由構思變成可審查證據

由研究方向發掘、實驗執行到獨立評估,AutoResearch 將一連串研究工作串成可追蹤流程。

AutoResearch workflow from a research idea to reviewable evidence

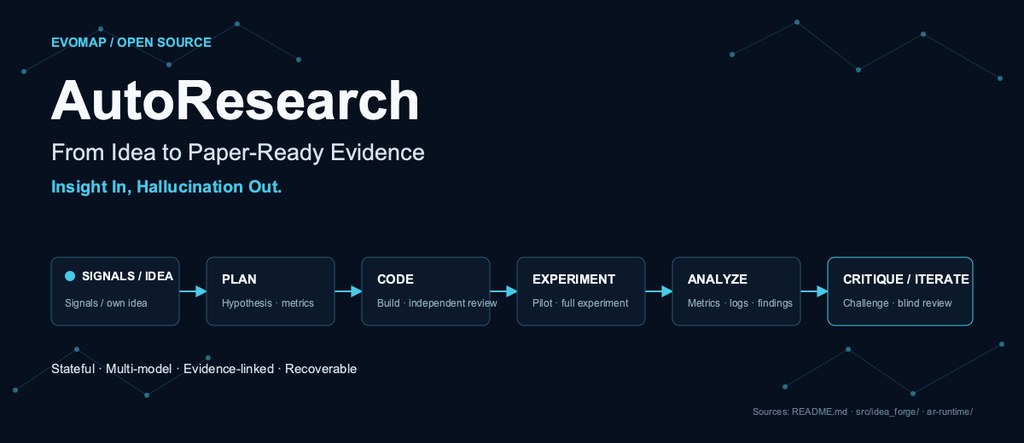
研究者只需提供一個想法,或者讓系統從近期論文、開發者社群及開源趨勢尋找方向,便可把研究構思推進至實驗計劃、程式碼、結果分析和獨立評估。AutoResearch 屬於開源的 AI and machine learning agent workflow,處理的是研究流程分散、難以重現,以及結果未有足夠證據支撐的問題。

流程不止於叫模型產生一份研究計劃。它會整理、去重和篩選網上訊號,再結合 knowledge base/ 內由使用者維護的研究經驗、限制和常見失敗模式,產生候選方向,經過 cross-review 後制定實驗計劃。已有研究想法的團隊亦可以略過發掘階段,直接執行指定項目。

研究計劃、程式碼、run logs、metrics、失敗原因、critic reports 和 blind reviews 都會寫入磁碟,流程亦具備 stateful、recoverable 特性,方便研究者檢查中途結果、接手工作或停止執行。這比一次過要求模型寫完整論文更適合需要反覆試驗的研究項目,但成果質素仍取決於模型、API、資料來源和實驗環境,不能把自動產出的證據視為已完成同行審查。

  • 從近期論文、社群討論及開源趨勢收集研究訊號
  • 以本地 knowledge base/ 補充領域經驗和限制條件
  • 支援由 idea generation.py 啟動構思、篩選及結果更新
  • 透過 config/providers.local.json 配置 endpoint、model alias 和角色模型
  • Python 3.10+,並要求把含 API URLs、keys 和 proxies 的 .env 留在本機

對個人研究者、小型 AI 團隊及需要大量驗證想法的實驗室,AutoResearch 可減少整理資料、安排實驗和記錄結果的重複工作。它更像一個可接管的研究協作流程,而不是單一模型;要測試完整能力,應先準備本地知識庫和模型供應商設定,再由一個小型研究方向開始,檢查生成計劃、執行記錄及獨立評估是否足以支持後續寫作。

GitHub

Categories: 開源, Agentic, API, 框架, Python

PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

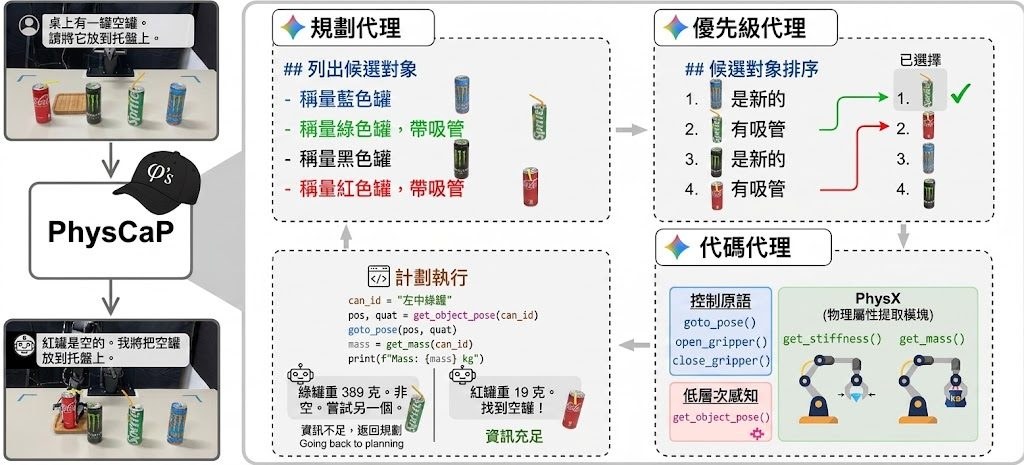
當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_mass 和 get_stiffness。

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。

項目主頁

Categories: Agentic, 模型訓練, Google, NVIDIA, World-Action Model, Robotic, 框架, Dataset 數據集

ComfyUI-MiniMaxH3-Contex-Loop:讓 MiniMax H3 多場景影片可重試續作

把多場景影片拆成可審核、可重試的製作流程,減少一次渲染失敗便要由頭再做的浪費。

MiniMax H3 Contex Loop v0.5 — scene plans that survive the render

多場景影片最麻煩的地方,往往不是生成單一鏡頭,而是其中一幕出錯後要重做整段流程。ComfyUI-MiniMaxH3-Contex-Loop 是一套開源 ComfyUI 工作流工具,利用一個可重用的 sampling body,按 scene Plan 逐幕生成 MiniMax H3 影片,並把已接受的片段從磁碟組合起來。

每個場景都可以獨立設定提示詞、seed、時間、圖片、動態影片及音訊參考;Review Gate 會讓使用者選擇批准、重試、reroll 或提早停止。candidate_count 亦可為單一場景生成多個候選,最後由使用者揀選指定 take,減少整條工作流反覆排隊的成本。

  • 支援中斷後 resume、partial assembly 及 atomic checkpoints
  • 可延續現有片段,處理 inpainting 和 two-ended bridges
  • Guide 與 protected AV-prefix transitions 有助維持畫面、動態及聲音連接
  • 支援 latent-to-PNG export,並可從已儲存資產恢復製作

v0.5 要求較新的 ComfyUI,包含原生 Add Guide for MiniMax H3。FFmpeg 放在 PATH 會較方便,沒有時可由 ComfyUI 內置 PyAV 處理 review 和 assembly,因此硬件、模型配置及渲染時間仍然是主要限制。倉庫目前以 main 作為支援的 0.5 發行線,已儲存的 0.4 workflows 和 checkpoints 仍然支援,較適合把生成流程分段管理的影片創作者及技術團隊。

GitHub

Categories: 開源, ComfyUI, AI productions, Video, Image, 框架, MiniMax

SparsePR 讓影片生成以稀疏注意力加速,毋須重新訓練

SparsePR 將稀疏注意力帶入四款影片模型,在維持生成質素的同時,把執行速度提升最多 2.61 倍。

Repository image for PardisTaghavi/SparsePR

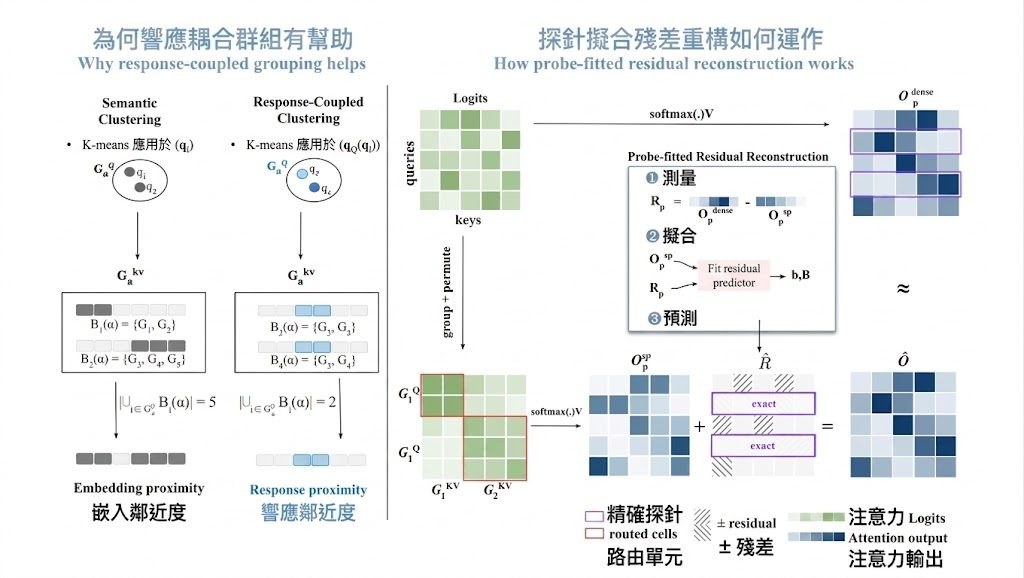
影片生成最吃資源的部分,往往不是提示詞或輸出格式,而是 Video Transformer 裏大量 Attention 計算。SparsePR 屬於 training-free sparse attention 參考實作,透過減少不必要的 query、key/value 互動,加速 HunyuanVideo-13B、Wan2.2-I2V-A14B、Cosmos-Predict2.5-14B 及 Cosmos3-Nano-16B,毋須額外訓練模型。

它沒有單純按注意力集中程度刪走區塊,而是以 Response-Coupled Partitioning 按目前回應分組,再用少量 exact probe rows 配合 Probe-Fitted Residual Reconstruction,補回稀疏計算遺漏的輸出。使用者可透過同一個介面,在 dense baseline 與 SparsePR 之間切換,直接比較影片質素、速度和顯存取捨。

  • 執行 pair density 約 21.9% 至 26.0%
  • 端到端速度提升約 1.48 至 2.61 倍
  • 涵蓋文字轉影片、圖像轉影片及 image-to-world 情境
  • 在 VBench 及 PBench 進行評估,部分 Cosmos-Predict2.5-14B 結果達 40.33 dB

項目要求 Linux,並建議使用 NVIDIA H100;HunyuanVideo、Wan2.2、Cosmos-Predict2.5 與 Cosmos3 需要分開的 CUDA 12.8 wheel 環境,原因是 Cosmos3 依賴較新的 Diffusers 和 Transformers。可選的 fused CUDA kernels 有助進一步執行,但安裝門檻明顯高於一般影片生成工具,模型 checkpoint 亦要從官方 Hugging Face 儲存庫取得。

SparsePR 適合研究影片生成效率、建立高端 GPU 推理基準,或需要在保留畫面質素下減少計算量的團隊。它目前仍是參考實作,支援模型和硬件環境較有限;對只有消費級 GPU、只想快速試玩影片生成的使用者,成本與環境配置可能抵銷加速帶來的好處。

項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Video, Image, 框架, Linux

InfinityEdit:支援多輪連續編輯嘅開源影片框架

InfinityEdit 將影片編輯變成連續接力,每個指令都在上一段結果上再延伸。它適合要處理長片段、持續畫面同多輪改動嘅場景。

Pianist source video thumbnail

InfinityEdit 係一個影片編輯框架,核心問題唔係單次改一段短片,而係面對持續流入嘅影片,連續套用多個指令,令後一段自然接住前一段,仲要保住畫面連貫。對做長片生成、直播式視覺改寫,或者需要一路加指令一路修正畫面嘅工作流程,佢處理嘅正正就係「編輯唔可以只限喺固定片段內」呢個限制。

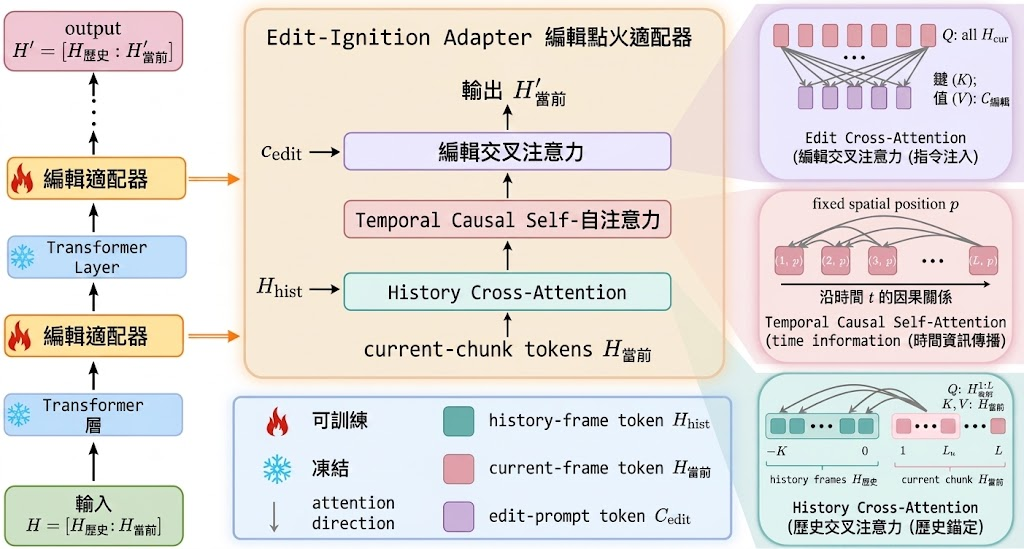
佢嘅做法係喺凍結嘅 video diffusion backbone 上面加一個輕量嘅 Edit-Ignition Adapter,令原本負責串流生成嘅模型多咗三層訊息路徑:歷史畫面引導、時間因果注意力,同埋編輯指令注入。生成時只會喺有新編輯指令到達嘅那一段啟動 adapter,之後嘅片段就交回原模型接力,記憶體負擔唔會一路膨脹。

項目提供訓練程式同多輪推理流程,安裝方法都幾直接,先建 Python 3.11 環境,再裝 requirements.txt,之後下載基座模型 Helios-Distilled。訓練分兩階段,第一階段學基本編輯能力,第二階段再針對低噪聲細節同時間權重做修正;推理則會輸出一串 source.mp4、edit_1、edit_2 之類嘅連續結果,方便睇到每次指令點樣疊落去。

同一般固定源片逐格改寫嘅方法相比,InfinityEdit 睇重嘅係「延續」而唔係「覆寫」。呢個取捨令佢更貼近長影片、持續鏡頭、反覆編修呢類工作,但亦意味住訓練資料要先做 VAE latent 同文字 embedding 預處理,流程比即插即用工具重少少。官方展示同評估都集中喺長片生成同多輪 sequential editing,顯示佢嘗試解決嘅唔係單次風格轉換,而係編輯累積後仍然保持穩定。

  • 支援多輪順序編輯,每次指令都建立喺上一段已編輯內容之上
  • 以凍結 backbone 配合輕量 adapter,改動集中,唔需要重寫整個生成模型
  • 適合長片生成、持續鏡頭改寫、分段式影片修正呢類場景
  • 訓練同推理都已經拆好流程,但前期資料預處理同模型下載仍然係必要步驟
  • 評估重點放喺長序列穩定性同編輯連貫性,而唔係單一片段嘅局部改動

對做影片生成、研究串流式編輯,或者想將文字指令一路疊加到同一條影片流嘅團隊,呢個項目提供咗一個較完整嘅技術路線。佢唔係追求一次過改到最盡,而係用較細嘅介入,令編輯可以一路接力落去,仲保持住原本生成器嘅長片能力。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Embedding, Video, 框架, Python

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

Page 13 of 34
1 … 11 12 13 14 15 … 34