EditVid:零訓練、單一框架處理五大影片編輯任務

伊利諾伊大學 PLAN Lab 推出 EditVid,毋須訓練即可在一個框架內完成風格轉換、屬性修改、物件插入等多種影片編輯。

PLAN Lab Logo

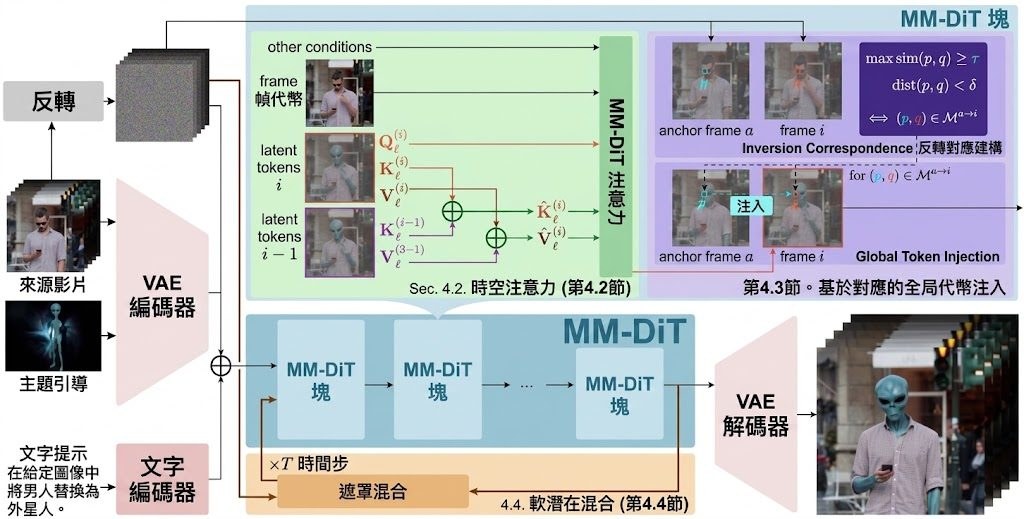
想用同一套方法幫一段影片換風格、改顏色、甚至換主體,又唔想為每種任務訓練專屬模型?PLAN Lab(伊利諾伊大學厄巴納-香檳分校)嘅 EditVid 正正就係為呢個煩惱而設計。佢屬於免訓練(training-free)嘅影片編輯框架,直接喺凍結嘅多模態擴散 Transformer(MM-DiT)圖像編輯器上動手術,同時支援文字指令引導同參考圖引導兩大路線。

對一般用家嚟講,最大體感差異係:一條原本只能用嚟改顏色嘅編輯鏈,現在仲可以做局部部件編輯、物件插入、主體替換等五類任務,唔使每樣重新煉模型。你叫佢「將大象變藍色」、「將海浪轉做黑色」、「將衣服轉紅色」,佢都能在同一條流程內完成。

佢能夠兼顧短距離同長距離一致性,關鍵在於三個互相配合嘅設計:

  • 稀疏因果記憶:每幀只向前一幀取視覺鍵值狀態,避免長距離 RoPE 交互變得唔穩定。
  • 後注意力 Token 注入:用置信度同循環一致性匹配把幀同錨點幀對齊,再注入匹配到嘅視覺表示,維持主體外觀一致。
  • 軟潛空間混合:根據時間步動態調整保留權重,源內容需要保留嘅地方唔會被強行覆蓋。

量化結果方面,喺 FiVE 基準上 EditVid 拎到 78.16 分 FiVE-Acc,比目前最強嘅訓練免費基準高出近 20 分;喺 IVEBench 上面亦取得具競爭力嘅成績。用戶研究入面,超過一半受訪者(51.8%)傾向揀 EditVid 而唔係其餘 7 種對比方法。

如果日常工作涉及大量短片二次創作、廣告素材改版、或者需要快速試驗唔同視覺風格,EditVid 提供嘅「零訓練、單一框架」思路可省卻大量前置準備成本。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 框架

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

Spark-X2.5:4B 參數追平 12B

Spark-X2.5-4B 用混合架構把 1M token 上下文塞進小模型,並在編碼與 Agent 場景追上 12B 等級對手。

Og image

Spark-X2.5-4B 由 XHToken 發佈,基礎模型標註為 XHToken/Spark-X2.5-4B-Base,屬於通用對話型 LLM,覆蓋寫作、翻譯、推理、編碼、工具調用與 Agent 工作流。「小模型也能扛長上下文」這條路線:採用 1 層全注意力 + 3 層滑窗注意力(sliding-window attention)的混合架構,把長序列的計算成本壓低,同時原生支援最長 1M token 上下文。對本地開發者而言,這代表不必依賴昂貴的長上下文方案,也能處理長文檔或多輪 Agent 記錄。

模型在 Agent 整合上做了明確適配,與 Codex、Claude Code、OpenClaw、Hermes 等主流 agent harness 對齊,讓它在編碼與工具調用評測中,在同尺寸開源模型裡取得領先位置。對想自架本地 Agent 的人來說,這層適配省去不少 prompt 與調用格式的微調工作。

部署兼容性是它的另一個賣點:原生支援 NVIDIA、華為、海光、HOUMO.AI 等硬件平台,推論框架覆蓋 vLLM、SGLang、llama.cpp、MLX,亦可透過 Ollama、LM Studio 快速啟動。頁面提供 Hugging Face Transformers 格式的權重與配置,授權為 Apache-2.0。

Spark-X2.5-4B 適合追求長上下文與 Agent 能力、又受限於硬件預算的開發者,但要實際部署前宜留意量化檔案與推論引擎的官方更新。

重點摘要:
– 基礎模型:基於 XHToken/Spark-X2.5-4B-Base 微調的對話模型
– 混合注意力架構:1 層全注意力 + 3 層滑窗,原生支援 1M token 上下文
– Agent 整合:適配 Codex、Claude Code、OpenClaw、Hermes 等主流 agent harness
– 硬件與推論支援:涵蓋 NVIDIA、華為等平台,兼容 vLLM、SGLang、llama.cpp、MLX,可走 Ollama 與 LM Studio
– 授權:Apache-2.0;頁面未列出 GGUF 量化檔,部署前需留意官方或社群進度

項目主頁 · 項目

Categories: 開源, Agentic, 模型, 框架, OpenClaw

Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

Motion-Omni framework

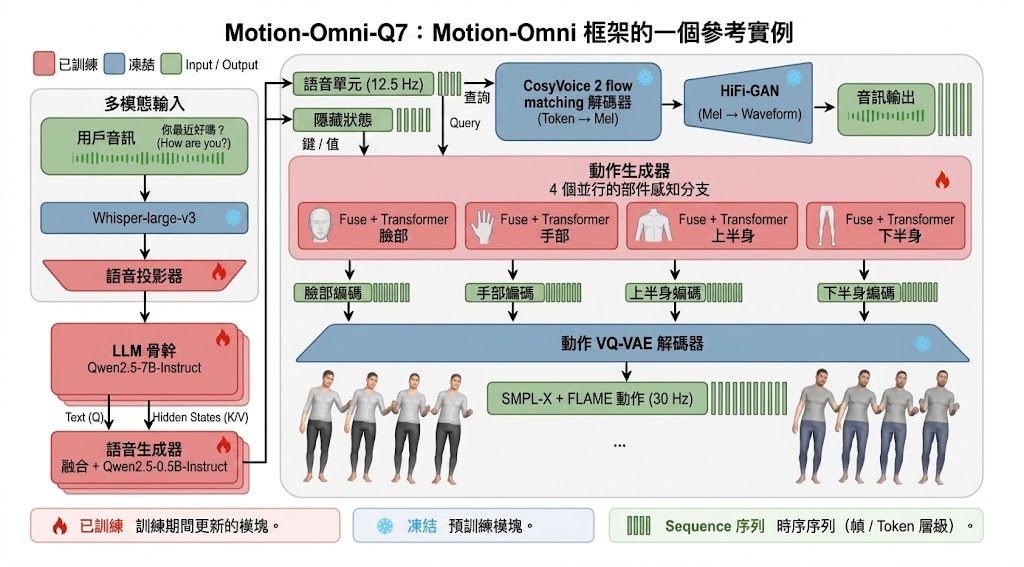
試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

MiniMax-H3-Motion-Director 全能導演台節點

ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

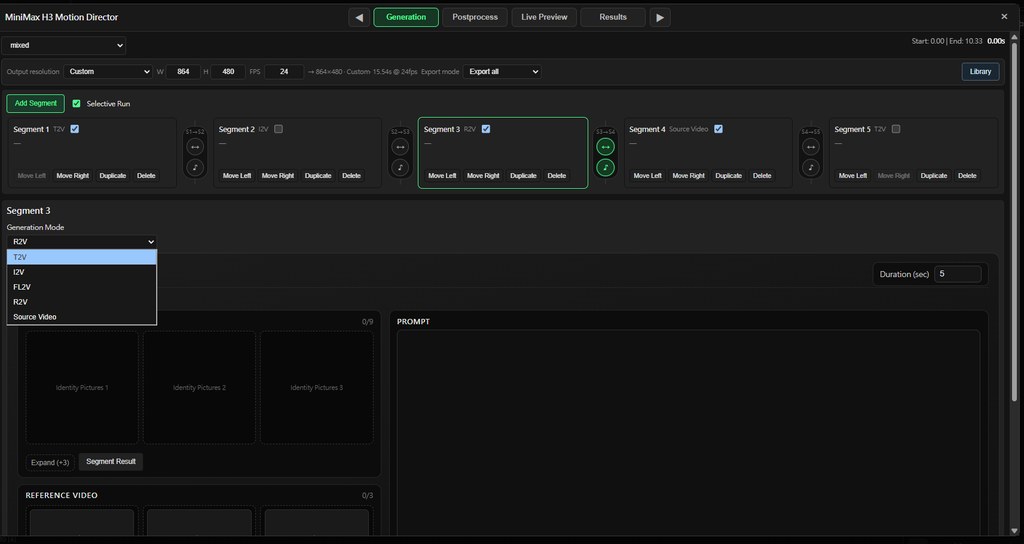
用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。
另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求

GitHub

Categories: 開源, ComfyUI, AI productions, NVIDIA, Video, 框架, 庫, MiniMax

VLA 模型只學動作不夠,INDI 把「意圖」蒸進解碼器

POSTECH 提出的 INDI 框架,將行為意圖從凍結的教師視覺語言模型蒸餾到 VLA 動作解碼器,讓機器人部署時不需教師也能自主推斷行為目標。

Repository image for Leesangoh/INDI

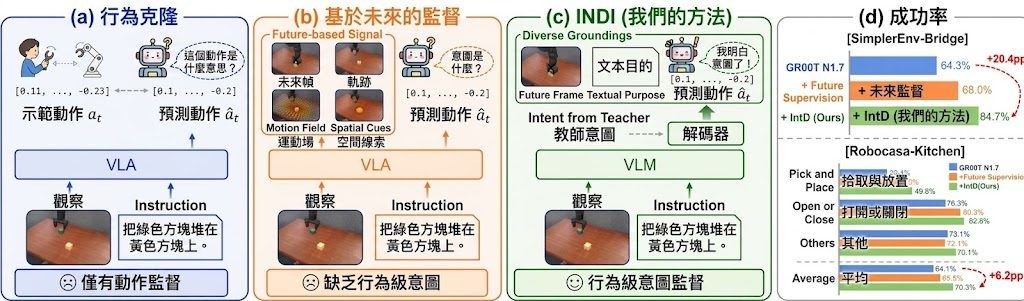
機械人模仿學習長期面對一個老問題:VLA(Vision-Language-Action)模型靠行為克隆訓練時,往往只學到「要做出什麼動作」,卻忽略了「為什麼要做這個動作」。POSTECH 團隊提出的 INDI(Intention Distillation),正正想修補這個缺口。

做法上,訓練期間會有一個凍結的教師視覺語言模型(VLM),負責將示範片段解讀為意圖表徵;動作解碼器則在中間層同時學習還原這個意圖與預測動作。部署階段不需要帶著教師模型,策略網絡自己就能從標準 VLA 輸入還原意圖並執行。對比傳統行為克隆或加入未來幀、軌跡這類「未來監督」做法,INDI 蒸餾的是行為背後的共同語義目標,而非某一種可能的實現。

實驗結果顯示,INDI 將 GR00T-N1.7 在 SimplerEnv-Bridge 的成功率由 64.3% 提升至 84.7%,在 RoboCasa Kitchen 也由 64.1% 升至 70.3%,π0.5 兩個基準皆有穩定增長。真實機械人任務平均成功率由 62.0% 提升至 68.7%,長時序任務最高有 12 個百分點的改善。研究團隊亦驗證還原出的潛在變量確實被解碼器使用,並能捕捉行為目標與執行進度。

對從事機械人基礎模型、VLA 微調,或關注長時序操作任務的團隊而言,INDI 提供了一條不增加部署成本、只改訓練目標的改良路徑。

INDI 重點摘要:

  • 意圖蒸餾而非動作模仿:用凍結教師 VLM 把行為意圖蒸進解碼器中間層
  • 部署零負擔:推理階段不需要教師模型,策略網絡自行還原意圖
  • 跨基準穩定提升:GR00T-N1.7 與 π0.5 在 SimplerEnv-Bridge、RoboCasa 皆有增長
  • 真實場域驗證:真機任務平均成功率提升約 6.7 個百分點,長時序任務最高 +12pp
  • 潛在變量可解讀:還原出的中間表徵與行為目標、執行進度高度相關

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, VLA, Robotic, 框架

OpenMAIC:把課堂內容變成多代理互動教學

把主題或文件直接轉成可互動課堂,連投影片、測驗和小組活動都一併生成。它更像一個面向教學流程的多代理 AI 平台。

OpenMAIC

OpenMAIC 是一個多代理 AI 教學平台,處理的是把零散素材快速整理成可教、可互動的課堂內容。使用者只要輸入主題,或者上傳文件、音訊、影片,再加上網頁搜尋素材,系統就會組織出投影片、測驗、互動模擬和專題式學習活動,並由 AI 老師和 AI 同學在課堂內即時互動。

它和一般內容生成工具的分別,在於不只產出講義,而是把整個教學流程串起來。OpenMAIC 內部採用 chat-first 的工作區,支援持久化 session,任務可以在伺服器重啟後繼續,亦可中途取消、回復和調整,較適合需要反覆修訂課程的教育團隊、培訓人員和內容製作人。

  • 可由文字主題或外部素材直接生成完整課堂
  • 支援投影片、測驗、互動模擬、PBL 和 .pptx 匯入
  • 接入 OpenClaw 後,可由 Feishu、Slack、Telegram 等訊息工具建立課堂
  • 可自行接入模型、媒體、搜尋供應商和儲存後端
  • 官方提供 Live Demo,亦可用 Vercel 一鍵部署
OpenMAIC GitHub Setup Guide: From Text Prompt to Local MP4 Classroom Export

OpenMAIC 以多代理協調做編排,並結合 LangGraph、Next.js、React 和 TypeScript。超過 20 項內建技能,定位不是單純聊天機械人,而是把教學內容生產、互動和發佈收束到同一條工作流。

GitHub

Categories: 開源, Agentic, 框架, 教學, LangGraph, OpenClaw

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

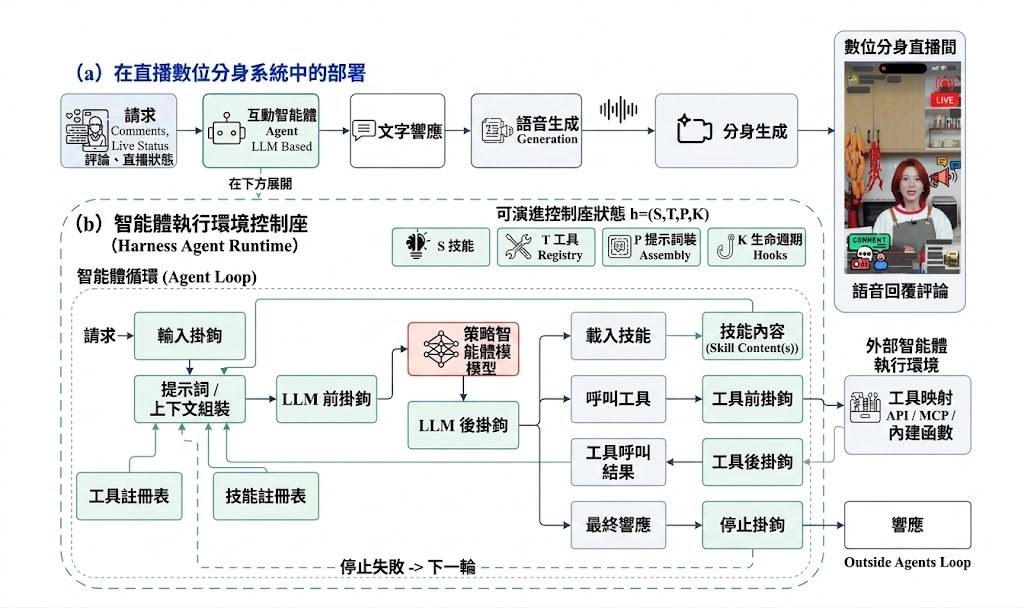
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

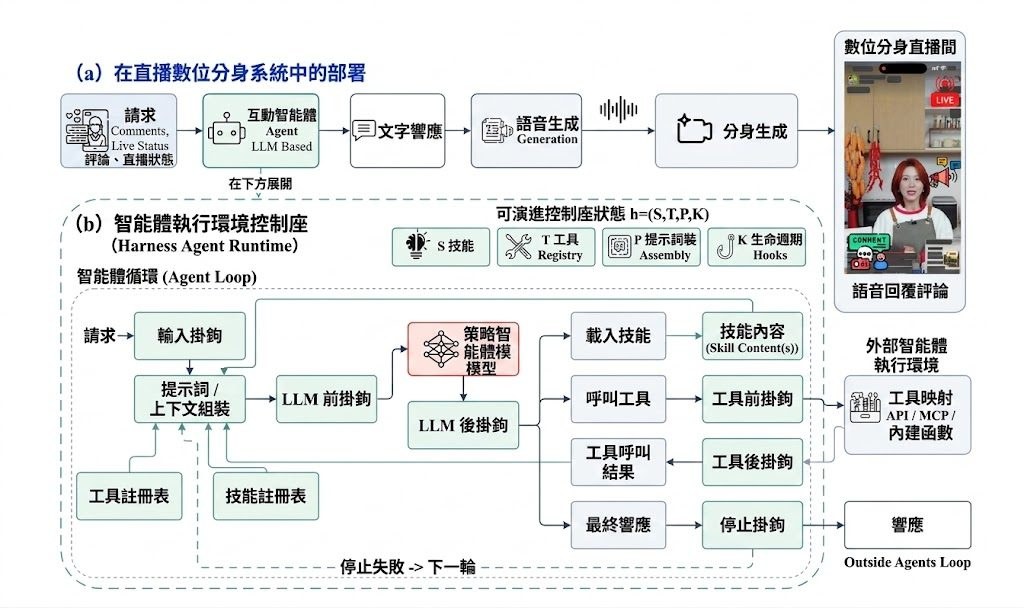
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

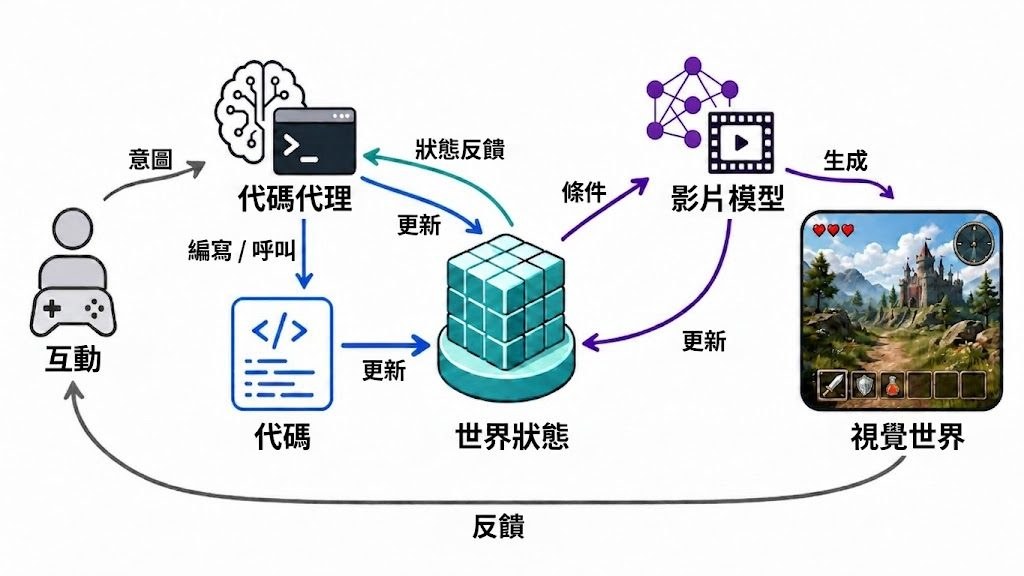
當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

Page 12 of 34
1 … 10 11 12 13 14 … 34