ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

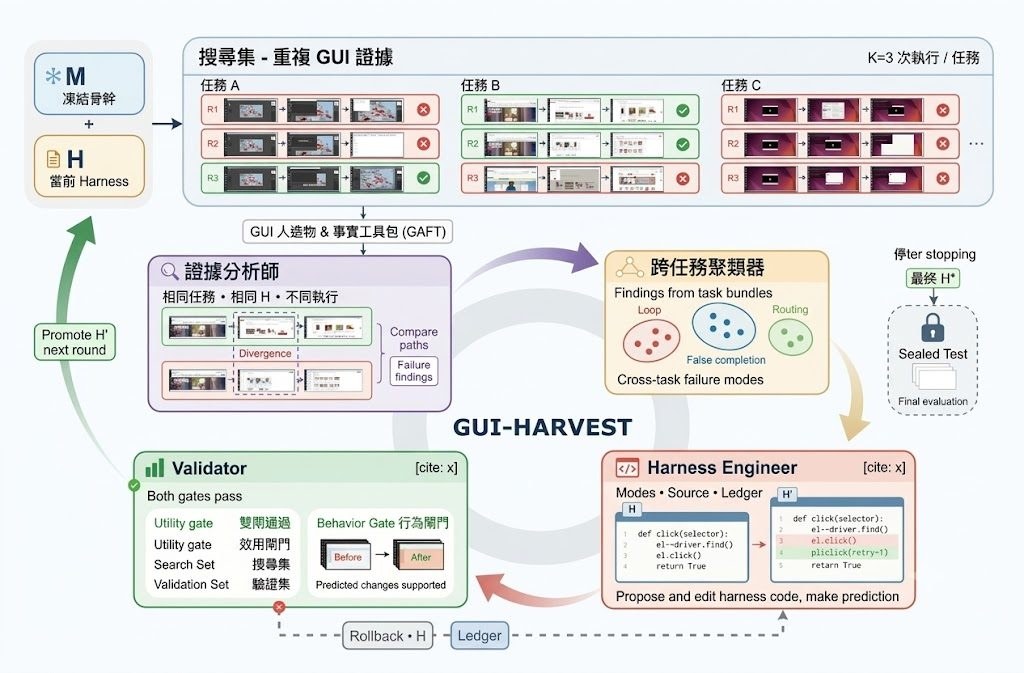
GUI-HARVEST overview

當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。

promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

ProAR 讓影片模型先想目標再生成

ProAR 把自回歸影片生成變成視覺推理流程,兼顧最終目標與中間步驟的合理性。

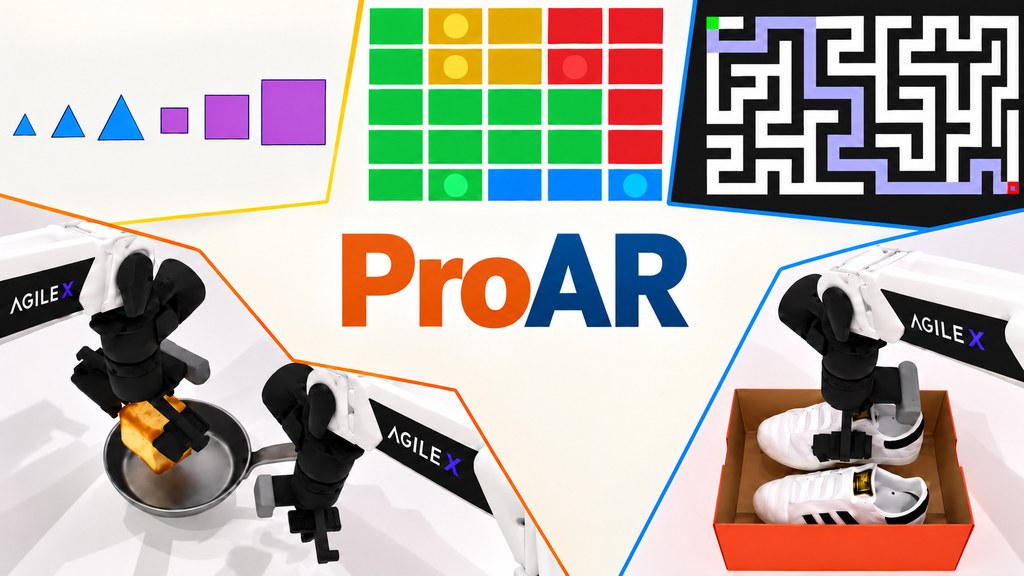
ProAR overview

當影片模型只按過去畫面逐步預測,畫面即使局部合理,也未必能完成指定任務。ProAR 屬於自回歸影片模型項目,透過 prospective reasoning 預測未來視覺狀態,處理長程目標與中間轉換容易失控的問題。

ProAR 以 Wan2.2-TI2V-5B 作為共享 backbone,加入兩條互補機制:outcome guidance 會一同預測未來 goal frame,讓目前 chunk 參考目標信念;transition guidance 則在訓練期間利用 predictor,令目前 hidden states 對齊乾淨的 next-chunk representation。前者偏向長距離規劃,後者補足短距離的狀態銜接。

• Outcome guidance 幫助生成結果符合任務目標
• Transition guidance 鼓勵中間步驟遵守時間及物理邏輯
• 推理時不需要真實未來畫面,訓練用 predictor 會移除
• 項目提供模型 checkpoint、ProAR-test 數據集及 VBVR-10Tasks 實驗配置

要測試項目,需要 Python 3.10、PyTorch 2.8.0,並把 Wan2.2-TI2V-5B 權重、VAE、T5 編碼器及 tokenizer 放到指定本地路徑;flash-attn 屬於可選的加速元件。這套流程較適合研究視覺推理、物理推演及 embodied intelligence 的團隊,未必是即裝即用的影片創作工具。

提供的資料確認了 AR 與 ProAR checkpoint,以及 VBVR-10Tasks 和測試數據集,但未列出足夠的數值結果,難以單憑儲存庫內容判斷提升幅度。推理時間會增加,換來模型在生成前預測目標及未來轉換;取捨是否合理,要視乎任務是否重視步驟有效性多於生成速度。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, AI productions, 模型, 模型訓練, 微軟, Video, 香港, 工具, Python, 庫, Dataset 數據集, Tokenize

MotorMind-Code:通用視覺語言模型零樣本操控機械人

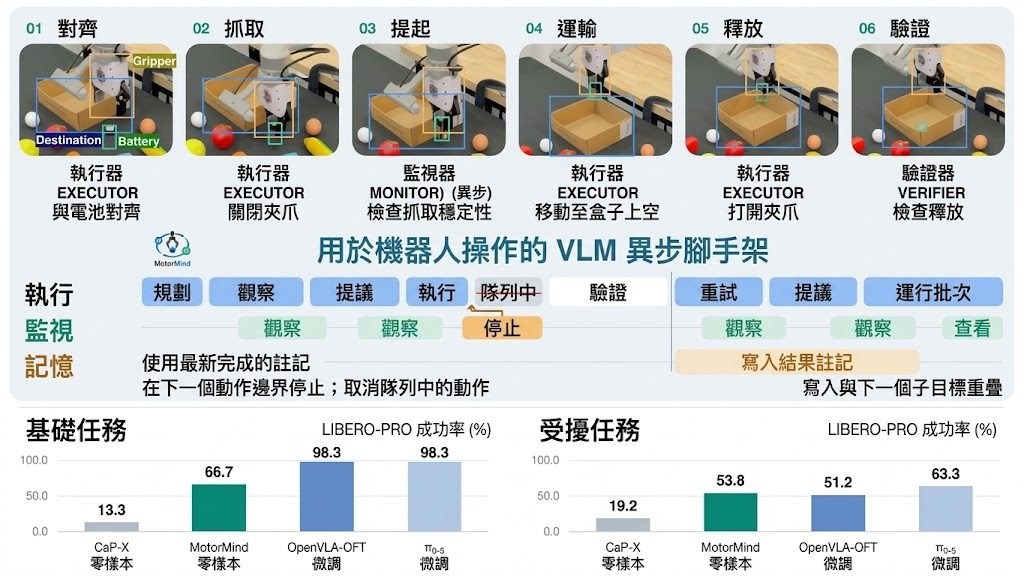
MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

ScientificSlop:AI 論文不只要讀得順,也要檢查證據是否接得上

SciSlop 把焦點放在 AI 論文的論證、結構與研究材料,並以 390 組人類與 AI 論文測試能否辨認科學內容中的空洞之處。

Repository image for yerimoh/ScientificSlop

一篇論文即使句句通順,論點、方法和證據仍可能接不上。SciSlop 是一套衡量 AI 生成論文科學內容品質的評估工具,從結構、論證和研究材料三個面向檢查六種問題,而不是只判斷文字像不像 AI 所寫。

配套的 SciSlopBench 收錄 390 組 AI 生成論文與人類撰寫論文,讓研究者比較不同評分方法分辨兩者的能力。已釋出的分數中,SciSlop 的配對準確率為 0.859;作為基準的 Binoculars 為 0.687。這是特定測試集上的結果,不能直接解讀成工具能判定任何論文真偽。

另一部分 SciSlopHarness 會引導固定的大型語言模型修改論文,但只在實驗紀錄能支持修改時才動筆。這個限制有助避免模型為了讓文字看起來更好而擅自改變研究主張;不過,現有說明沒有提供足以判斷修改品質的完整數字。

儲存庫同時提供基準資料、評估程式、比較用的偵測器與自動審稿系統,以及分析 2017 至 2026 年 ICLR 審稿分數和決策的程式。資料以三個 Parquet 表格釋出;安裝 Python 依賴後,可先讀取分數表重算配對準確率與 AUROC,再按文件流程重跑部分確定性指標。GPU 套件屬可選項,模型相關指標則可能需要外部模型呼叫。

  • 六項指標涵蓋結構、論證與研究材料。
  • SciSlopBench 包含 390 組配對論文。
  • 公開分數中的配對準確率為 0.859,高於 Binoculars 的 0.687。
  • SciSlopHarness 只在實驗紀錄支持時才修改內容。

對研究團隊而言,這套工具適合用來檢查 AI 輔助寫作是否削弱論證連貫性,也能作為研究論文評估方法的測試材料。項目應視為研究用途,不能取代專家對方法、證據及引用的審閱。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 工具, Python, 庫, Dataset 數據集

ScienceUtopia:研究科研政策、利益衝突

ScienceUtopia 讓語言模型扮演研究者,在選題、審稿與資助循環中觀察科研社群如何演變。

Repository image for Ahren09/ScienceUtopia

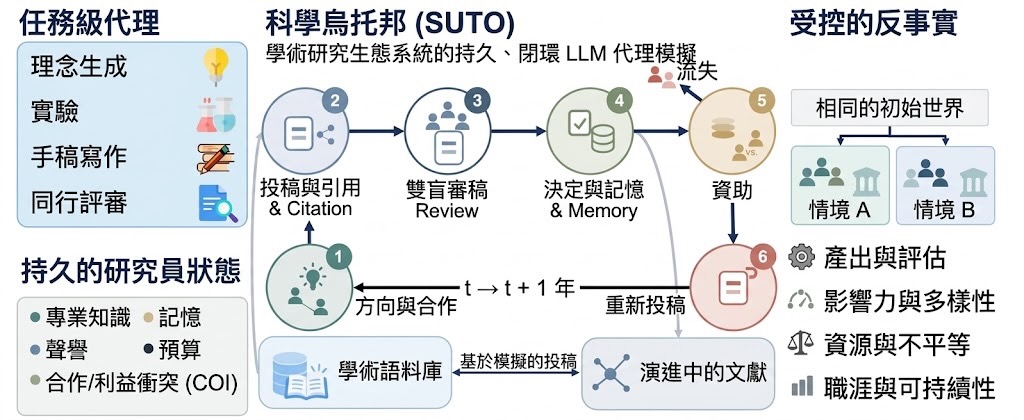
研究者會選擇方向、提交論文、互相審稿、獲得引用及爭取資助,結果再帶入下一年。ScienceUtopia 屬於開源科研模擬器,處理的是個人決策如何累積成研究社群、機構資源與科學產出的變化。

語言模型負責在明確規則下作結構化決策,研究者再從公開 SciEvo 數據集檢索候選論文;模擬器則串起研究週期、利益衝突、審稿、引用、資助和人才流失。相比只觀察單次回答的模型測試,這個項目可研究政策改動在多年循環後帶來的結果。

項目提供九類可配置實驗,可調整模型、隨機種子、端點及輸出位置。每次運行會保存年度 JSON checkpoint、請求紀錄、資助證據、來源雜湊和輸入身份,並配合 bootstrap 區間、隨機化測試、因子分解及資助門檻估計,方便重現和審查。

  • 適合研究科研政策、同行評審和資助制度的團隊
  • Python 3.11、PyTorch、Transformers 及 vLLM 構成主要執行環境
  • 網站本身是靜態頁面,直接開啟 index.html 即可查看,毋須後端或前端建置
  • 發佈版本不包含歷史活動成果、原始結果及繪圖程式

研究人員可先閱讀實驗定義和回歸測試,再按所需模型與 SciEvo 版本重跑項目;完整結果要視乎模型、快取、種子及端點而定。它更適合需要可稽核模擬證據的研究,而不是追求即時答案的日常工具。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, 工具, Python, Dataset 數據集

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

Page 11 of 35
1 … 9 10 11 12 13 … 35