FoMo 不用人手標註,讓影像更貼近感知

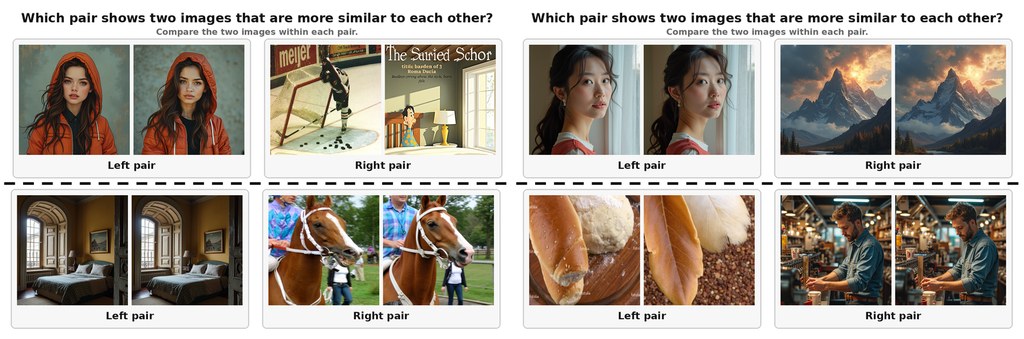
FoMo 借助 diffusion model 生成由淺入深的影像變體,免除大量人工標註,訓練出可比較兩張圖片感知差異的模型。

FoMo: data generation from the forking moment of the diffusion trajectory, and ranked-BCE training

比較原圖與修改版本時,像素差異未必等於人眼感受到的差異。FoMo 以 reference-based perceptual distance metrics(參考式感知距離模型)處理這個問題,透過 FLUX.1-dev 的 img2img 軌跡製造有次序的影像變體,並以此訓練影像品質評估(image quality assessment,IQA)模型,屬於開源模型項目。

它的關鍵做法,是在 diffusion model 的去噪流程中,於不同 denoising steps 重新接回生成軌跡。重新接入得越早,生成圖與原圖的感知偏離通常越大;這個 forking moment 便提供了密集而有排序的監督訊號。項目用 480k 組影像資料配合 pairwise ranking objective,減少依賴人手逐張標註的成本。

項目提供七個模式,涵蓋 LPIPS、DISTS、DreamSim,以及以 frozen DINOv3、CLIP、MAE backbone 配合 prediction head 的版本。DreamSim 透過 LoRA adapters 微調,而 dinov3、clip、mae 會把兩張圖片按次序讀入同一組 token;預設會計算兩個方向的平均分,處理輸出可能不對稱的問題。

  • lower score 代表兩張圖片更相似,raw 輸出也是公開評估採用的數值
  • output=’loss’ 可提供以 identity pair 為錨點的 perceptual loss
  • CNN 類模型使用固定 256px crop,DreamSim 使用固定 224px crop
  • DINOv3、CLIP、MAE 支援 64 至 256px 隨機裁剪,並以 zero-padding 和 attention masking 組批
  • 項目可透過 Python 套件 fomo-iqa 載入預訓練模型,直接比較參考圖與測試圖

FoMo 適合需要自動判斷生成圖片、編輯版本或重建結果相似程度的研究者與影像工具團隊。它的限制也很清楚:訓練訊號來自 FLUX.1-dev 的生成軌跡,不能直接等同人類偏好;不同 backbone 的輸出形式、裁剪策略與對稱處理亦會影響比較結果,因此應按工作流程選擇模型並自行驗證。
項目主頁 · GitHub

Categories: 開源, 模型訓練, Image, 影像處理, 工具, LoRA

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

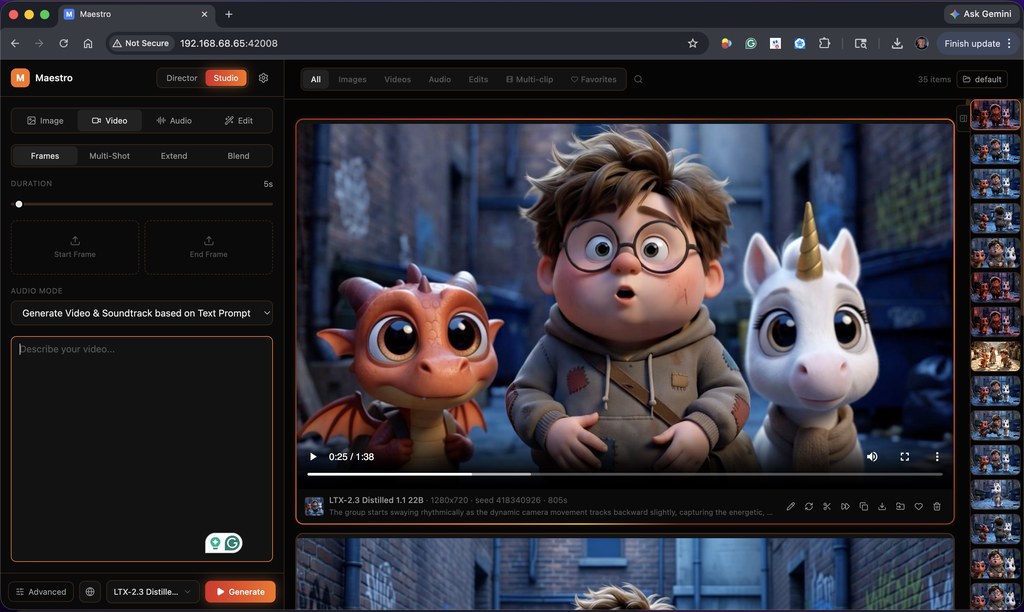
Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

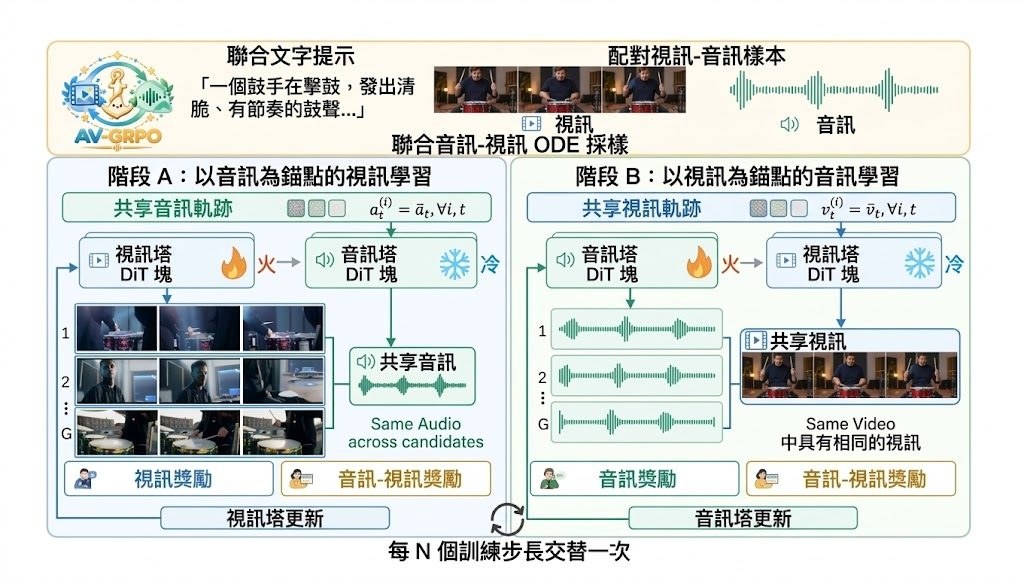
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

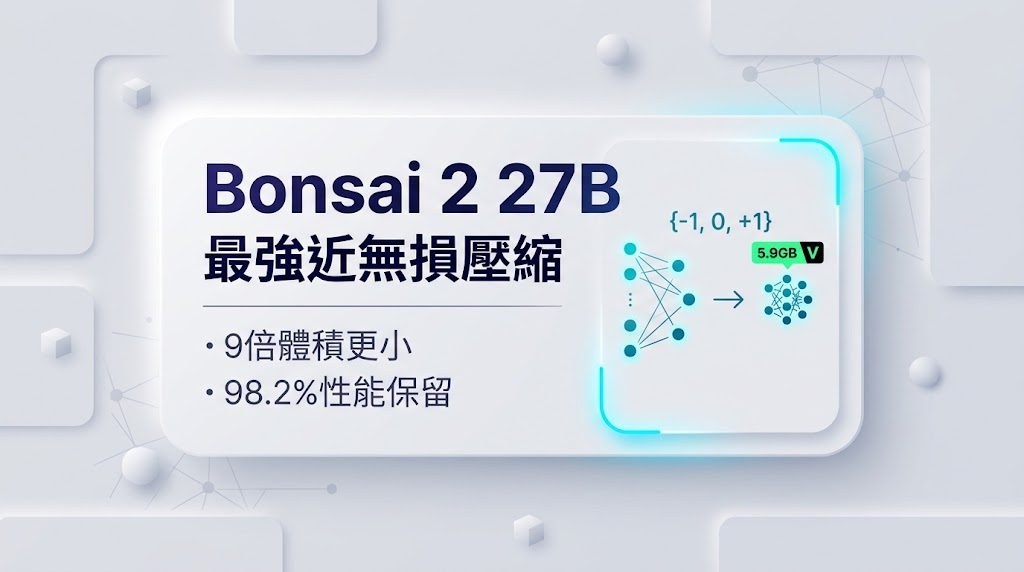
Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

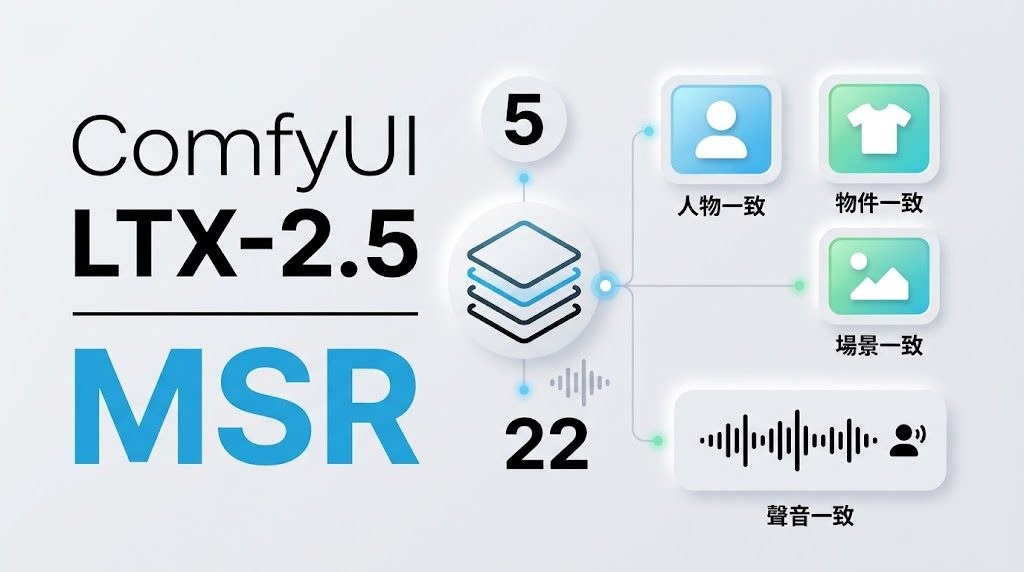
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

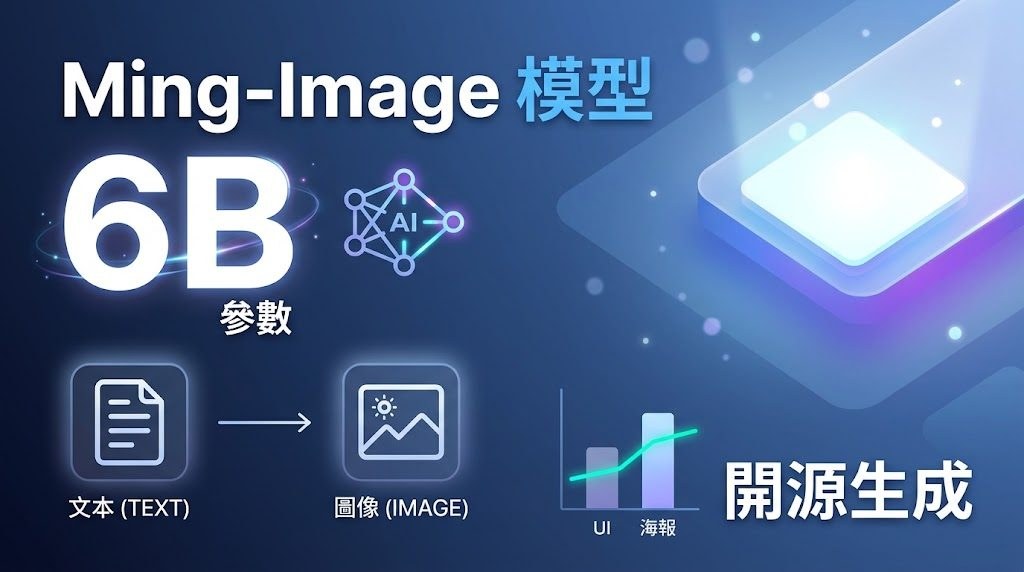
由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

Taste-Bench :避免把時間和計算資源花在錯路上

AI Agent 要做的選擇,當下往往看似合理,代價卻可能在很久之後才浮現。Taste-Bench 把這類決策分岔整理成測試,檢查模型能否及早選對方向。

Taste-Bench

AI Agent 做長任務時,選錯方向可能要到多個步驟之後才看得出代價。Taste-Bench 是一套評測資料集,讓模型閱讀任務背景、分岔前的操作紀錄,以及兩個候選下一步,再判斷哪個選擇較好;它測試的不是單步答題,而是能否避免把時間和計算資源花在錯路上。

資料集有 502 題,從軟件工程與機器學習研究任務的操作軌跡中整理而成,沒有逐題由專家標註。題目分為兩類:不同嘗試在同一位置分岔,最後結果提供判斷依據;或同一次執行中,Agent 遇到失敗後放棄原路並恢復。研究團隊從 4,657 個候選分岔中剔除過於簡單或無法判定的題目,並以後續結果標示較佳方向。

測試時可從 Hugging Face 取得資料集,按題目提供的紀錄比較模型選擇;程式碼庫亦提供 Python 3.11 以上的快速開始方式。評分要求模型在兩種選項排列順序下都答對,減低單靠固定選位置取得高分的可能。較貼近方向判斷能力,但題目仍集中於 SWE-bench、SWE-bench Pro,以及 METR 的 MALT 研究軌跡,未必涵蓋所有長任務場景。

14 個前沿模型中,最高平均正確率為 59.7%,仍有約四成題目判斷錯誤;當關鍵證據要到更後段才出現,準確率會由 62.3% 降至 21.0%,增加推理預算亦未能改善結果。研究亦報告,透過事後答案蒸餾訓練的 Qwen3.6-27B,在未見任務上的正確率由 30.0% 升至 47.9%;用它提供建議後,SWE-bench Pro 成功率由 14.6% 升至 33.7%。這些結果顯示評測不只用來比較模型,也提供了改善 Agent 決策的訓練方向。

  • 評測核心:在結果尚未揭曉時,從兩個下一步中選出較佳方向。
  • 題目來源:軟件工程與機器學習研究任務的真實操作軌跡。
  • 主要限制:目前 502 題的領域與任務來源有限,不能代表所有 Agent 工作。
  • 適合對象:研究長任務 Agent、比較模型決策能力,或訓練工具使用策略的團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, 工具, Python, Dataset 數據集

Calliope:由故事到成片 : ComfyUI 本地工作流

Calliope 將故事拆成劇本、鏡頭片段,再交由本機 ComfyUI 生成影片,兼顧創作流程與資料私隱。

Repository image for benjiyaya/Calliope

由一個故事構想開始,Calliope 會整理情節節拍、角色與場景,再按場景寫出貼近劇本的內容,拆成多個鏡頭片段交給 ComfyUI 生成影片。它屬於本地優先的 story-to-video 工具,處理的是文字創作與影片生成之間需要反覆整理、分鏡和合成的工作。

LLM 負責故事結構及逐場景腳本,ComfyUI 則按既有 workflow 和模型逐個產生片段,兩者分工清楚;完成後再由 ffmpeg 加入 crossfade、匹配音量並串成完整影片。項目資料放在 SQLite,媒體保存在本機資料夾,只有你指定的 LLM endpoint 可以是雲端服務,因此私隱程度和可控性較依賴本身的模型及 ComfyUI 配置。

Make AI Micro Dramas From Script to Video Locally Using Calliope 1.5

使用前需要 Python 3.11+、Node.js 18+、已安裝模型的 ComfyUI、OpenAI-compatible LLM endpoint,以及可從 PATH 呼叫的 ffmpeg。前端是 SvelteKit,後端採用 FastAPI;啟動兩者後,在 Settings 設定 LLM、ComfyUI URL 及可選的 agent 分工,亦可調整並行工作數、輪詢間隔和等待上限,長時間影片工作可把預設 30 分鐘 timeout 延長,或設為無限等待。

適合需要保留素材在本機的個人創作者、小型製作團隊,以及已經建立 ComfyUI workflow、想加入故事編排層的使用者。Dry-run 只會產生佔位結果,不能用來判斷真正的影片效果。

  • 流程完整:由故事、劇本、分鏡到片段合成集中處理
  • 本機優先:項目資料與媒體不必上載到雲端
  • 依賴明確:需要自行管理 ComfyUI、模型、LLM endpoint 和 ffmpeg
  • 可調整佇列:支援並行數、輪詢設定及長任務 timeout

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, API, Video, 工具, Content Creator, Python

YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。

模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize

YuE2-ComfyUI:本地生成完整歌曲,能改樂譜再翻唱

輸入風格與歌詞,便能在 ComfyUI 生成歌曲及可讀樂譜,讓創作流程多一個可修改的環節。

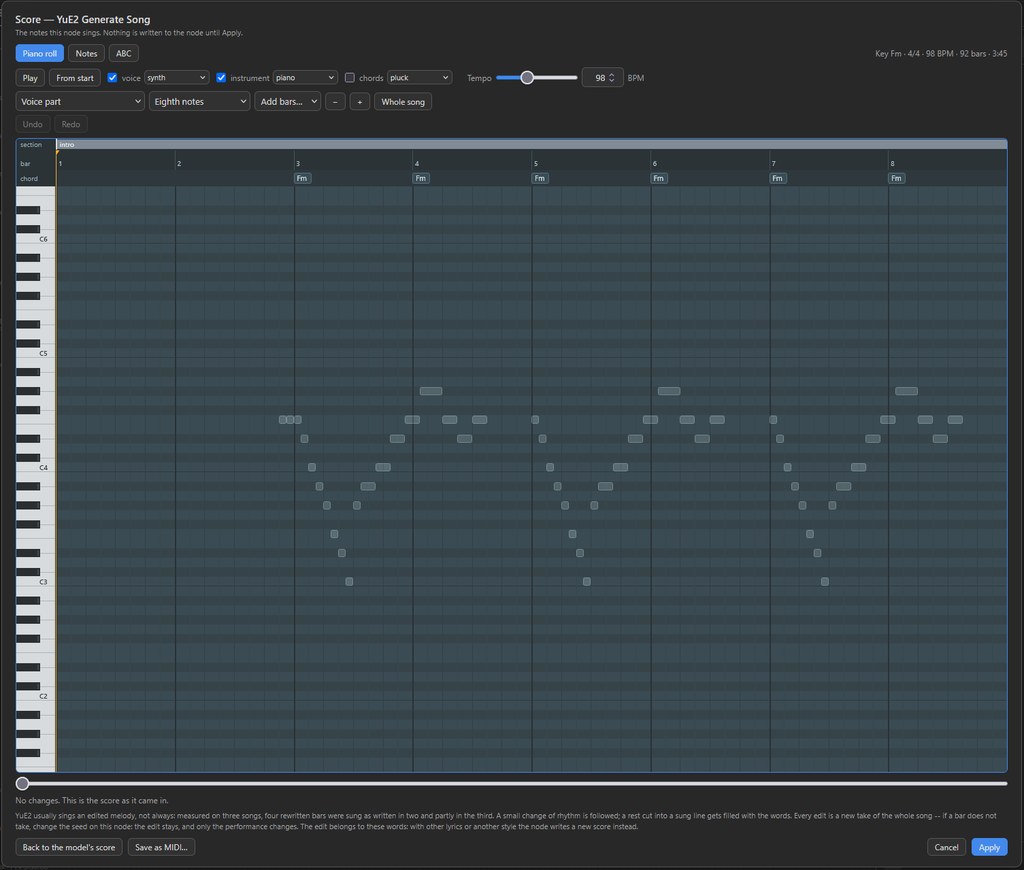
The score editor over the canvas, titled Score -- YuE2 Generate Song, with the line The notes this node sings. Nothing i

把歌詞接入節點、設定曲風後,YuE2-ComfyUI 便能在本機生成完整歌曲與可讀樂譜。這套音樂生成節點工具把 YuE2-3B 接入 ComfyUI,適合想在同一工作流程反覆試作的音樂創作者。

它先寫出 ABC 樂譜,再生成演奏內容,最後透過變分自編碼器(Variational Autoencoder,VAE)解碼成 48 kHz 立體聲。樂譜也可修改後送回節點演唱,讓旋律調整有更具體的入口。

  • YuE2 Generate Song 接收風格、歌詞及 seed。
  • 歌詞可從文字節點接入,以 [Verse]、[Chorus] 標示段落。
  • YuE2 Write Song 可從一句構想撰寫風格與歌詞。
  • YuE2 Options 提供選填設定,主節點會自動尋找本機權重。

項目示例在 RTX 5090 上花 40.2 秒生成 75 秒歌曲,但單一示例不足以推算其他硬件的速度。提供的內容未列出完整安裝步驟、最低顯示記憶體需求或音質比較;準備納入製作流程前,仍需確認本機能否載入模型。

GitHub

Categories: 開源, ComfyUI, AI productions, 工具, Content Creator, 音樂, 廣東話

Page 13 of 35
1 … 11 12 13 14 15 … 35