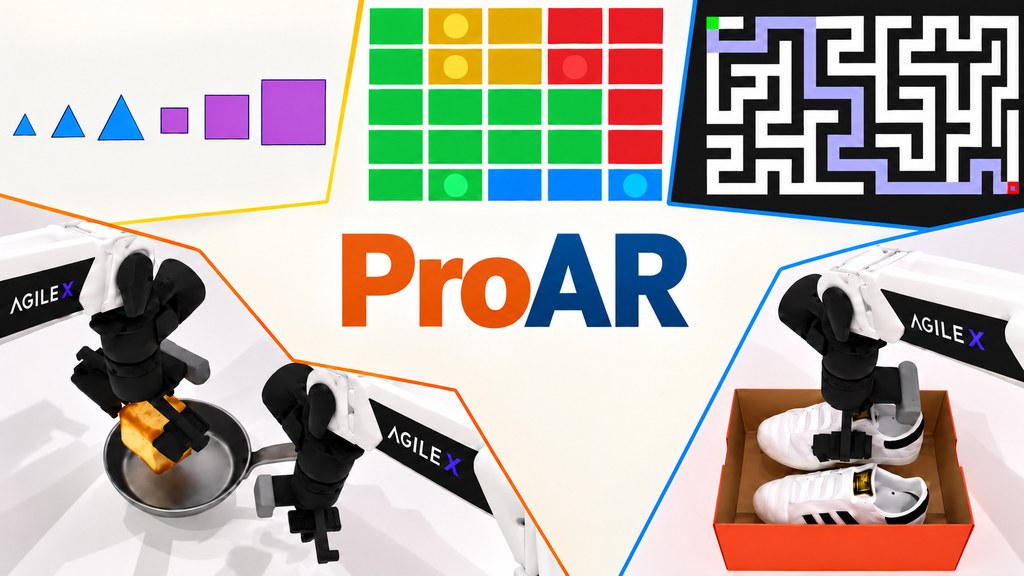
當影片模型只按過去畫面逐步預測,畫面即使局部合理,也未必能完成指定任務。ProAR 屬於自回歸影片模型項目,透過 prospective reasoning 預測未來視覺狀態,處理長程目標與中間轉換容易失控的問題。
ProAR 以 Wan2.2-TI2V-5B 作為共享 backbone,加入兩條互補機制:outcome guidance 會一同預測未來 goal frame,讓目前 chunk 參考目標信念;transition guidance 則在訓練期間利用 predictor,令目前 hidden states 對齊乾淨的 next-chunk representation。前者偏向長距離規劃,後者補足短距離的狀態銜接。
• Outcome guidance 幫助生成結果符合任務目標
• Transition guidance 鼓勵中間步驟遵守時間及物理邏輯
• 推理時不需要真實未來畫面,訓練用 predictor 會移除
• 項目提供模型 checkpoint、ProAR-test 數據集及 VBVR-10Tasks 實驗配置
要測試項目,需要 Python 3.10、PyTorch 2.8.0,並把 Wan2.2-TI2V-5B 權重、VAE、T5 編碼器及 tokenizer 放到指定本地路徑;flash-attn 屬於可選的加速元件。這套流程較適合研究視覺推理、物理推演及 embodied intelligence 的團隊,未必是即裝即用的影片創作工具。
提供的資料確認了 AR 與 ProAR checkpoint,以及 VBVR-10Tasks 和測試數據集,但未列出足夠的數值結果,難以單憑儲存庫內容判斷提升幅度。推理時間會增加,換來模型在生成前預測目標及未來轉換;取捨是否合理,要視乎任務是否重視步驟有效性多於生成速度。