RATs 用多代理玩出機械人技能庫

RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

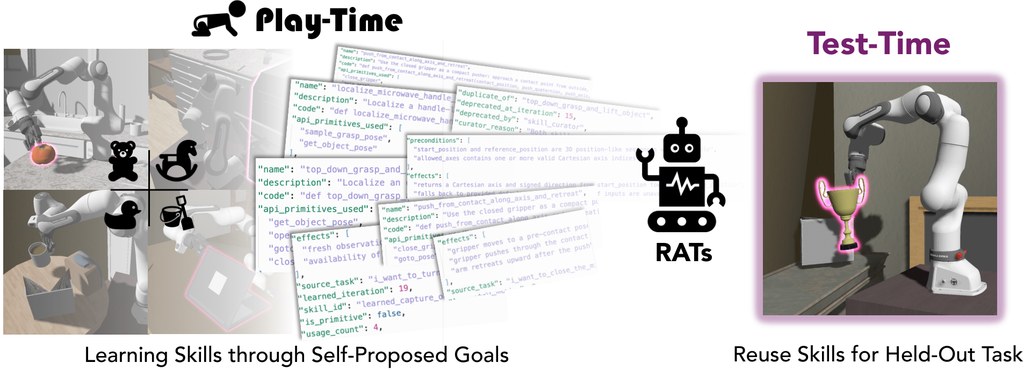
現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda
GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, , Skill 技能

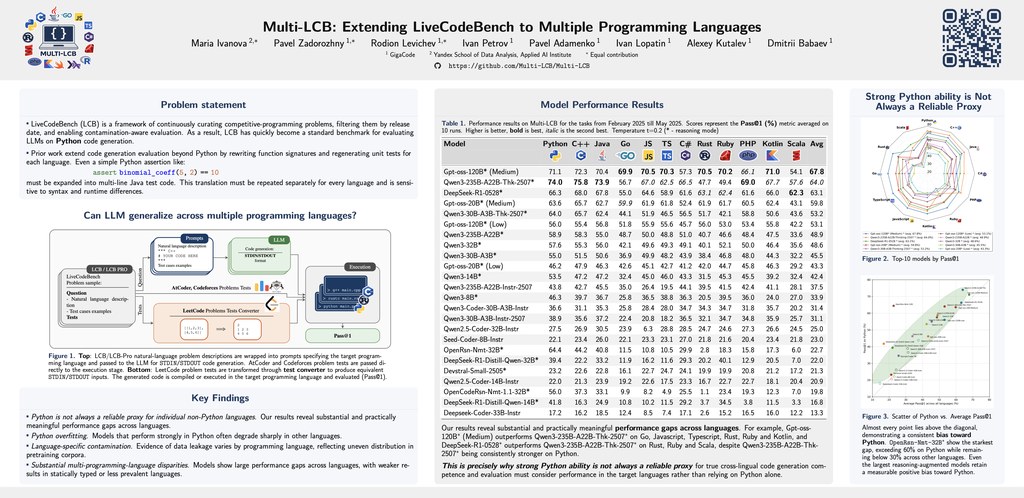
MultiLCB:即時追蹤程式模型表現

一個聚焦多語言編程能力的公開評測平台,可比較不同模型在時間變化下的表現。

codeLogo

MultiLCB(Multi Live Code Bench)是一個公開的編程模型評測項目,重點是用動態榜單和比較工具,觀察不同模型在多種程式語言上的表現。網站提供 Main Leaderboard、Model Comparison,以及按月份查看 pass@1 變化,適合想快速了解模型編碼能力的人。

這個項目處理的問題很明確:不少編程模型成績只停留在單次發布,難以看出時間變化、語言差異和推理設定的影響。MultiLCB 把資料整理成可篩選的介面,支援語言、難度、平台,以及是否使用 CoT(Chain-of-Thought)等條件,方便直接比較。

使用時,讀者可先在 Leaderboard 選擇日期範圍,再按 Python、JavaScript、TypeScript、Java、C++、C#、Go、Rust、Ruby、PHP、Kotlin、Scala 等語言篩選。若想深入看兩個或多個模型差距,可打開 Compare 頁面,用 pass@1 與平均分數交叉檢視,也可留意每月走勢圖。

  • 支援 LCB、LCB-PRO、LCB-PRO-AGENTIC 多種基準
  • 可按語言、難度、平台、CoT 條件篩選
  • 以 pass@1 為核心指標,方便直觀比較
  • 提供月份變化圖,較易看出模型進步或波動

這類項目特別適合模型研究者、AI 工程師、技術媒體,以及需要挑選 coding model 的團隊。從頁面可見,它偏向基準測試與橫向比較工具;至於數據來源、題目構成和完整評測方法,仍要配合站內 Code、Hf、Submit 或相關說明頁面再作確認。

項目: https://multi-lcb.github.io/

Categories: 開源, Agentic, 模型, Vibe Coding, 工具, Python NLP, Python, 編程

WAPO:穩定 RLVR 訓練時的損失函數項目

針對 GRPO 類方法的崩潰問題,加入 WAPO 等研究用損失函數。適合做語言模型強化學習與穩定性比較。

logobox

這是一個強化學習訓練工具項目,核心是為 Reinforcement learning with verifiable rewards(RLVR)加入多種損失函數,用來改善語言模型訓練時容易出現的崩潰問題。作者指出,傳統 GRPO 類方法雖然常見,但在 off-policy 更新下仍可能因梯度動態而失穩,所以這個 fork 直接把研究中的新損失實作進 vf.RLTrainer,方便對照測試。

項目內保留了 grpogspodr_dapo 等基線,並新增 wapo。其中 wapo 只針對正向回報的 rollout 更新,配合單向截斷與分組歸一化,思路比一般對稱 clip 更保守,目標是減少把模型推向錯誤方向的更新。

這個項目的新意不在於重新訓練一個模型,而是重新整理「哪些樣本值得被強化」這件事。論文提出的 gradient perspective 也把 token 層面的穩定性拆開分析,對想研究訓練動態的人很有參考價值。

適合以下人使用:
– 做 language model RLVR 研究的人
– 想比較 GRPO、GSPO、DR-DAPO、WAPO 差異的人
– 需要在數學推理或 multi-hop QA 做穩定性實驗的人
– 想沿用 vf.RLTrainer 再加自訂 loss 的開發者

性能方面,附帶的 arXiv 內容表示,WAPO 在數學推理與 multi-hop QA benchmark 上可提升訓練穩定性,並在多個模型家族上達到或超過基線。相關模型或方法包括 RLVR、GRPO、GSPO、DR-DAPO 與 WAPO。

GitHub: https://github.com/layer6ai-labs/wapo

Paper: https://arxiv.org/pdf/2606.16154

Categories: 開源, 模型, 模型訓練, Qwen, 工具, LangChain, LangGraph, Python, 深度學習

UniAR 用一個 Transformer 包辦看圖、作圖、改圖

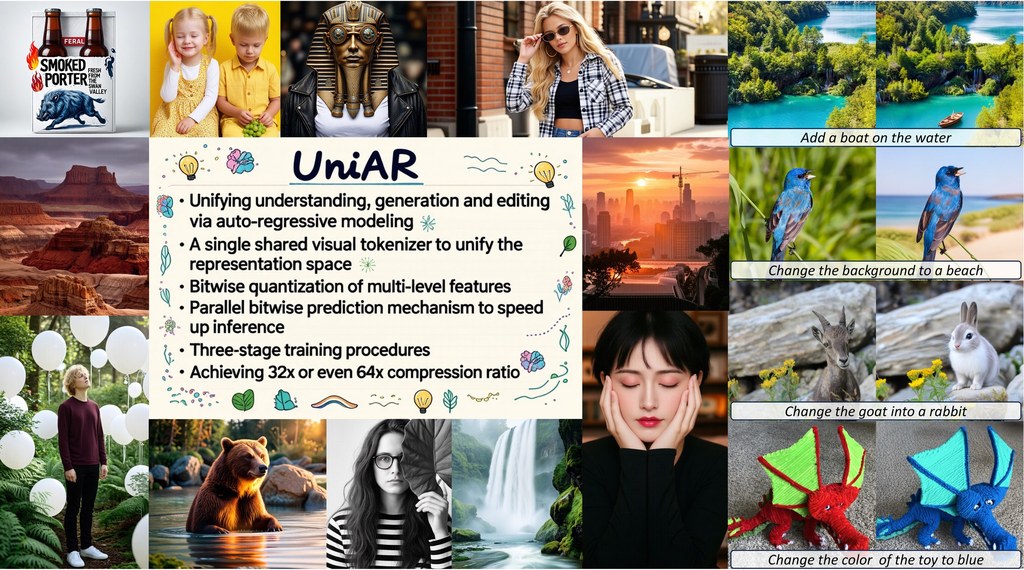
UniAR 針對多模態模型常見的雙 tokenizer 分裂問題,改用單一視覺 tokenizer。這個方向同時瞄準理解、生成與編輯三種影像任務。

teaser

現有 Unified Multimodal Models(UMMs)多數會把影像理解和影像生成分開處理,常見做法是用兩套 visual tokenizers。作者認為這種 fixed paradigm 會把表示空間拆開,模型生成完圖片後,還要再重新編碼才能理解自己剛產生的內容,shared context 也就難以真正成立;UniAR 因此提出一個 unified autoregressive framework,用單一 discrete visual tokenizer 連接理解、生成與編輯。

項目屬於多模態模型,目標是用同一個 Transformer 解決 image understanding、image generation 和 image editing 之間來回切換的成本。它的核心判斷很直接:若模型看圖與作圖共用同一套視覺 token,流程就不需要額外 re-encoding,系統結構會更一致。

技術上,UniAR 有幾個辨識度很高的設計。Multi-level BSQ tokenizer 把高層語意與低層細節一併保留,並透過 Binary Spherical Quantization 擴大有效 vocabulary;parallel bitwise prediction 則把視覺碼以分組方式一齊預測,令 autoregressive 長序列壓短,論文提到 1024×1024 影像只需 256 個 AR tokens,對應 32x visual compression ratio。

  • 單一 discrete visual tokenizer 取代雙 tokenizer 架構
  • 支援 image understanding、image generation、image editing 同模運作
  • Multi-level BSQ tokenizer 同時顧及語意與細節
  • parallel bitwise prediction 壓縮視覺序列,加快 autoregressive 生成
  • DiT-based visual decoder 以 discrete visual tokens 重建高保真影像
  • 需求:Python 3.12、CUDA 12.1+、推理的 GPU 記憶體 >= 24 GB

如果你想試這個項目,較合理的切入點不是直接拿來當日常工具,而是先看它公開的模型權重與項目頁,分開測理解、生成、編輯三類輸出是否一致。它較適合研究多模態統一架構的人、關注 Qwen 生態的開發者,以及想比較 autoregressive 與 diffusion 混合路線的讀者。

性能方面,原文聲稱 UniAR 經 large-scale pre-training、supervised fine-tuning 和 reinforcement learning 後,在 image generation 與 image editing 達到 state-of-the-art,同時在多模態理解 benchmark 保持競爭力。不過目前公開資訊較像研究成果展示,visual decoder training code 仍未完整放出,因此更適合拿來理解方法論,而不是立即評估成成熟生產工具。

相關模型與組件包括 SD3-medium visual decoder、Qwen Team 背景下的多模態模型路線,以及論文聚焦的 Unified Multimodal Models(UMMs)。若你在意的不是單次生成效果,而是模型能否「理解自己生成的內容」,UniAR 的 shared context 設計確實提出了一個有意思而且相當具體的答案。

GitHub: https://github.com/ShareLab-SII/UniAR

項目: https://sharelab-sii.github.io/uniar-web/

Categories: 開源, 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 框架, Vibe Coding, 工具

SeeQ 讓 VLM 學識自己出視覺問題

這個項目聚焦 Visual Question Generation,想解決高質視覺提問數據昂貴又難擴充的問題。它用自我演化流程,令 VLM 由答題者變成會主動發問的系統。

Cover Figure overview

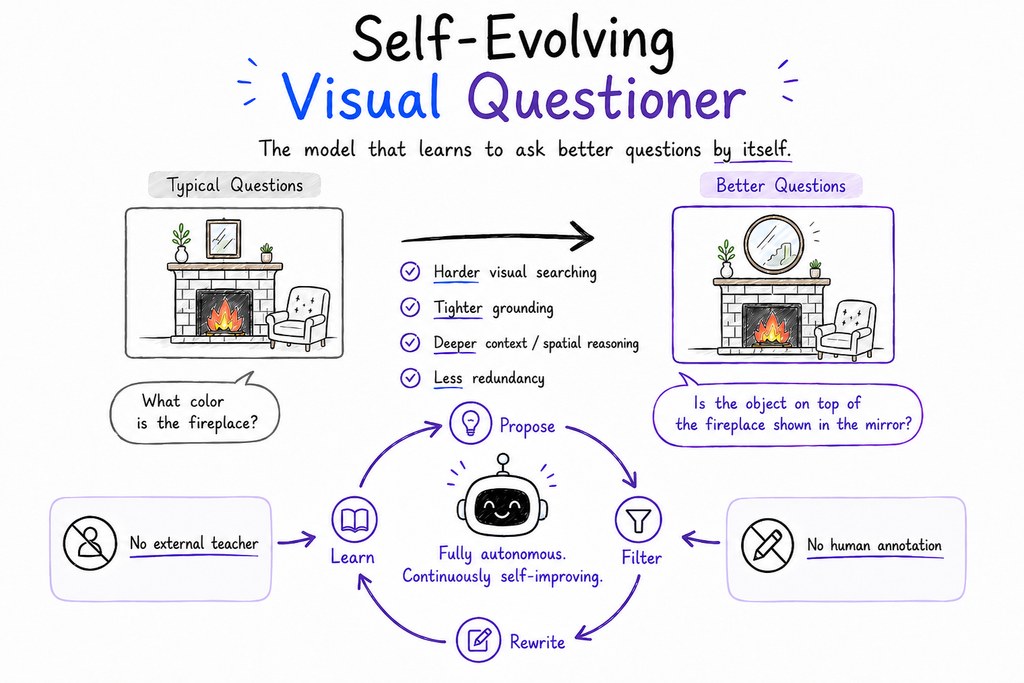
現有 Vision-Language Models(VLMs)多數按「被動答題」範式訓練:人類或外部模型先提供問題,模型再學習回答。論文認為這種 fixed inputs 做法受制於靜態資料分佈,Visual Question Generation(VQG)亦容易卡在標註成本高、題目深度不足這兩個瓶頸,所以 SeeQ 提出 Self-Evolving Visual Questioner,用同一個 VLM 同時做 proposer 與 filter,自動從未標註圖片生產更難、更貼近畫面內容的問題。

這個項目屬於框架兼研究型工具,重點不是再做一個普通題庫,而是建立完整流水線:先生成 seed questions,再反覆改寫,提升 visual search、context 與 spatial reasoning 要求,之後再由模型自行過濾。作者同時加入 exploration diversity 控制,目標是避免訓練一路收窄,最後只剩單一風格題目。

如果你想試,較合理的做法是先準備圖片對應的 JSON 輸入,再分開看 generation 與 evaluation 兩部分輸出。倉庫內沒有附模型權重、數據集與快取,評測亦會用到 image-capable OpenAI evaluator 與 Qwen embedding models,所以較適合已經有 VLM 環境、想驗證自動出題流程的研究者或多模態團隊。

  • 以未標註圖片開始,自動生成、改寫、過濾視覺問題
  • 保留 Agentic evaluation,從 visual search、evidence coverage、context、spatial reasoning 評分
  • 另用 Qwen embedding models 檢查整體多樣性,不只看單題質素
  • 強調 zero external supervision,不依賴人工標註或 GPT-4V 這類外部 teacher models

創新點在於它不單止用 VLM 產生問題,還把「提問能力」當成可自我增強的訓練訊號,並且把 questioner 與 answerer 兩種模式一起考慮。按論文說法,這套方法在多個 backbone VLMs 上都能提升問題質素,亦把自動出題的難度邊界推高;同樣預算下,比直接用靜態來源資料訓練更有效,而模型的 answerer 能力亦未有明顯犧牲。

相關模型與元件方面,倉庫內容顯示生成流程可配合 Qwen2.5 3B 類型設定,評測會用 OpenAI 的可看圖評估器,以及 Qwen embedding models。若你關心多模態訓練、合成數據、或想建立能自己發問再自我改良的 Agentic workflow,SeeQ 的方法論比單純看分數更有參考價值。

GitHub: https://github.com/tianyi-lab/SeeQ

Paper: https://arxiv.org/pdf/2606.13929

Categories: 阿里巴巴, Agentic, AI productions, RAG, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, OpenAI, Image, 框架, 工具, IDE, Python, , Dataset 數據集

LoopCoder:只多跑一輪,成效反而更好

LoopCoder-v2 研究 PLT 在測試階段的迴圈次數選擇,顯示兩輪往往比三輪以上更穩定。對寫程式、工具呼叫和代理式任務,這個項目提供了更實際的取捨參考。

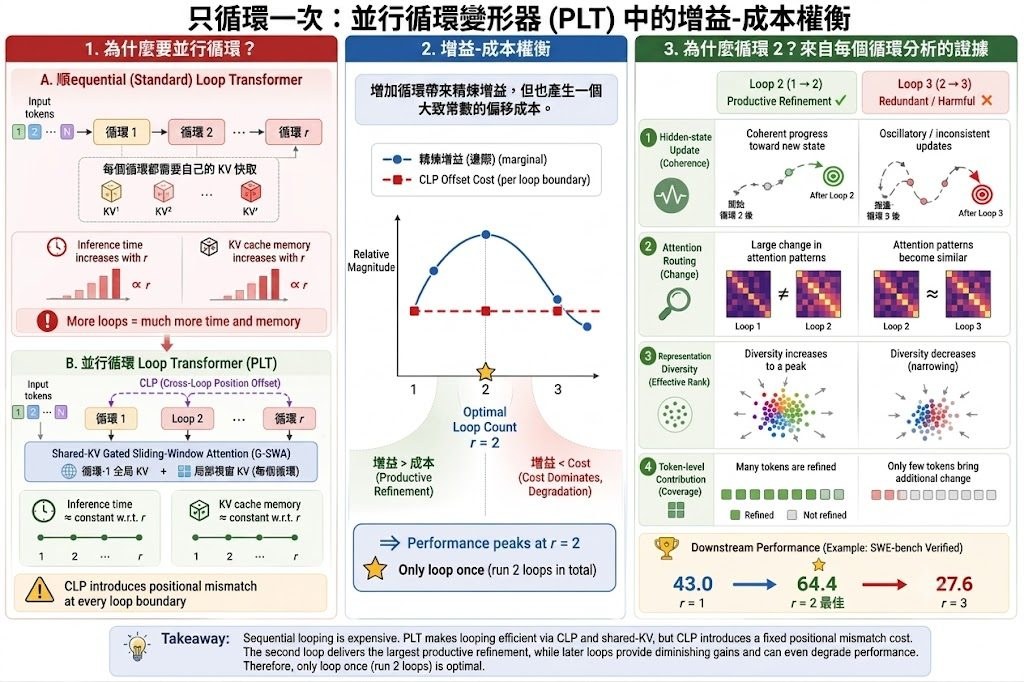
Only Loop Once: gain–cost trade-off in Parallel Loop Transformers

LoopCoder-v2 是一個基於 Parallel Loop Transformers(PLT)的程式碼模型系列,目標是解決「推理步數愈多,成本與表現未必同步上升」的問題。傳統 Looped Transformers 會透過重複共享區塊去增加 latent computation,但每多一輪都會拉高延遲和 KV-cache 記憶體;PLT 則用 Cross-Loop Position Offsets(CLP)和 Shared-KV Gated Sliding-Window Attention(G-SWA)把成本壓低,讓迴圈數變成可以調整的設計參數。

這個項目直接拆解「多跑幾輪到底值不值得」。作者用 gain–cost 角度分析 loop count:額外一輪可以帶來表示更新,但 CLP 也會引入位置不匹配的成本;兩邊一對比,就能解釋為何 LoopCoder-v2 在很多情況下是兩輪最好,而不是愈多愈好。這種分析方式比單看分數更有參考價值,因為它把效果升降和內部機制連在一起。

從結果看,LoopCoder-v2 的 7B 版本在多個程式相關測試都有明顯改善,尤其是 SWE-bench Verified 由 43.0 升到 64.4,Multi-SWE 由 14.0 升到 31.0,Terminal-Bench 亦有提升。相反,三輪或四輪時分數明顯回落,表示這個項目不是單純靠「加更多計算」換表現,而是存在一個較清晰的最佳點。作者亦用 hidden-state dynamics、attention evolution 和 output distribution shift 去佐證第二輪帶來主要增益,之後的輪次多數只會增加冗餘。

如果你想找的是可直接跑的模型,這個項目提供了 Hugging Face 上的 7B 權重,能透過 Transformers 載入後做文本生成或程式碼任務測試。適合關注 code generation、code reasoning、agentic software engineering、tool-use 的人,也適合想研究 test-time compute scaling、模型推理效率,或想比較 loop count 對表現影響的讀者。

  • 主要類型是模型研究項目,同時包含評測與推理分析
  • 核心結論是:兩輪通常是最佳平衡點,三輪以上可能反而拖低表現
  • CLP 令平行迴圈可行,G-SWA 則把 KV-cache 成本維持在近乎固定水平
  • 7B 版本在 SWE-bench Verified、Multi-SWE、Terminal-Bench、BFCL 等測試都有較完整結果
  • 適合用來分析程式碼模型、代理式任務,以及測試階段算力分配

GitHub: https://github.com/CSJianYang/LoopCoder

Paper: https://arxiv.org/pdf/2606.18023

Categories: 開源, Agentic, AI productions, RAG, 模型, 框架, 軟件, 工具, Python, 編程

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

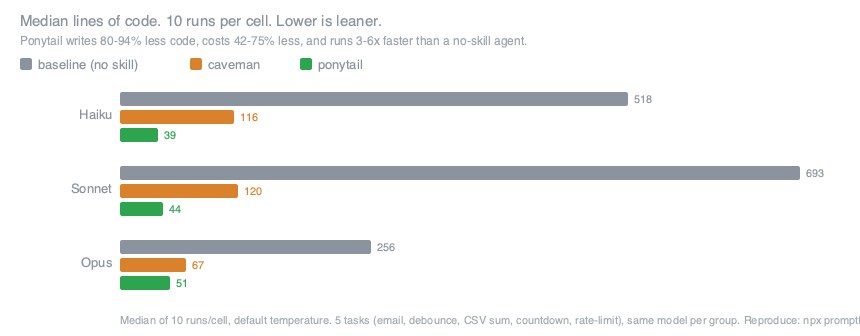
在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review/ponytail-audit/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, , OpenClaw, Anthropic, Skill 技能

PhoneHarness:重新量度手機代理能力

它不只看下一步點擊,而是看有沒有真正做成事。PhoneHarness 把 GUI、CLI 和工具動作放在同一個手機代理評測框架。

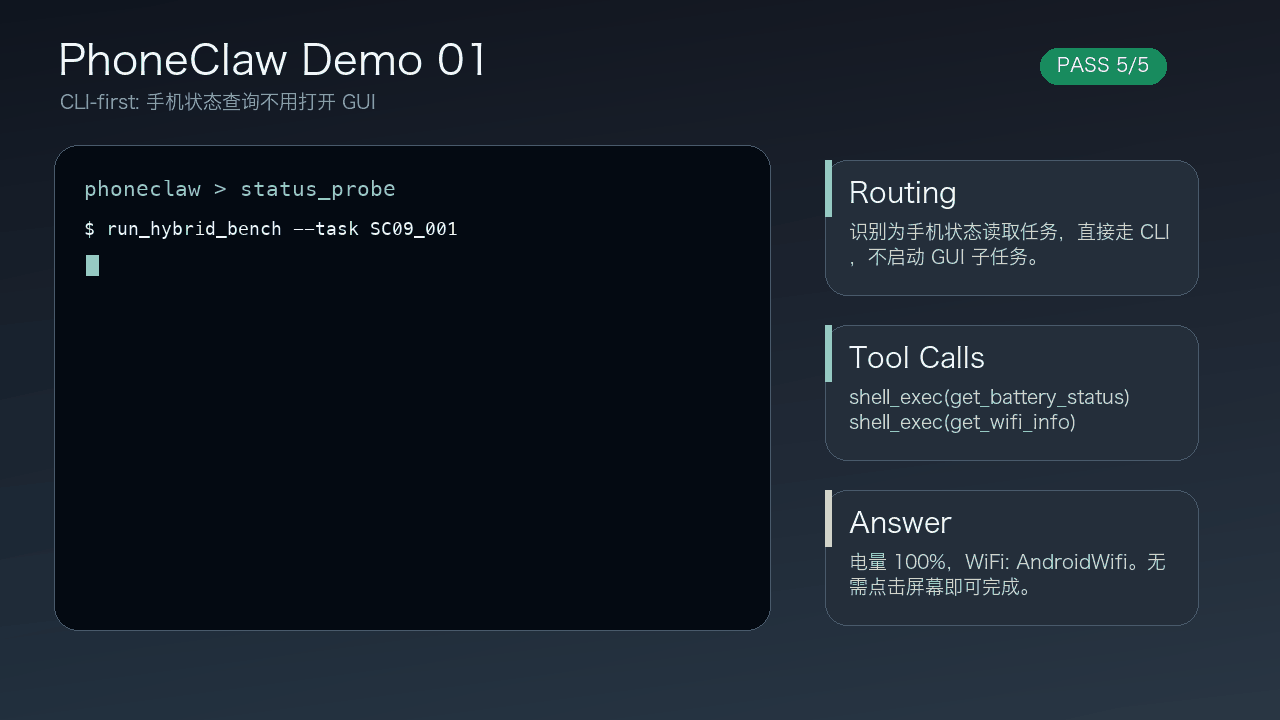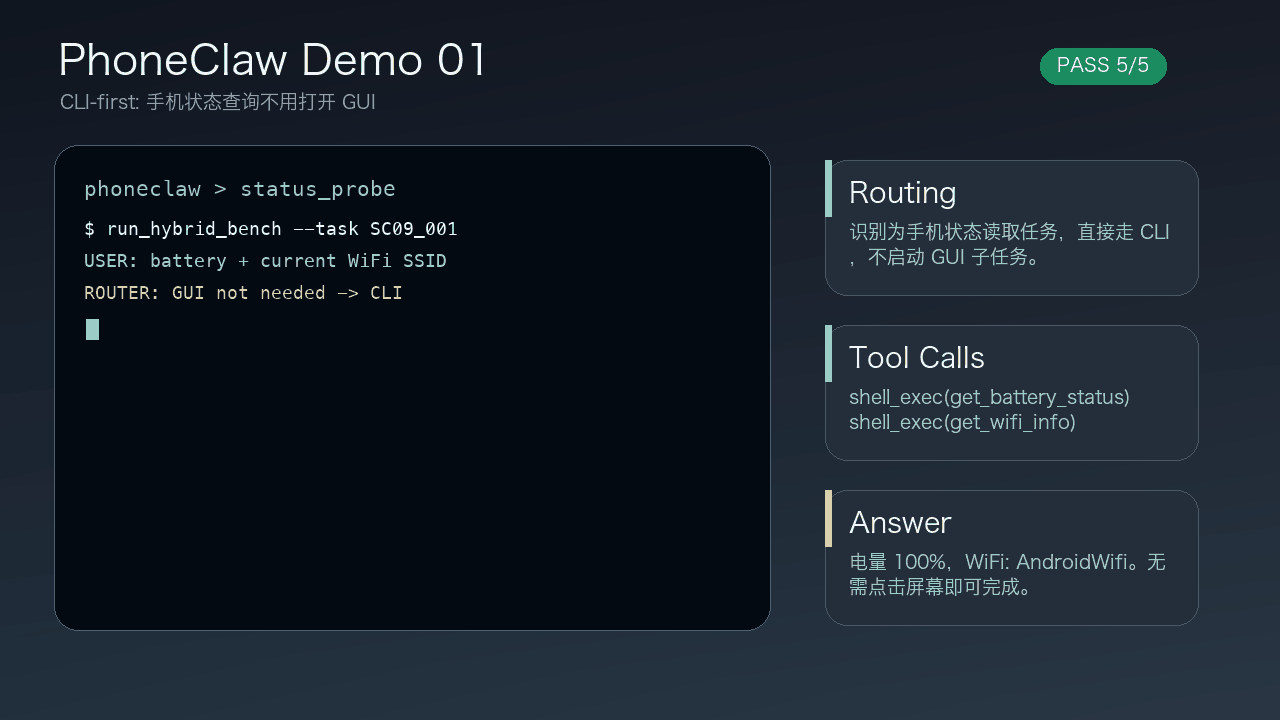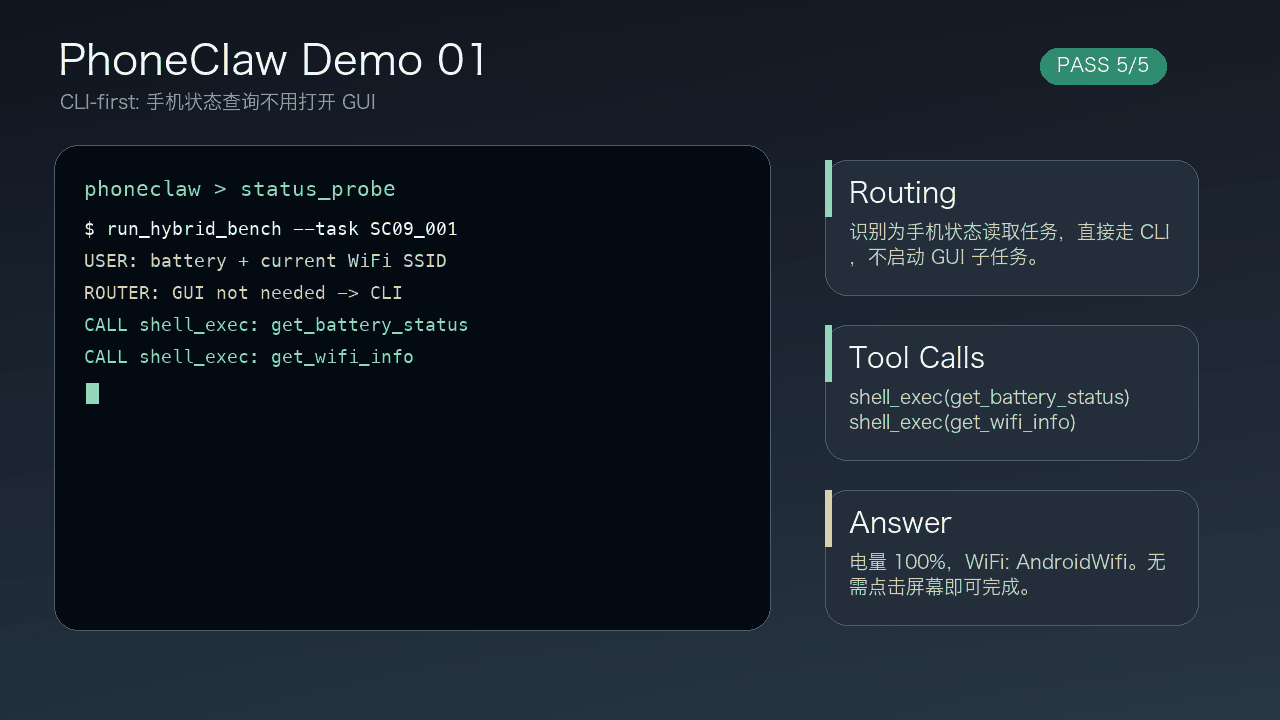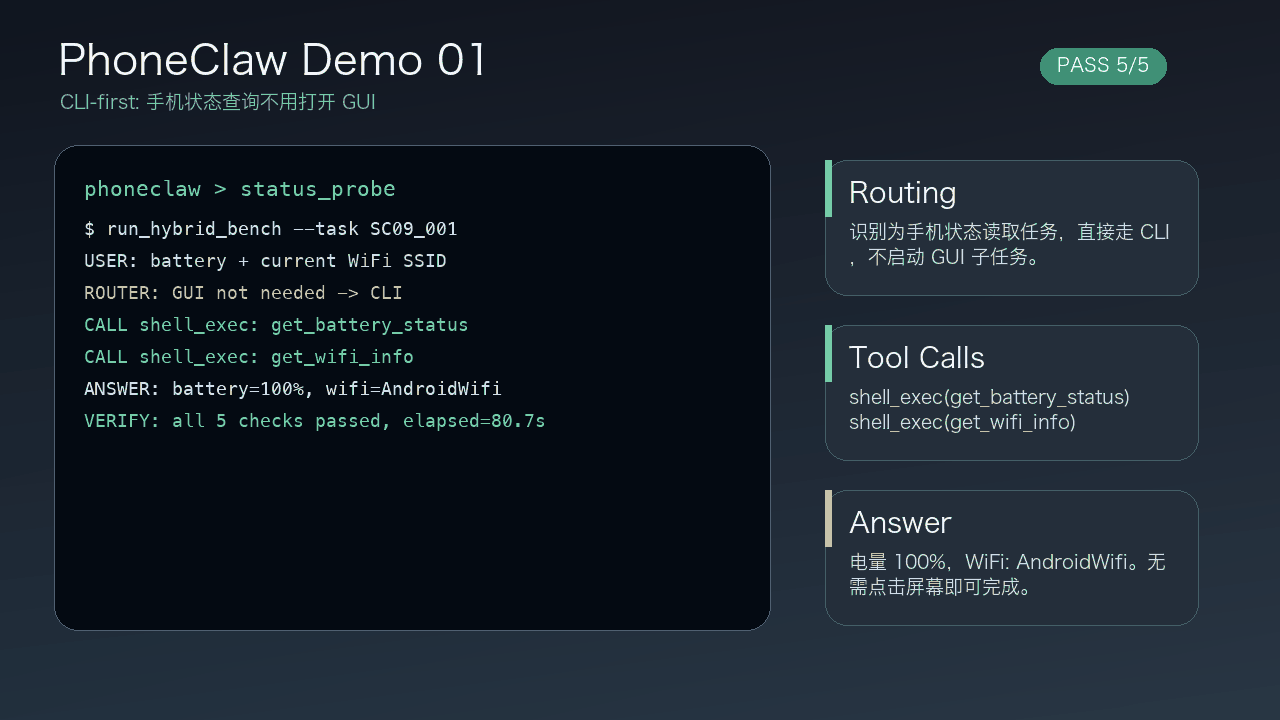
PhoneHarness CLI status demo

PhoneHarness 是一個混合動作的手機代理評測框架與基準,解決只靠 GUI 點按去評分、卻量不到真實副作用的問題。論文指出,手機任務往往需要在 GUI、CLI 與 structured tools 之間切換,單看最後畫面會漏掉很多關鍵步驟。

它的做法是把行動路由、GUI 委派和可追蹤執行記錄放進同一個流程。當任務有明確可執行路徑時,系統會優先走 CLI 或 MCP 完成;只有必要時才交由 GUI worker 透過截圖互動,令評測更貼近真正手機工作流。

這個項目的新意在於把「能否完成」和「是否留下可驗證證據」綁在一起。JSONL traces 和 HTML viewer 令失敗可以被拆成模型推理、GUI 對齊、環境、工具或 verifier 不一致幾類,方便找出問題來源,而不是只見到一個分數。

論文中的 PhoneHarness Bench 在 annotated evaluation split 上取得 75.0% pass rate,較最強的非 PhoneHarness 設定高 12.9 個百分點。這表示它不只是測試介面操作,還在測試代理怎樣選擇動作面,對做手機自動化、裝置測試、或需要可審計流程的團隊都幾有參考價值。

  • 混合支援 GUI、CLI、MCP tools,適合手機工作流評測
  • 優先 deterministic 路由,減少不必要的畫面操作
  • 可追蹤 traces,方便定位錯誤來源
  • 適合研究 phone agents、裝置自動化與安全副作用檢查

相關模型/基準可一併留意:PhoneHarness、PhoneHarness Bench、AndroidWorld、AppAgent、Mobile-Agent-v2、MobileAgentBench、AndroidLab。

GitHub: https://github.com/PhoneHarness/PhoneHarness

項目: https://phoneharness.github.io/

Categories: 開源, Agentic, MCP, 模型, 框架, 軟件, 工具, 安全

JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

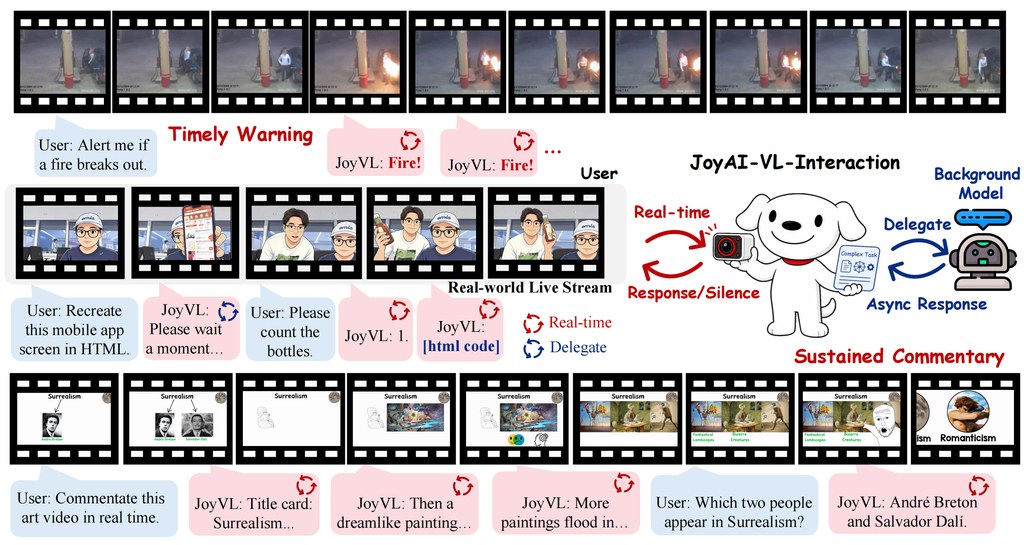
JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

MiniMax Mavis:多 Agent 協作處理長任務

MiniMax 將 Agent 升級為 Mavis,主打多 Agent 團隊協作。它瞄準長時間、步驟多、需要覆核的工作流程。

Og image

MiniMax 把原有 Agent 升級並命名為 Mavis,重點是加入 Agent Teams,讓多個 Agent 在桌面版同時運行,並以不同角色分工合作。這個方向主要處理單一 Agent 面對長任務時容易同時做執行者與裁判、資料整理與事實核對混在一起的問題。

過去把一個複雜要求直接交給單一 AI assistant,回覆速度可以很快,但當內容需要最新資料、來源整理、格式輸出與結果驗證時,流程便容易失焦。Agent Team 的做法是把任務拆成前台與後台、有驗收、有記憶的工作流;用戶仍然只需輸入一個要求,系統再判斷是否拆解、哪些角色可並行、哪些結果需要覆核。

對一般用戶而言,這項目最易理解的用法,是把它視為一個可分工的 AI 工作團隊。若你要處理長篇內容整理、跨格式輸出,或需要連續跟進的知識工作,Mavis 會比單一 Agent 更合適;如果只是一次性的小任務,官方亦暗示未必需要動用 Agent Team。

  • 支援多個 Agent 並行,適合長時間與複雜任務
  • 可建立不同角色分工,提升整理、驗證與交付流程
  • 用戶只需提供一次指令,系統會自行判斷是否拆解任務
  • 整合 TokenPlan 與 Agent Plan,CLI、API、Agent 共用訂閱與 credits

另一個更新是把 TokenPlan 與 Agent Plan 合併成單一訂閱,涵蓋 CLI、API、Agent,以及 M2.7、music、video、voice 等能力,credits 亦可共享。對已同時訂閱兩個計劃的用戶,官方表示會補送一個月會籍。這次內容未見具體跑分或量化基準,重點更偏向產品工作流與使用體驗的重整。

項目: https://www.minimax.io/blog/minimax-agent-team-long-running-1779893953

Categories: Agentic, AI productions, API, Video, 工具, 線上服務, IDE, MiniMax

Page 10 of 21
1 8 9 10 11 12 21