3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

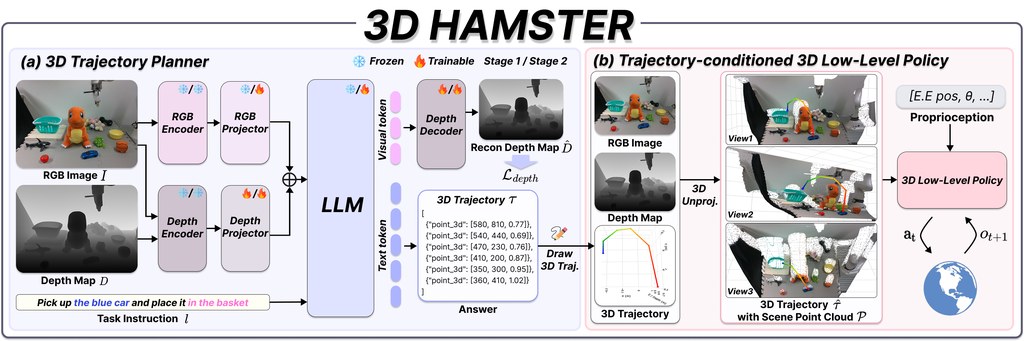
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。
項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

MuseBench 用藝術理解考驗 MLLMs

MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

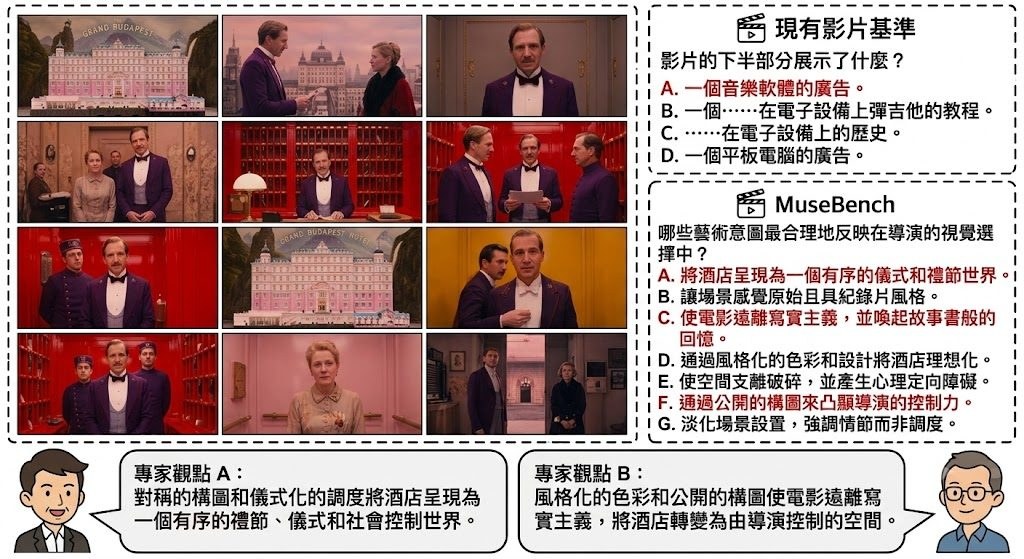
見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

PaperPilot:把文獻搜尋變成可修改流程

找相關研究唔一定只靠一條關鍵字。PaperPilot把文獻搜尋拆成可檢查、可改寫的流程,令多輪互動真係會改變搜尋策略。

PaperPilot logo

做研究時,最麻煩往往唔係「搵唔到論文」,而係第一輪結果未必貼近你真正想追嘅方向。PaperPilot屬於開源框架,同時亦帶有已訓練代理模型,用 workflow induction 處理多輪學術文獻搜尋:它會圍繞 anchor paper 同查詢,先建立一個 typed DAG,再用澄清問題同後續回應去改動搜尋流程本身,而唔係只係喺原句後面再加條件。

呢個定位同一般固定 pipeline,或者只靠語言模型隱式推理嘅搜尋代理,好唔一樣。作者認為舊範式嘅問題,在於搜尋策略難以控制、難以檢查,亦唔容易根據人嘅偏好逐步修正;PaperPilot就把 keyword search、citation expansion、filtering、scoring、reranking、evidence extraction 組成可執行流程,每一步改動都可以保留,令結果更可追溯。

公開資料已經提供 live demo,亦有 FastAPI 後端、Streamlit 介面、evaluation scripts 同 tests,可理解成一套可部署、可觀察、可重跑嘅研究工具鏈。不過 initial release 未包含 web/ React front-end,同 training_infra/ 亦未完整開放;README 片段亦未見完整安裝流程,現階段較適合先用 demo、閱讀論文,再按儲存庫結構自行部署 backend 與本地介面。

  • 多輪互動唔止改 query,仲會直接編輯 typed DAG workflow
  • 約 50 個 typed operators,覆蓋檢索、集合操作、排序同證據抽取
  • 每次執行會保存流程、逐輪修改、時間與成本,方便重現結果
  • PaperPilot-9B 以 workflow imitation 加 preference optimization 訓練而成
  • 指標上較 base Qwen3.5-9B toolset agent 提升 Hit@5、MRR、nDCG@10,並把 workflow execution errors 由 9.5% 降到 0%

相關模型方面,核心比較對象係 base Qwen3.5-9B toolset agent,而實作後端就標明支援 OpenAI、Together、Anthropic 同 OpenAI-compatible endpoint。呢種設計對研究員、需要做系統性文獻整理嘅學生,或者想把檢索流程納入團隊知識管理嘅人都幾有價值;取捨在於它追求可控與可審核,流程會比單次對話搜尋更重,亦更依賴使用者願意逐輪提供清晰反饋。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

SaMer 壓縮視覺檢索成本

想保留圖像檢索的細節判斷,又不想被海量 visual tokens 拖慢,SaMer正正處理這個矛盾。它用較聰明的合併方式壓縮 token,同時盡量守住檢索準確度。

SaMer overview

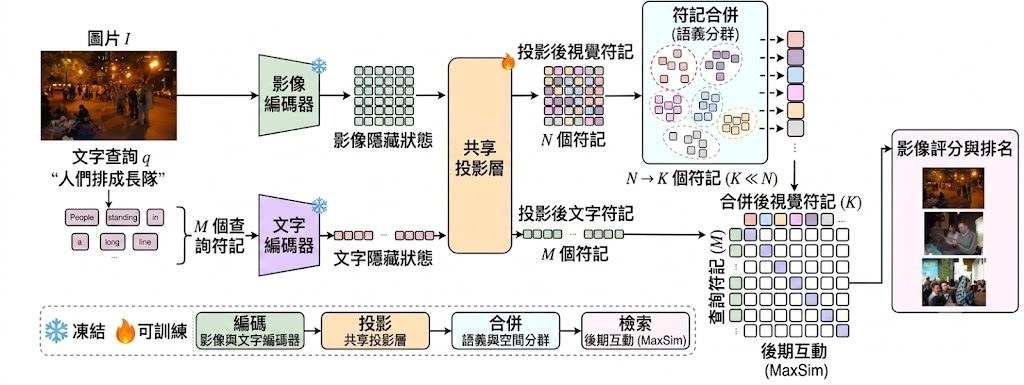
圖文檢索做得細緻,往往要保留大量 image-side tokens,但儲存與比對成本也會跟住升。SaMer屬於開源框架/研究原型,針對 ColPali-style multi-vector retrievers 的 token 壓縮問題而來,重點不是單純刪減,而是盡量保住之後查詢仍可能用得着的 object-level evidence。

現有壓縮做法多數偏向 pruning、pooling,或者只按 feature 合併,代價是物件與區域證據容易被混在一起,令 MaxSim late interaction 原本可選取的細節訊號流失。SaMer的取向明確:保留原本 MaxSim retrieval objective,不改 late-interaction 介面,只在 image side 做 object-aware merge,修正「壓縮後證據變鈍」這個問題。

它的方法有三個關鍵步驟:先用 feature similarity 加 spatial proximity 做 Feature-Spatial Merging,再在訓練階段利用 Flickr30k-Entities 的框標註加入 Object-Aware Assignment,避免不同實例被錯誤合併,最後採用 Projection-Only Adaptation,只訓練 shared projection layer,vision encoder 同 language backbone 都維持 frozen。到 inference 時就不再依賴 bbox,這點令部署比一些需要 detector 或額外 grounding loss 的做法簡潔。

  • 以 ColPali-style multi-vector retrieval 為核心場景,重點是減 storage 與 scoring 成本
  • K=64 時可移除超過 93% image-side tokens,ColPali 儲存量下降 16.09×
  • 在 Flickr30K 與 MSCOCO,README 與項目頁指出 R@1 有提升
  • 相關模型權重包括 vidore/colpali-v1.3-hf,另有 Hugging Face 的 SaMer models 集合

測試與重現路線算清楚:資料要先準備 Flickr30k-Entities,之後訓練 adapter、建立 compressed retrieval cache,再做 inference。原始資料列出 Python 3.10+、CUDA-enabled PyTorch,以及單 GPU/多 GPU 腳本流程,但 evaluation 章節在提供內容中未完整展開,所以更細的 benchmark 設定與完整數字仍要以論文與項目頁為準。

這類做法最適合需要多向量圖文檢索、又在意記憶體與延遲的團隊,例如做 large-scale image retrieval、phrase-level grounding,或者要把 ColPali 類系統壓到較可部署規模的研究與工程項目。它的取捨亦很清晰:不是追求最少 token,而是用較低成本保留日後查詢仍有機會選中的視覺證據。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Qwen, NVIDIA, Image, Python, Dataset 數據集

InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

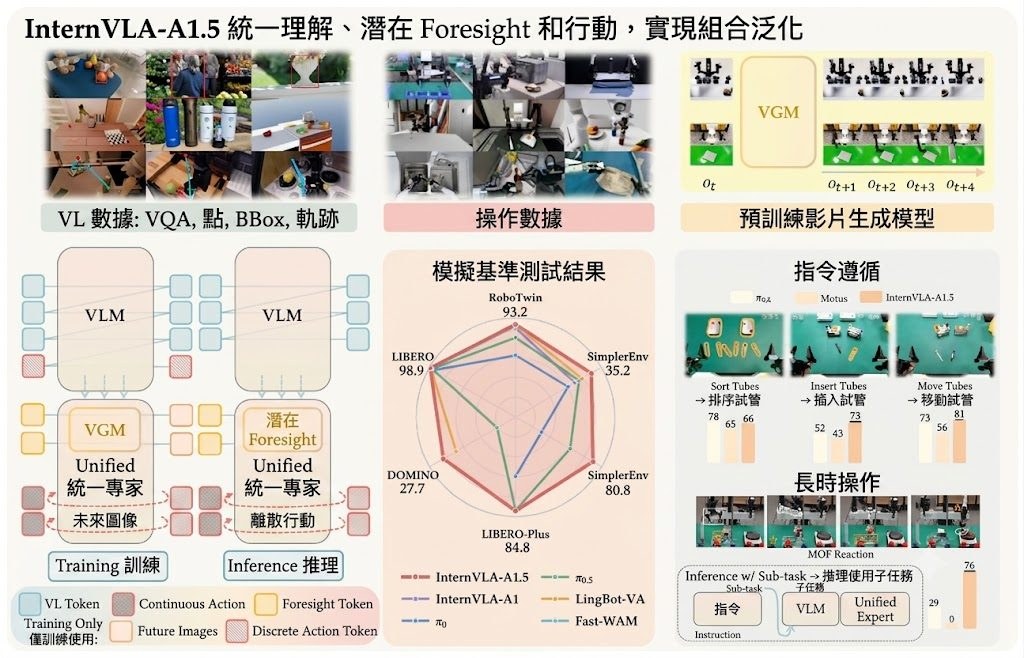
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集

LLM-as-a-Verifier 點樣重寫代理評分

當代理唔只要答得啱,仲要一步步做得穩,粗略打分已經唔夠。LLM-as-a-Verifier把評估拆細,令挑選、追蹤同訓練都更有依據。

LLM-as-a-Verifier

代理系統最常見的瓶頸,唔係生成唔到答案,而係你難以知道它每一步到底做得幾好。LLM-as-a-Verifier屬於開源框架,針對的正是呢個問題:它唔只為最終結果打一次分,而係用更細緻的方式為候選答案、行動步驟同任務準則提供可量化回饋。

現有做法不少仍然依賴單次判斷、粗粒度分數,或者只看最終成敗;作者認為呢種固定範式會忽略不確定性,亦難以支援 progress tracking 同 reinforcement learning。LLM-as-a-Verifier改用三個核心設計重組驗證流程:score granularity、repeated evaluation 同 criteria decomposition,並且直接對 LLM score tokens 的完整 logprob distribution 取期望值,而唔係只取單一輸出。

呢個取向令它同一般 judge-style 評分器有明顯分野。它重點唔在於產生一句評語,而係產生可反覆比較、可分解、可累積的 fine-grained feedback,所以可以用於 Best-of-N selection、pairwise compare,同埋逐步追蹤代理行為變化。README 亦展示了 Python 套件 llm-verifier 的基本用法;安裝方式有提供,但更完整的部署細節主要放在官方文件,而某些流程亦需要 VERTEX_API_KEY 或可回傳 logprobs 的 OpenAI-compatible server。

  • 支援任何 modality 的驗證框架,定位比單一 benchmark judge 更廣
  • 方法核心是細粒度評分、重複驗證、按 criteria 拆解準則
  • 可直接用於 selection、compare、track,同時連到 reinforcement learning
  • 官方列出 Terminal-Bench V2、SWE-Bench Verified、MedAgentBench、RoboRewardBench 等結果
  • 相關模型與服務包括 Qwen/Qwen3.5-9B、Qwen3-8B、Gemini 2.5 Pro,以及 OpenAI-compatible server

表現上,項目聲稱在多個 agentic benchmarks 達到 state-of-the-art,包括 Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 87.4%、MedAgentBench 73.3%,亦提到在 LIBERO 配合 SAC 微調 pi 0 policy 時,sample efficiency 約高 1.8 倍。呢類數字反映它較適合研究團隊、代理平台開發者,同埋想將評估訊號接入訓練迴路的人;單純只想要一個最終分數的團隊,未必需要用到它整套驗證尺度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, NVIDIA, OpenAI, Gemini, Medical醫學, Python, Anthropic, Dataset 數據集

MRPO:醫療多模態推理訓練新路線

MRPO 不是再追最終答案分數,而是直接修補推理中途出錯的位置。醫療 VQA 表現因此更穩,也更有可遷移性。

alt text

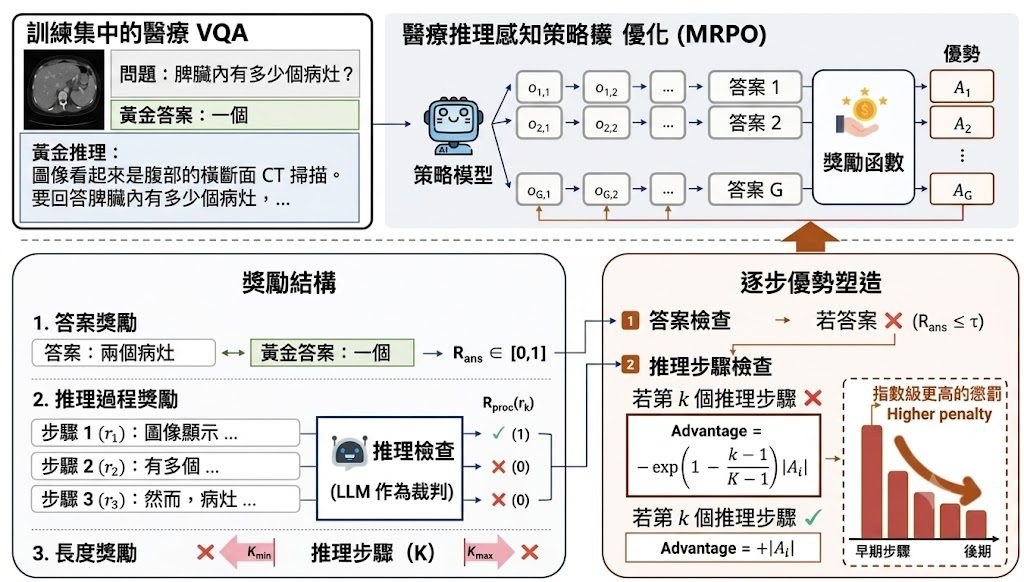
MRPO 是一個用於醫療多模態推理的強化學習框架(reinforcement learning framework)。它要解決的問題不是單純答對與否,而是醫療 VQA 過程中推理鏈一早出錯,之後一路連鎖失誤,令最後答案偏離。

現有 post-training 做法多數偏向 outcome-centric,主要看 final answer correctness 或 sequence-level preferences。作者認為這種範式的問題是 sparse credit assignment,模型知道答錯,卻未必知道究竟由哪一步開始失準;MRPO 因而改寫 GRPO-style advantages,結合 answer-level reward 與 step-wise process rewards,並在最終答案錯誤時,對較早出現的 invalid steps 給予更大懲罰。

這個設計的取向很明確:它不是只罰錯答案,而是重新分配學習訊號,優先修正最早發生的推理錯誤,避免 failure cascades 擴大。README 提到,MRPO 在三個 multimodal LLM backbones 上都優於 standard GRPO 與另一個近期 RL baseline;在 Qwen3-VL-8B-Instruct 上,更以只用 13K training samples 超過較大的醫療 MLLMs,例如 HuatuoGPT-Vision-34B,分數高出 2.79。

  • 核心方法:以 answer-level reward 加 step-wise process rewards 重整 GRPO-style advantages
  • 主要差異:重點放在 first failure,而不是只看最後有冇答中
  • 已公布內容:完整 reinforcement learning recipe、code、datasets 同 infrastructure
  • 可重現方式:項目提供環境腳本、資料下載與前處理流程,訓練資料包含 image、problem、solution 欄位
  • 相關模型:Qwen3-VL-8B-Instruct、HuatuoGPT-Vision-34B,以及 README 提及的另外兩個 multimodal LLM backbones

量化結果最值得留意的是推理質素分析。MRPO 將 early-stage reasoning failures 由 64.0% 降到 13.0%,反映它不只是把答案分數推高,而是令中途推理較少一開始就偏離;這對醫療影像問答尤其重要,因為錯誤往往不是出在最後一句,而是前面觀察與判斷已經失焦。

這個項目較適合研究醫療 AI、醫療影像問答、multimodal reasoning post-training 的團隊參考,也適合想比較 RL 訓練配方差異的人閱讀與重現。它現階段更接近研究原型與訓練方法展示,不是即裝即用的臨床產品;重點價值在於,它把「模型哪一步開始諗錯」正式納入訓練訊號,為醫療 MLLMs 提供一條比只看最終答案更細緻的優化方向。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Image, 框架, Medical醫學

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

MrFlow framework

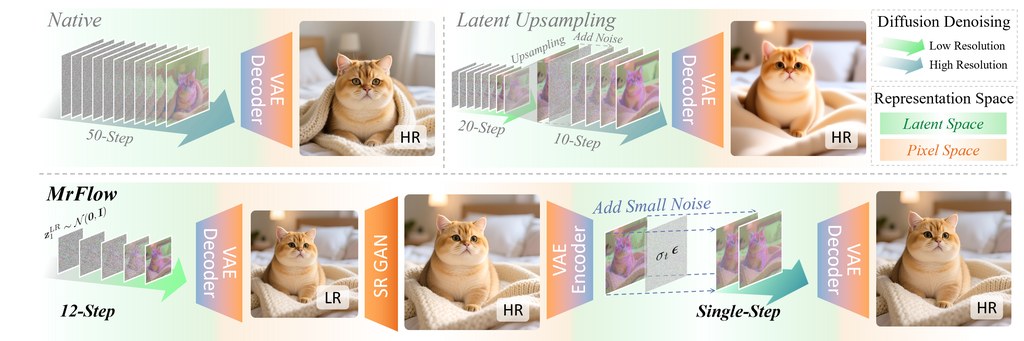
MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

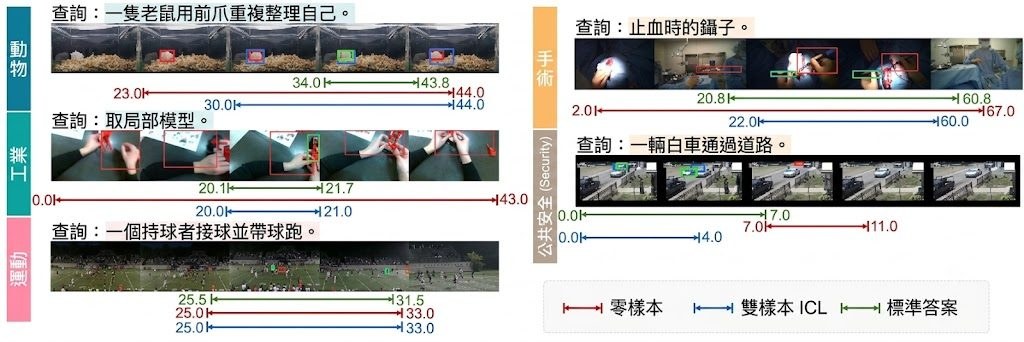
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

PAW:把英文編譯成本地函數

PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

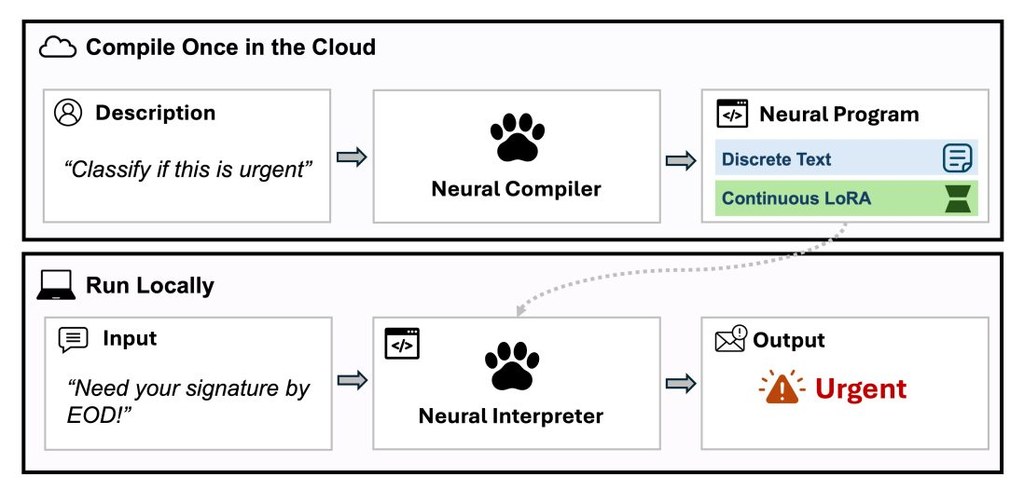
PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型paw-4b-qwen3-0.6bpaw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

Page 9 of 13
1 7 8 9 10 11 13