Mind2Dialogue:讓模型學會推斷用戶內心狀態

這個項目用一套共享狀態的對話模擬流程,讓模型從純對話歷史推回用戶的信念、目標和情緒,從而提升個人化與心理理論能力。

idea-promotion

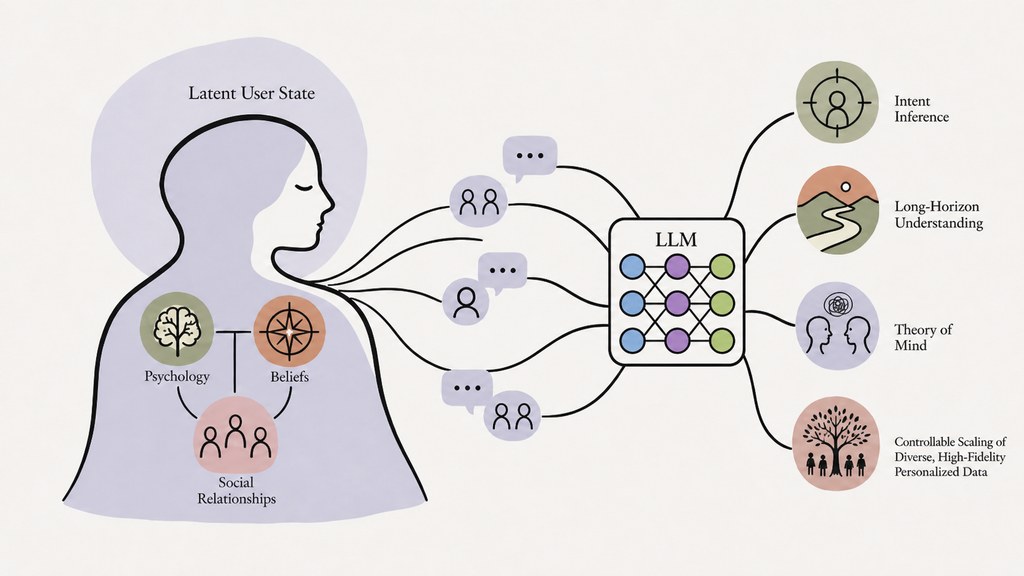
現時很多聊天模型在多輪對話中表現不錯,但一到「這個用戶其實想要什麼、心情如何、跟上一句話背後的脈絡」就容易失去線索。Mind2Dialogue 直接在訓練階段把這個缺口補上:模擬器跟一個 Oracle 助理共用同一個會隨對話演化的用戶狀態,Oracle 寫出的回覆就成為學生模型的訓練目標;學生模型在訓練時只看到 persona 與對話紀錄,要自行還原背後狀態。

整個流程由六個階段組成:規模化產生 persona 種子情境、批次生成對話、用 LLM 作評審過濾低質樣本、從對話抽取 QA 對、語料改寫增廣,最後做微調與評估。設計上刻意把模擬者、Oracle、評審分成不同模型端點,避免自我評分,也容許把較強模型放在 Oracle 位置。情境類型涵蓋終生關係、高頻互動、情緒事件與敏感議題,使訓練語料貼近真實長期陪伴的場景。

在 Qwen2.5-7B-Instruct 上,個人化指標 PrefEval-Gen 比基礎模型高 33.4 分,PersonaMem-v2 高 10.0 分,並在同骨架下壓過加記憶模組與其他個人化方法。Qwen 與 Llama-3.1-8B-Instruct 在 BigToM 等 Theory-of-Mind 基準上也同步進步,代表個人化與心智理論可能共享同一種「從觀察推回未觀察狀態」的能力。OLMo-3-8B-Instruct 則未見轉移,顯示效果仍受骨架預訓練影響。

隨訓練資料量由八分之一擴到全量,三個骨架的個人化分數都穩步上升,呼應「資料規模足夠,學生才能學會狀態還原」這個核心假設。對做對話系統、角色 AI、AI 陪伴或客服助手的研究團隊,這套管線可作為不需要逐句人工標註的個人化資料生成起點;對關心評測的研究者,內附 LLM-as-judge 與消融設定(full、no_privilege、no_state、latent 等)便於追溯不同監督訊號的貢獻。

重點摘要:

  • 共享狀態模擬:模擬器與 Oracle 共用演化中的用戶狀態,Oracle 回覆成為學生訓練目標
  • 零人工標註管線:六階段流程從 persona 種子到微調皆可批次執行
  • 個人化與 ToM 同步提升:Qwen 與 Llama 在 PrefEval-Gen、PersonaMem-v2、BigToM 上均有明顯改善
  • OLMo 未見轉移:效果依賴骨架預訓練特性,OLMo-3-8B-Instruct 在 ToM 上反而下跌
  • 資料越多越好:從 1/8 到全量語料,三個骨架的個人化分數持續上升

項目主頁 · GitHub · 數據集

Categories: 開源, Agentic, 模型訓練, Qwen, LLaMa, Dataset 數據集

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

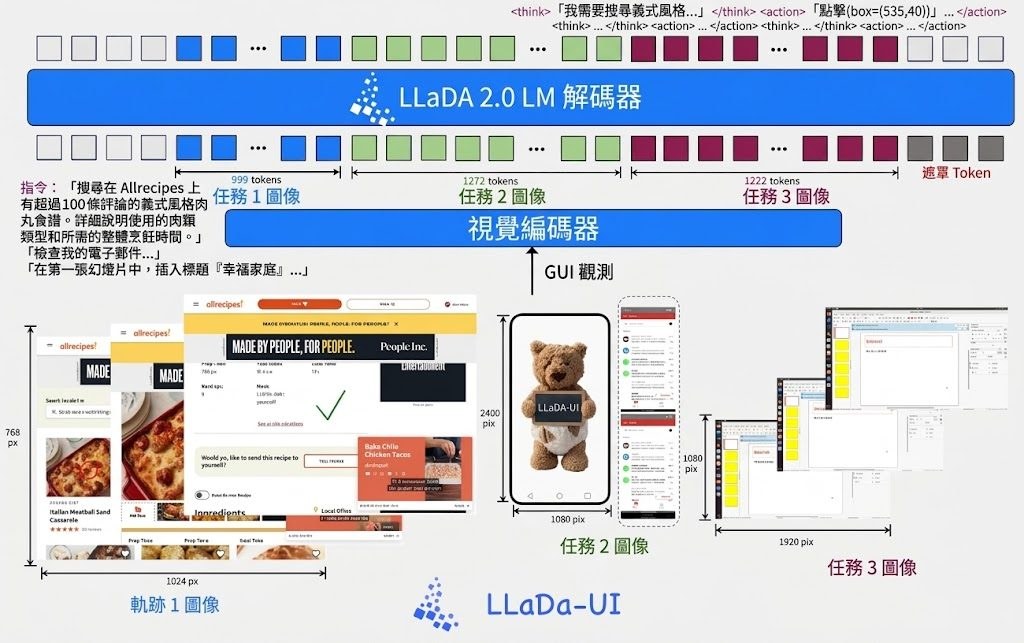
LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bashframes,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, , Anthropic, 動畫, Dataset 數據集

PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

Edge0 開源框架:Mac 本機推論 35B MoE,記憶體僅佔用 2.9 GB

Edge0 是一套開源串流 MoE 推論框架,靠 SSD 專家卸載搭配 LoRA 還原與前置路由器,在 Apple Silicon 上把 35B 等級的 MoE 模型壓到 2.9 GB 活動記憶體就能跑,對想在筆電本機玩大型稀疏模型的人來說是個務實的選擇。

edge0

MoE 模型參數規模愈推愈大,但真正能在消費級硬體本機跑得動的方案一直不多。Edge0 想處理的就是這個落差:它把 SSD 專家卸載、Recover-LoRA 還原、以及 prerouter 路由預測這三招組合成一套可擴展框架,目前以 MLX 後端跑在 Apple Silicon(M1 至 M4)上,CUDA 後端列在路線圖但尚未支援。

隨框架釋出兩個模型檔:edge0-35b(基於 Qwen3.5-MoE 35B-A3B)與 edge0-8b(基於 Ling 3.0 bailing 混合架構),皆以 4-bit 量化釋出。LoRA 配重與 prerouter 頭已隨 checkpoint 一同發佈,edge0 serve 即可直接載入訓練好的完整管線,不用額外拼湊組件。短上下文情境下,edge0-35b 峰值活動記憶體約 2.9 GB,edge0-8b 約 1.0 GB;專家權重以 mmap 方式按需讀取,不會預先佔用 RAM。

TierReleased checkpointInference profile
edge0-35bEdge0/Edge0-35B-A3B-preview4-bit, 40 layers, 256 experts, prerouter K=4
edge0-8bEdge0/Edge0-8B-A1B-preview4-bit, 24 layers, 128 experts, prerouter K=8

使用介面提供 AutoModel、AutoConfig、AutoEngine 自動按模型名稱解析層級。所有 MLX 程式碼集中在 edge0/backends/mlx/,核心邏輯只依賴抽象層,因此日後加入 CUDA 等後端時不必重寫調度邏輯。

  • 類型:開源 MoE 推論框架(搭配兩個預訓練 checkpoint)。
  • 資源門檻:4-bit 35B 模型約 23 GB 磁碟、2.9 GB 活動記憶體;8B 模型約 4.2 GB 磁碟、1.0 GB 活動記憶體。
  • 硬體限制:目前僅支援 macOS Apple Silicon,CUDA 仍在規劃中。
  • 目標用戶:想在 M 系列 MacBook 上本機試跑大型稀疏模型的研究者、開發者,以及對 VRAM 不夠、又不願完全依賴雲端推論的團隊。
  • 差異化:相較純量化或純卸載方案,Edge0 把 prerouter 預測與 LoRA 還原包進同一條管線,讓卸載後的精度損失有明確補償路徑。

Edge0 屬於「先把本地大型 MoE 跑起來」這個務實路線上的工具,限制也很清楚:必須在 Apple Silicon 上跑、長上下文 KV 會額外吃記憶體、目前沒有非 Apple 平台的後端可用。對想驗證稀疏模型在消費硬體可行性的人,這套框架省去了自行整合卸載與適配器還原的功夫;對 NVIDIA 用戶,則要等 CUDA 後端落地。

GitHub

Categories: 開源, 模型, Qwen, NVIDIA, 框架, 工具, Mac, 蘋果

MiniMax H3 首尾幀工作流:ComfyUI 一張面板切換三模式、輸出帶聲影片

這個 ComfyUI 工作流把 MiniMax H3 的首尾幀、Turbo LoRA、影片與音訊 VAE 全部封進子流程,外層直接選模型、改步數與時長,最後由 SaveVideo 輸出 24fps 的帶聲短片。

MiniMax H3 总控面板使用指南

想用兩張圖片框住一段六秒帶聲音的影片,再順手在 ComfyUI 面板上換模型、改步數,這個工作流把這件事收得很緊。整套流程把 MiniMax H3 的基礎模型、Qwen3-VL 文本編碼器、影片與音訊 VAE,以及四步 Turbo LoRA 全部塞進一個子流程,常用參數留在外層,內層只負責解析度對齊 32 倍數、計算幀數、把影片與音訊解碼後合成輸出。

跟一般 ComfyUI 影片節點相比,它最直接的差異是「首尾幀可選」:上方節點接首幀、下方節點接尾幀,兩個都填就是首尾幀生成,只填首幀就退回傳統圖生視頻,兩個都跳過則變成純文生視頻,三種模式不用複製工作流,直接在同一張畫布切換。音訊方面也省事,音訊 VAE 跟影片 VAE 分開載入,輸出端靠 SaveVideo 一次寫入 mp4,不用再手動合成聲道。

部署門檻主要在三個地方:ComfyUI 要支援子圖功能、要額外安裝 ComfyUI-MiniMax-H3-Turbo 節點包以取得 MiniMaxH3TurboLoRA,以及 Hugging Face 上的五個權重檔案要放到對應的 diffusion_modelstext_encodersvaeloras 目錄。JSON 內只記錄檔名而非圖片本體,使用前要把首幀、尾幀重新上傳;工作流也沒有附帶顯存或速度數據,必須自己測試本地硬體夠不夠撐得起 int8 基礎模型加 Qwen3-VL 32B 文本編碼器。

對已經在跑 ComfyUI、又想試 MiniMax H3 首尾幀能力的人,這個工作流算是最低摩擦的入口:不用自己接駁一堆節點,也不用研究子流程內部的取樣細節,外部面板就涵蓋了模型選擇、步數、目標時長、種子、寬高比與百萬像素等設定。對只想快速驗證概念或做短影音素材的內容創作者,這種「拉進畫布、換圖、寫 prompt、執行」的流程會比從零搭建省下不少時間。

重點摘要

  • 類型:ComfyUI 工作流 JSON,屬於模型整合與流程封裝類工具,目標是簡化 MiniMax H3 帶聲影片生成。
  • 核心能力:首尾幀、首幀圖生視頻、文生視頻三種模式可切換,並內建音訊解碼與合成。
  • 關鍵依賴:ComfyUI 需支援子圖,另需安裝 ComfyUI-MiniMax-H3-Turbo 節點包與五個 Hugging Face 模型檔案。
  • 輸出規格:24fps,寬高自動對齊 32 倍數,時長與步數可在外層調整。
  • 限制:未提供顯存峰值、速度與相容性測試,需自行驗證本地硬體;JSON 內只存圖檔名,圖片要重新上傳。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, Video, Image, Audio, 工具, Content Creator, MiniMax

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, , Dataset 數據集

Perplexity 開源 Lily:Mac 本地推理專用提速引擎

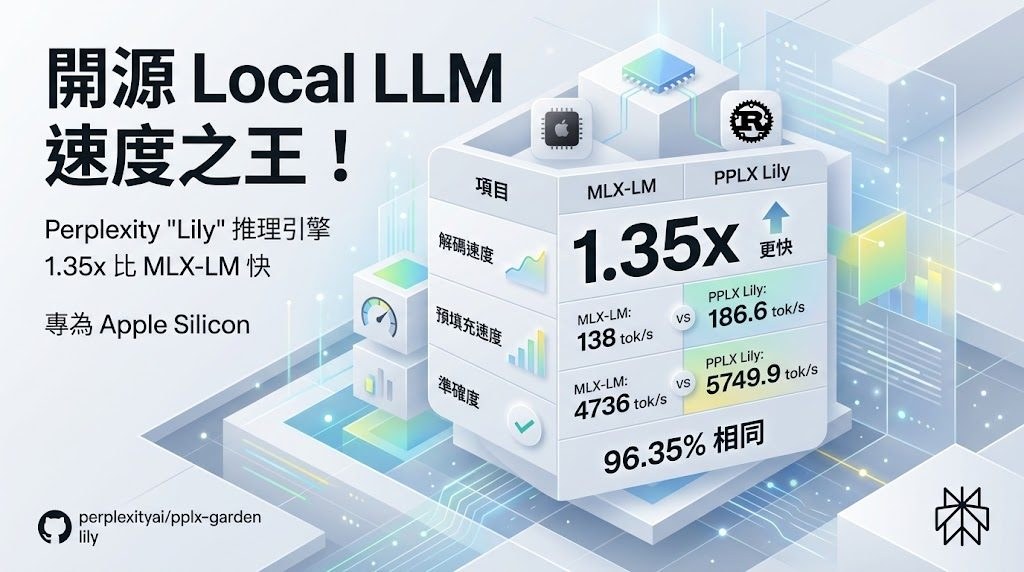
Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, , 蘋果, Dataset 數據集

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, , 語音, Dataset 數據集, 廣東話

Page 1 of 13
1 2 3 13