CADENA 把 3D 網格逐步還原成 CAD 程式

想由3D mesh 反推可編輯 CAD 流程,CADENA 提供了一條幾務實的路。它唔係一次過寫完整程式,而係每步都先執行、再比較幾何差異。

Repository image for zhemdi/cadena

做 3D reverse engineering,最大痛點唔係生成一段似樣代碼,而係生成之後能否真的建出可用、可編輯、而且封閉的幾何。CADENA 屬於模型加推理流程的參考實作,目標是把 3D mesh 重建成 parametric CAD program;它採用 stepwise inference,每次只發出一個 operation,先執行目前前綴,再用目標幾何與已建幾何的差距決定下一步。

這種做法的價值,在於把「一次過輸出整段程式」改成可檢查、可回退的逐步生成。倉庫內的 inference/ 會做 vLLM 服務、per-operation expansion 同 prefix selection,rl/ 則負責 sandboxed prefix rendering 與排序分數;系統只保留能令 IoU 改善的步驟,所以多走幾步不會令結果更差。代價同樣清楚:部署要 Python 3.10+、CUDA GPU、vLLM,同時依賴 OpenCASCADE via CadQuery,環境比一般 Vision-Language 模型推理更重。

模型本身用的是 Qwen2-VL-2B policy,Hugging Face 釋出 sft 與 rl 兩個階段,當中 rl 對應 CADENA-RL。輸入不是單張截圖,而是八個視角拼成一張圖,六個軸向視圖加兩個等角視圖;目標物放在綠色通道,當前已建立幾何放在紅色通道,模型讀到的其實是尚未補齊的殘差。這種設計直接把「下一刀應該補邊度」轉成視覺訊號。

幾個值得留意的重點:
– 倉庫提供完整推理、資料集建立、評分與可視化流程,但不包含用來合成訓練語料的 rule-based program generator。
– cadgen/ 只有 DSL runtime 的執行半部,較適合做還原、測試與基準比較,唔係完整資料生產管線。
– 預設流程會由 mesh 目錄建立 inference dataset,再輸出每一步的程式、輸入圖同 built STL,方便檢查中途錯誤。
– 無效預測會被剔除:建不出來,或者結果不是 watertight,都不算有效答案。
– 評分包含 GMS、IoU、CD,而且結果會按 family 及整體一併報告,避免單一類型零件拉高平均值。

適合研究 CAD reverse engineering、幾何生成、製造前處理,或者想把 mesh 轉回可參數化編輯流程的團隊。現階段最實際的理解方式,是把 CADENA 看成一套偏研究導向、但已經有明確 benchmark、checkpoint 同 rollout 腳本的開源項目;可重現性做得不錯,不過完整訓練資料生成鏈未公開,想延伸到自家資料或重訓流程,仍要補上不少工程工夫。

GitHub · 模型

Categories: 開源, 多模態模型, Qwen, Google, NVIDIA, 框架, 3D, Python, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

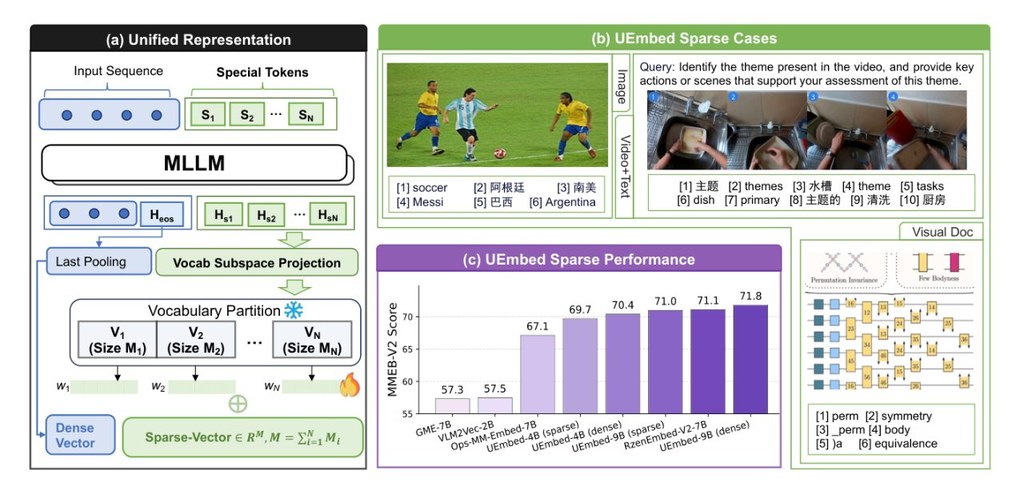
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

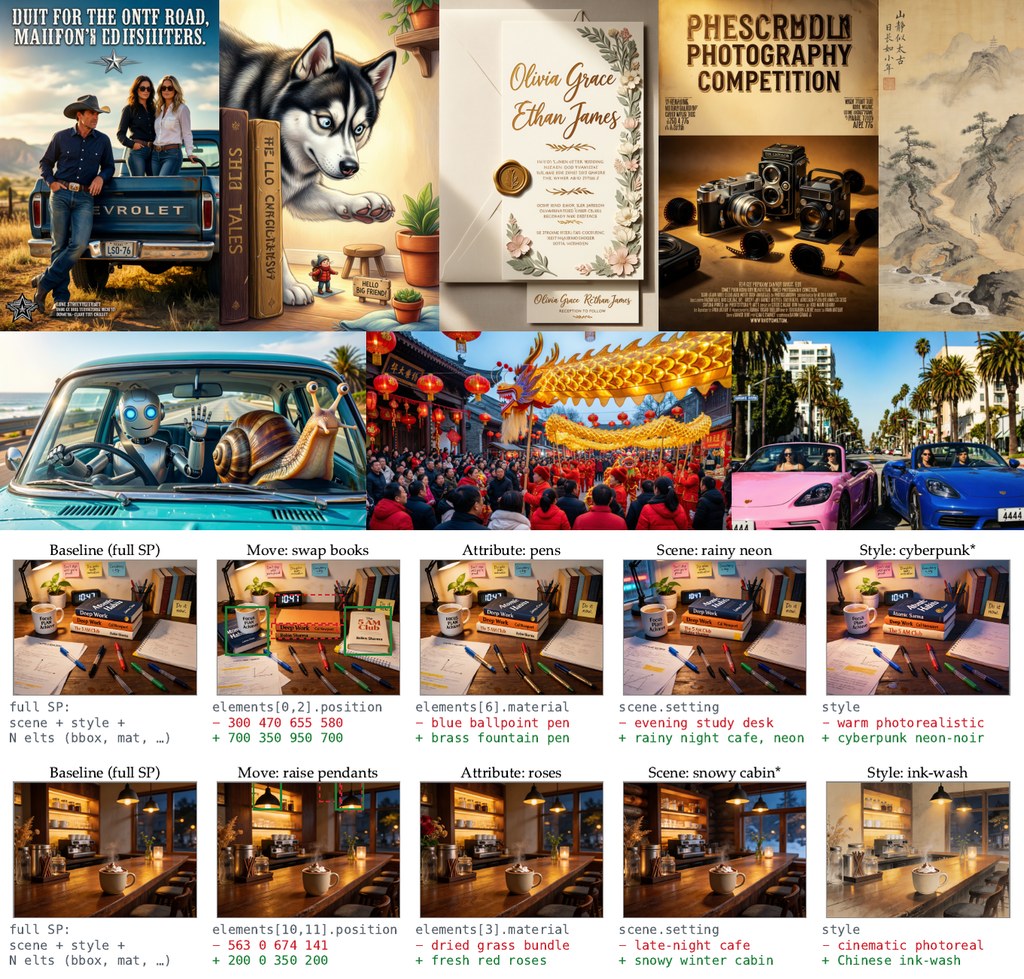
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

Youtube 影片

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

PhiZero 用物理語言先推演再生成影片

PhiZero唔係直接由畫面猜下一格,而係先用一套離散物理語言推演世界點變,再把結果還原成影片。對想做互動模擬同世界模型的人,呢個取向幾值得留意。

Og image

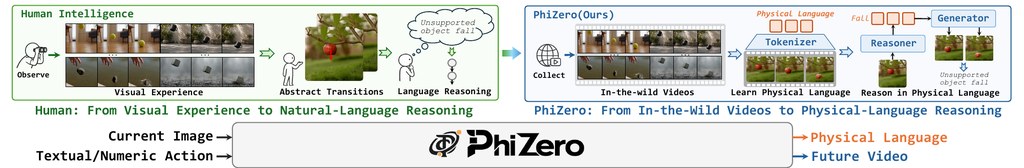
生成影片最難處理的,往往唔係畫面清唔清,而係物件點移動、碰撞同延續。PhiZero 屬於世界模型(World Model),焦點放在「先理解世界狀態點轉變,再生成畫面」,用較細緻的 physical language 去表達變化,減少直接由像素預測帶來的不穩定感。

它想解決的問題很明確:自然語言太粗略,難以完整描述複雜物理過程;純視覺生成又未必能穩定保留因果同動作連貫性。PhiZero 於是從大量無標註影片學出一套 compact discrete representation,先把相鄰影片狀態之間的轉變編碼成 physical language,再交由模型根據首幀畫面同文字動作意圖,預測之後的狀態序列,最後渲染成影片。

它採用 reason-then-render 流程。前段由 Physical Language Tokenizer 抽取相鄰 latent video states 的有序特徵,配合 FSQ 離散化成 physical language;後段由以 Qwen3-VL-4B 初始化的 autoregressive VLM 負責推演,再用訓練好的 diffusion decoder 輸出影片。這種拆法的價值,在於同一套 transition representation 可以重用在 physically realistic generation、action-conditioned simulation、interactive rollouts 同 zero-shot transfer,而唔係只限單一生成任務。

  • 先推演世界轉變,再生成影片,重點放在因果與動作連續性
  • physical language 來自無標註 in-the-wild videos,自監督學習轉變結構
  • 以 Qwen3-VL-4B 作為 reasoner 基礎,並擴充 25K atomic symbols 詞彙
  • 同一表示方式可支援生成、模擬、互動 rollout 同 transfer

現有資料顯示,PhiZero 的訓練資料同時結合真實與模擬影片,並經過逐步篩選,令模型由廣泛視覺經驗收斂到較多動態互動片段。官方頁面已展示 demos,但程式碼仍標示為即將推出,所以現階段較適合把它看成一個值得關注的世界模型方向:它不是單靠更大影片模型硬推結果,而是嘗試先建立可推理、可重用的物理語言介面。

項目主頁 · Paper

Categories: 視覺模型, 世界模型, Qwen, Video

SkillRise 把技能文件變成可累積學習

同一個策略連續解幾類相關任務,邊做邊整理可轉移的技能文件,正是 SkillRise 想處理的學習斷層。它不是只追單次成功率,而是想讓經驗在下一題繼續生效。

SkillRise method

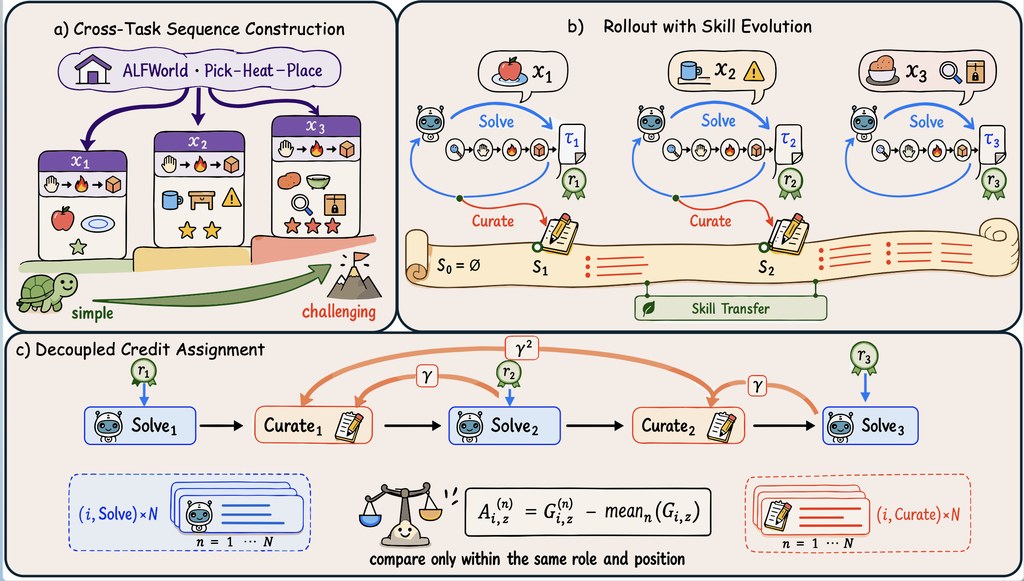
做完一題就把經驗丟掉,往往是代理系統訓練最可惜的地方。SkillRise 屬於強化學習框架,焦點放在 cross-task skill learning:讓同一個 policy 按次序處理同一家族的任務,一邊解題,一邊把軌跡整理成會持續演化的 skill document,將前一題學到的做法帶去下一題。

它的取向不是把每個任務分開訓練到最好,而是刻意安排由淺入深的任務序列,讓 Solve 與 Curate 交替發生。這個設計針對的是跨任務遷移能力,而不是單一回合表現;代價是環境設定與資料組織較講究,ALFWorld、WebShop 要跟隨 verl-agent 的環境配置,ScienceWorld 則沿用 BEACON 的 setup,並且要先整理模型路徑、資料路徑與追蹤設定。

README 提供了可直接對照的執行方式:同一套 examples 結構下,既有 SkillRise,也有 GRPO baseline,方便把新方法與基線放在相近條件下比較。模型部分從腳本名稱可見已準備 Qwen3-4B 配置,底層也建立在 veRL、verl-agent、BEACON 等現成項目之上,所以它比較像研究與實驗工作流的延伸,而不是即裝即用的產品。

  • 把「解任務」與「整理技能」拆成兩個交替角色
  • 用同一家族、逐步變難的任務序列測試技能轉移
  • 在 ALFWorld、WebShop、ScienceWorld 都有評估
  • README 明確保留 GRPO baseline 方便做對照

成果描述指向一個清楚結論:SkillRise 在 ALFWorld、WebShop、ScienceWorld 的整體結果最好,勝過 prompting-based methods 與 RL baselines。較適合研究 Agentic workflow、長程技能累積、跨任務學習的團隊;想觀察 skill document 如何影響後續決策的人,也會比只看最終分數得到更多訊息。

GitHub

Categories: 開源, Agentic, Qwen, 提示詞, Skill 技能

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

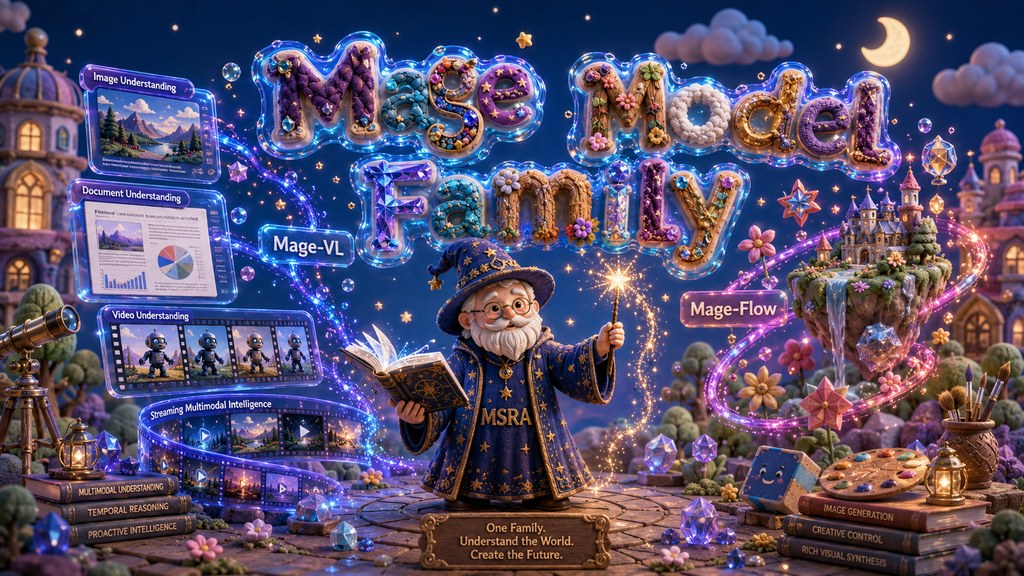
當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

ReDesign 把平面圖轉為可編輯設計

ReDesign想做的,就是把一張匯出圖,文字、圖層轉成獨立像素圖層結構,重新變成可編輯設計。

Repository image for jintae-00/ReDesign

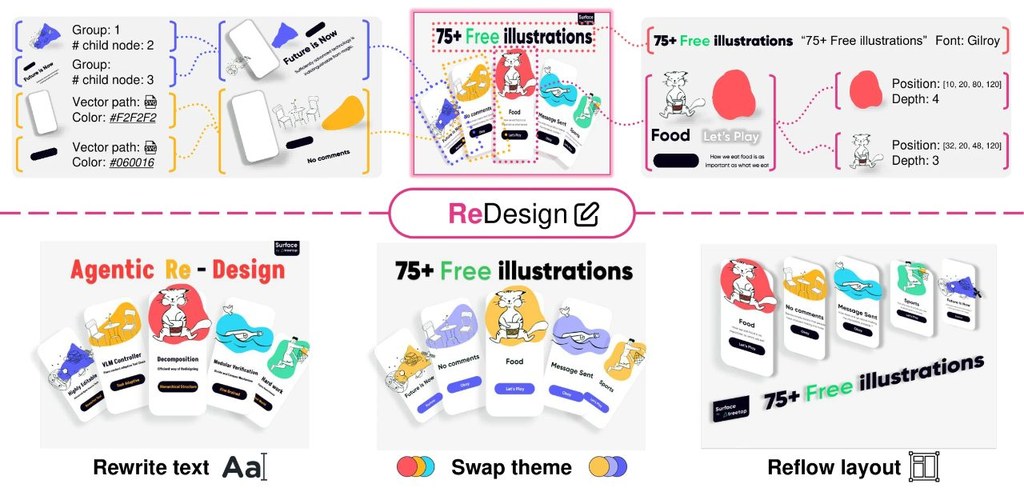
設計原檔遺失之後,最麻煩唔係畫面睇唔到,而係改唔到字、拆唔開圖層、調唔到前後次序。ReDesign屬於Agentic取向的研究型工具,目標係由單張 raster image 重建出可編輯設計結構,輸出成帶有文字、向量形狀、群組同 z-order 的 JSON hierarchy。

它的判斷方式唔係一次過猜完整個版面,而係將設計當成 layer tree,由大區域開始逐層拆細,再用 verifier 檢查每一步成唔成立。呢個取向比起只做 OCR、只做分割,或者直接做多圖層分解更完整,代價就係系統較重,亦要配合多個視覺工具同較高 GPU 記憶體,當中 Qwen 相關 worker 官方已寫明大約要對應 55 GB 級別資源先容易跑得順。

相關模組之間的分工幾清楚:VLM controller 負責揀動作,文字會交由 PaddleOCR、字體辨識、Hi-SAM 同 LaMa 處理;物件與圖層則會用到 Qwen-Image-Layered、GroundingDINO、SAM 2、connected-component analysis 同 VTracer。換句話講,呢個項目唔係單一模型,而係把多個模型與工具串成一條可驗證的還原流程,較適合研究設計還原、可編輯圖形生成,或者想將靜態素材重新帶回設計工作流的團隊。

  • 單張平面圖可還原成可編輯 JSON hierarchy
  • 支援文字、向量形狀、圖片、群組與 z-order
  • 採用 coarse-to-fine tree expansion,加上 verifier 修正分支
  • 效能展示基於 Figma-909,指標上普遍優於多個 baseline

評測方面,項目頁面列出 Figma-909 這個 Dataset 數據集,並顯示 ReDesign 在 L1、PSNR、LPIPS、PQ 同 F1 等指標整體領先 baseline,說明它唔只重建外觀,亦較重視元素級別的可編輯性。儲存庫已提供 agent、baseline 同工具後端結構,但它更似一個研究系統而唔係輕量腳本;較值得留意的是多 GPU 分片、平行 worker 同視覺工具的資源安排,較適合有運算環境的研究者或產品團隊深入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Qwen, Image, 影像處理, Dataset 數據集

Page 13 of 21
1 … 11 12 13 14 15 … 21