SimLoss 用單次生成多階段圖像描述

由 UMass Amherst 與 Adobe Research 團隊開發,SimLoss 想解決圖像描述太籠統的老問題。它把細節監督搬到 embedding space,換來更快推理與更高描述精細度。

Repository image for srynsh/SimLoss-Image-Captioning

UMass Amherst 與 Adobe Research 團隊,瞄準的是圖像描述常常只講到大意、漏掉材質、數量、紋理同位置關係的問題。SimLoss 屬於影像 captioning 模型訓練方法,核心不是再加一條冗長後處理流程,而是令 Vision-Language Model 在單次生成前,先把隱藏狀態對齊影像 embedding,直接補回細節監督。

它的技術關鍵,在於用 reference-free 的 embedding-space objective 取代人手撰寫細粒度 captions,亦唔需要先跑多階段系統去製造 pseudo-captions。SimLoss 列出兩條路線:SimLoss FFT 會透過本地可用的 Qwen3-VL-Embedding-2B 反向傳播;SimLoss GRPO 則把 Gemini Embedding 2 當成 black-box reward。兩者都建基於 Qwen2.5-VL-7B-Instruct captioning policy,但前者偏向直接做表徵對齊,後者更接近以獎勵訊號微調。

同類方法常見做法,是生成、拆解、驗證、重寫逐步修補描述內容;SimLoss 揀的是保留 single-pass inference,換取更低延遲,再用對比式學習補回細節。代價是它仍然依賴外部 embedding 模型品質,而且項目展示的是研究基準與訓練框架,不是即裝即用的成品服務。
IIW-400 測試中,SimLoss FFT 配合 Qwen2.5-VL-7B backbone,把 precision 由未調整 backbone 的 0.788 提升到 0.849,F1 與多階段 CapMAS 接近到難以區分,同時推理速度約快 20 倍;SimLoss GRPO 則拿到最強 recall。呢個取捨幾實際:想要更準確地講出畫面細節,又唔想接受多步驗證延遲的團隊,會比一般 captioning fine-tune 更感受到差別。

  • 同一儲存庫放入 SimLoss、CapMAS、PAPO、DCScore RL 等基線,方便直接比較
  • 單次生成保留低延遲,同時補足 attributes、counts、textures、materials、spatial relations
  • 提供方法分目錄、資料與 checkpoint 說明,但大型資料與模型檔案未隨儲存庫附上

研究、內容理解、影像搜尋標註,甚至要為電商圖片或視覺資產建立更細緻描述的團隊,都會較容易受益。安裝與執行入口在儲存庫內有 setup 與各方法,但目前公開資訊主要指向研究復現流程;想完整重跑訓練或延遲基準,仍要另外處理資料集、checkpoint 同對應運行環境。
項目主頁 · GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Gemini, Image

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

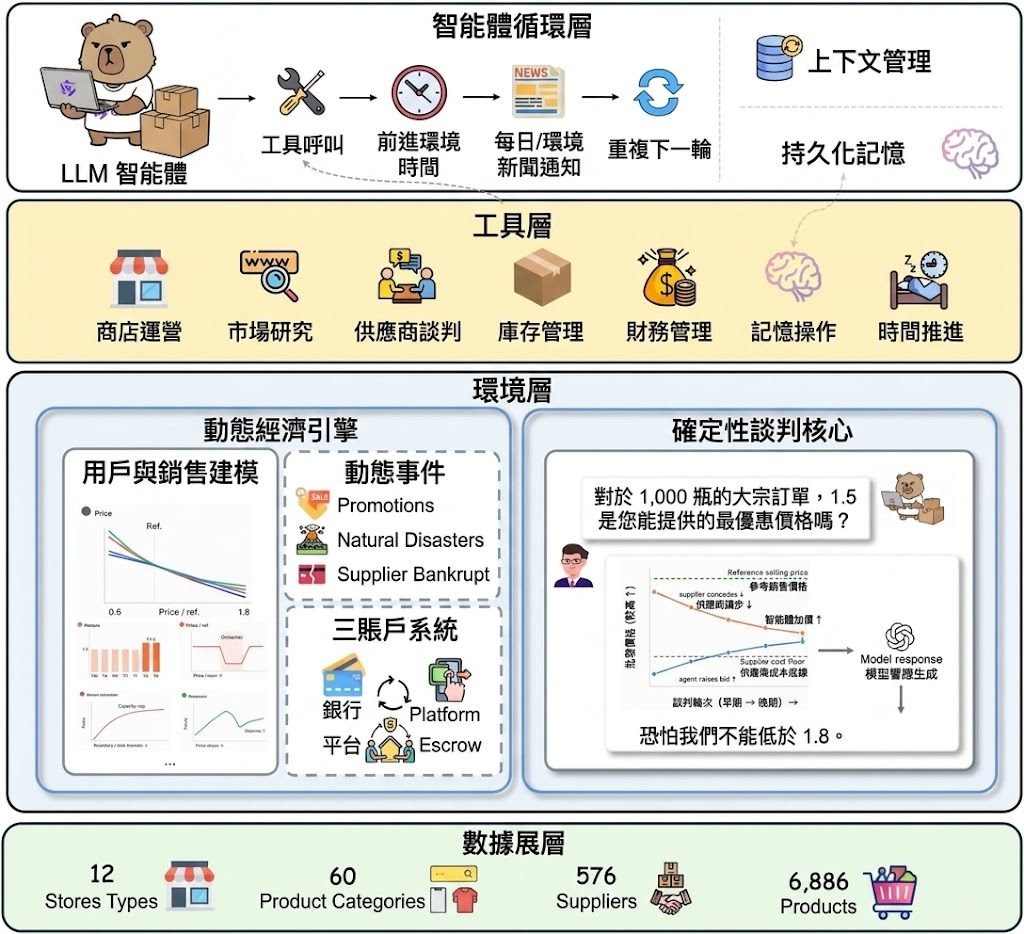
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

LightNav-0:一句說話驅動四種機械人零樣本導航

LightNav-0 是一個通用導航模型,把預訓練視覺語言模型 Qwen3-VL 的空間認知能力對齊到導航任務,無需任務專用頭即可同時處理指令跟隨、開放詞彙物件導航與視覺追蹤,並零樣本遷移到人形、四足、輪式及空中機械人。

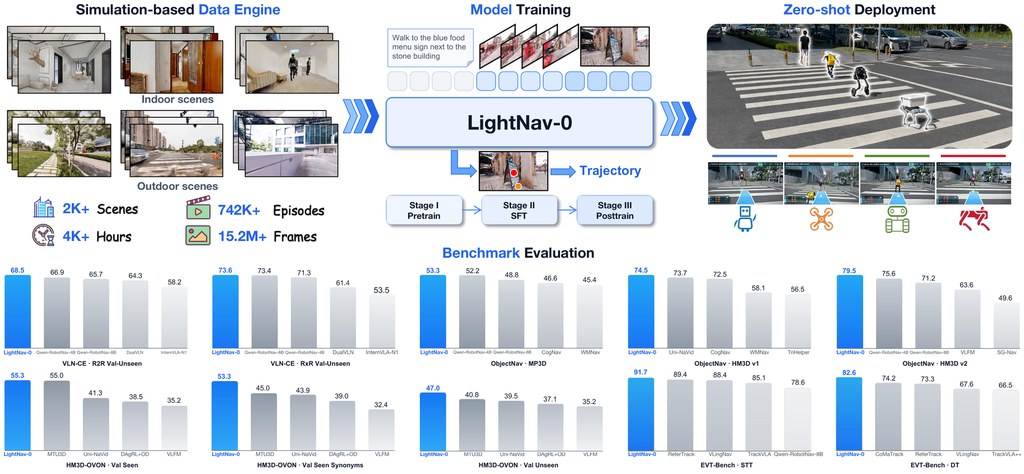
LightNav-0 overview: a simulation-based data engine, three-stage model training, zero-shot deployment onto four robot em

你叫一部機械人「去到公園入口嗰張長椅」,佢就要自己搵到、避開障礙、仲要處理自己對眼睇到嘅畫面——LightNav-0 就係針對呢類跨場景、跨形態嘅導航需求。佢屬於模型類項目,核心想解決嘅問題係:傳統導航系統每換一種機械人或場景就要重新訓練或加任務頭,零樣本泛化能力薄弱。LightNav-0 選擇唔加 waypoint predictor、唔加任務專用動作頭,淨係擴展詞表,加入雙通道指向 token 同 RVQ 動作 token,等空間推理同動作編碼都直接由 Qwen3-VL-4B-Instruct 原有嘅自回歸 LM head 解碼。

要做到呢點,訓練數據係關鍵。項目用咗一套 Real2Sim2Real 數據引擎,將 2,000 幾個互聯網收集嘅真實場景轉成可重複使用嘅模擬環境,產生 4,000 幾個鐘嘅視覺語言動作經驗,再分三階段訓練:Embodied Reasoning 中訓練、Embodied SFT、Online RL。呢種做法繞過咗真實遙操作收集速度慢、成本高嘅瓶頸。

同典型做法比,差異在於用模擬合成代理真實經驗,再透過統一 token 介面讓指令跟隨、開放詞彙物件導航、視覺追蹤共享同一模型,部署時直接零樣本落地到四種機械人形態,唔需要逐個微調。結果方面,官方指 LightNav-0 喺十個模擬設定上取得 state-of-the-art,並喺人形、四足、無人機同輪式機械人上完成真實遷移測試。

做機械人通用導航研究嘅團隊、要做具身 AI 落地嘅初創,或者關注 Physical AGI 路線嘅研究者,會最容易從中受惠。對一般開發者嚟講,理解入口係 Hugging Face 上嘅模型權重、論文同項目頁提供嘅模擬評測結果。

重點摘要:

  • LightNav-0 係以 Qwen3-VL-4B-Instruct 為骨幹嘅通用導航模型,無任務專用預測頭
  • 用統一 token 介面同時覆蓋指令跟隨、開放詞彙物件導航同視覺追蹤
  • Real2Sim2Real 數據引擎將 2,000+ 真實場景轉化為 4,000+ 小時訓練經驗
  • 三階段訓練流程:Embodied Reasoning 中訓練、Embodied SFT、Online RL
  • 零樣本遷移至人形、四足、輪式及空中機械人,喺十個模擬基準宣稱達到 SOTA

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, Qwen, World-Action Model, Robotic, AGI

CogEvol-4B 離線模型在手機筆電直接生成完整互動課程

CogEvol-4B 把一句課程大綱變成結構化投影片 JSON 加可獨立運行的互動 HTML,全程在筆電離線完成,無需 API 或雲端。

BF16 slide render

一般提到 AI 自動生成教材,多半還是要連雲端 API 才能輸出 HTML,但 CogEvol-4B 的做法是把整個流程壓進一個 2.4 GB 的 Q4_K_M GGUF 檔案。它以 Qwen3.5-4B 混合架構(48 層 GDN 線性注意力 + 16 層全注意力)為底,經過五萬多筆生產驗證樣本的 SFT,再做投影片 RL 與 HTML RL 兩階段強化,結果是單次前向傳遞就能同時吐出結構化投影片和自包含的互動式 HTML,不需要任何外部依賴。

在 MacBook Pro M2 Pro 16 GB 上,模型跑出約 33 tok/s 生成、470 tok/s prefill,整份互動課程約六分鐘完成。對教師、培訓設計師或自學者而言,這意味著斷網也能把一行大綱擴展成可互動的學習素材,不用排隊等雲端,亦沒有 API 成本。

項目可整合 OpenMAIC 與評測工具,權重放在 HuggingFace,並已整合到開源平台 OpenMAIC,透過 .env.local 切換本地 provider,再加上一個 runtime brief expander 補丁即可在斷網環境下渲染所有 widget。

重點摘要:

  • 離線可用:模型、應用、素材全部本地,關 WiFi 仍能完整跑
  • 極輕量部署:單一 2.4 GB GGUF 檔,Apple Silicon、CUDA、CPU 皆可
  • 一鍵生成:一句大綱直接變投影片 JSON 加可互動 HTML,無需 agent loop
  • OpenMAIC 原生整合:本地 provider 設定加上補丁,斷網渲染 widget
  • 雙重授權:程式碼 MIT、權重 Apache 2.0,可商用且易於二次開發

項目主頁 · GitHub • 模型

Categories: 開源, Agentic, 模型, Qwen

VoiceMem 讓語音 AI 記住你的情緒與偏好

VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

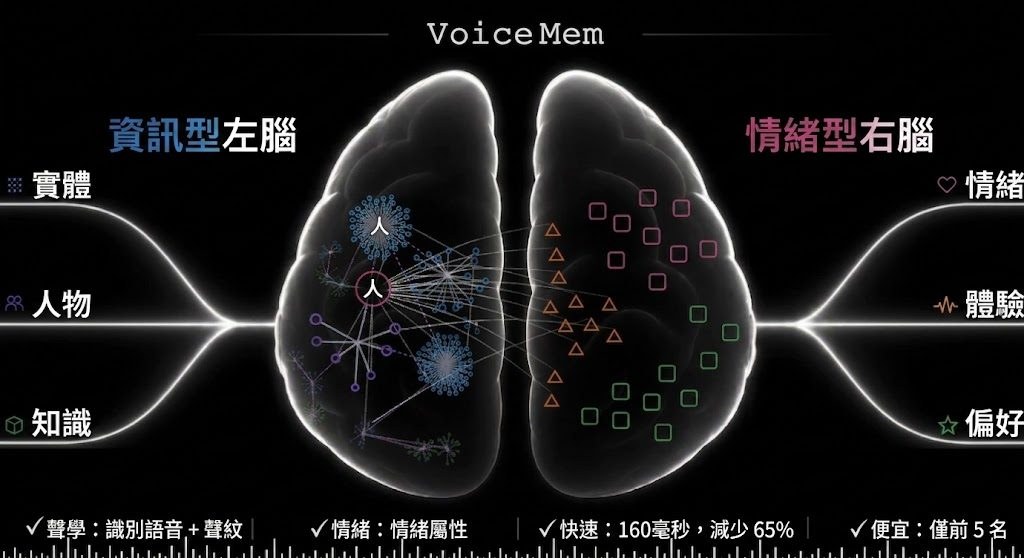
語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 清華大學, Agentic, Embedding, 多模態模型, Qwen, Python, 庫, 語音

Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

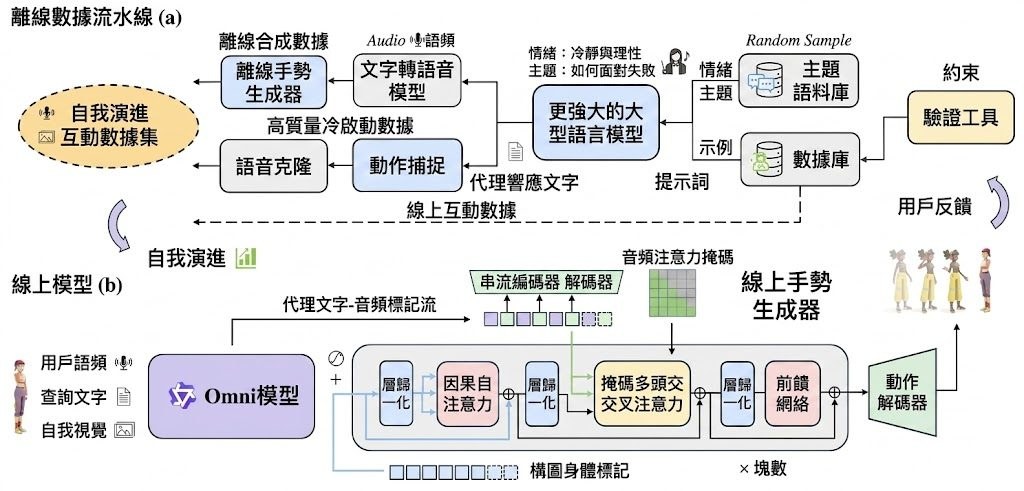
Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

TLive-Omni:專攻直播電商的多模態理解模型

TLive-Omni 將影像、影片、語音和文字統一成文字輸出,特別適合要即時理解直播內容的場景。它同時處理商品畫面、聲音與對話脈絡,目標是減少直播電商裡資訊斷裂的問題。

logo

TLive-Omni 是一個多模態理解模型,針對直播電商場景,把影像、影片、語音和文字整合到同一個文字輸出介面。對做直播監控、商品理解、內容標註或客服輔助的人來說,它處理的是同一場直播裡多種訊號難以對齊的問題。

這個項目建基於 Qwen3.5 backbone,再接入 AuT audio encoder 和輕量 MLP 對齊層,並用 timestamped Per-vGrid 把聲音片段和對應畫面放在一起。它支援最長 256K tokens context,適合長時間直播流的連續理解,而不是只看單段截圖或單句語音。

訓練流程分三階段 SFT,先做語音與語言對齊,再擴展到完整多模態指令跟隨,之後加入 Faithful-RFT,強調回答要貼近直播場景的即時需要。README 亦列出聲音辨識、講者分析、商品視覺定位、文字辨識、時序定位、影片密集描述和 omni-modal QA 等能力,顯示它不是單一功能模型,而是面向直播任務的綜合型系統。

  • 4B 和 9B 版本都已公開,方便按算力和部署成本選擇。
  • 在直播電商的音訊、影像和影片任務上有不錯表現。
  • 對一般基準也有泛化能力,不只局限於單一場景。
  • 更適合需要長上下文、多訊號同步分析的團隊。
  • 取捨在於它很聚焦直播電商,未必是通用多模態助手的最佳替代。

整體來看,TLive-Omni 把直播場景最麻煩的訊號對齊、長上下文理解和即時回答放在同一條路徑處理,對做電商直播分析、內容審核和銷售輔助的團隊會更實用。它的價值不在於把功能堆滿,而在於把多模態理解收斂到直播工作流裡真正會撞到的問題。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 多模態模型, Qwen, Video, Audio, 語音

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

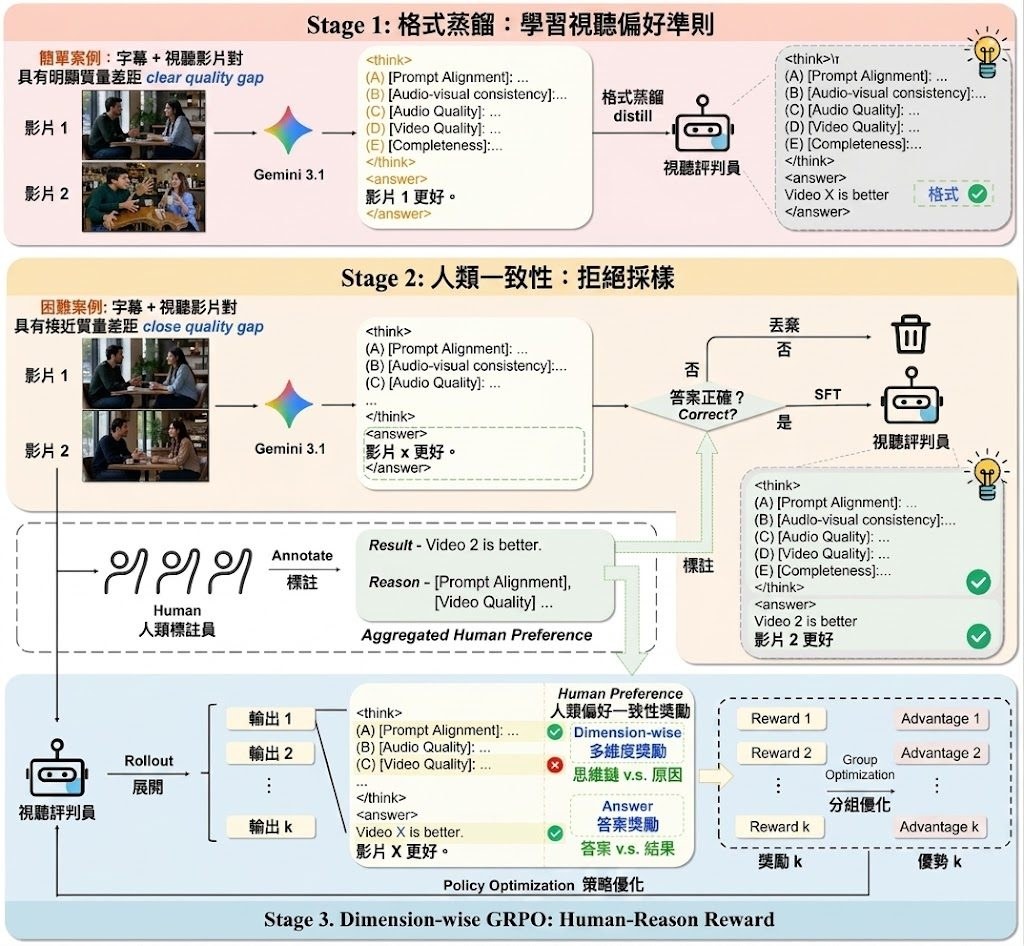
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

UniSpace:把理解、生成與編輯放進同一視覺空間

UniSpace 嘗試用同一套視覺表示處理影像理解、生成與編輯,但首個程式版本仍未包含訓練流程。

UniSpace logo

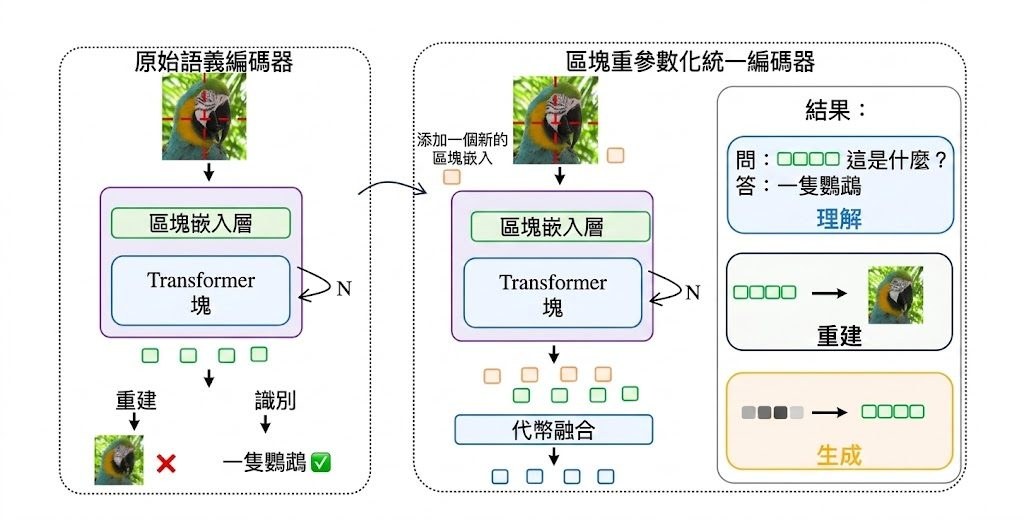
影像模型往往要在語意理解與畫面細節之間取捨,UniSpace 以統一視覺表示同時處理理解、生成和指令式編輯,定位是多模態模型及推理評估項目。它由 patch-reparameterized vision encoders 和 Qwen3-8B Mixture-of-Transformers 組成,前者保留預訓練模型的語意能力,再補足重建與生成所需的細節。

三款 encoder 分別是 PR-SigLIP2、PR-DINOv2 和 PR-Qwen-ViT;UniSpace 則使用配備 Qwen-based patch-reparameterized tokenizer 的視覺空間。這種分工讓同一套表示可以連接理解、文字生成影像及影像編輯,但也代表模型效果取決於 encoder、tokenizer 和多模態 backbone 能否協調工作。

ImageNet-1K 256 × 256 重建測試使用 50,000 張驗證影像,PR-DINOv2 取得最高 PSNR 30.84、SSIM 0.90 和最低 rFID 0.14。生成測試同樣使用 50,000 個樣本;PR-DINOv2 配合 Classifier-Free Guidance (CFG) 後,gFID 為 1.877、IS 為 274.16,但 Recall 由 0.637 降至 0.605,反映畫面品質與覆蓋範圍之間仍有取捨。

目前最需要留意的是可重現性,而不是安裝難度。儲存庫屬於 paper-time landing release,首個程式版本只會提供 inference 和 evaluation,訓練程式及內部數據管線不公開;在預期檔案和 checkpoints 尚未完整發布前,fresh clone 不能直接執行命令。研究團隊、模型評測人員和需要比較視覺 encoder 的開發者可先參考固定 seed、採樣步數及評測規則,待穩定版本發布後再驗證結果。

  • 能力範圍: 統一支援影像理解、生成與 instruction-based editing。
  • 模型關係: PR-SigLIP2、PR-DINOv2、PR-Qwen-ViT 提供視覺表示,Qwen3-8B Mixture-of-Transformers 負責多模態處理。
  • 評測結果: PR-DINOv2 重建 rFID 0.14,UniSpace GenEval 整體分數 0.84,DPG-Bench 為 86.49。
  • 限制: 目前欠缺可由 fresh clone 直接執行的完整程式、訓練流程及內部數據管線。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Clone, Dataset 數據集

OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

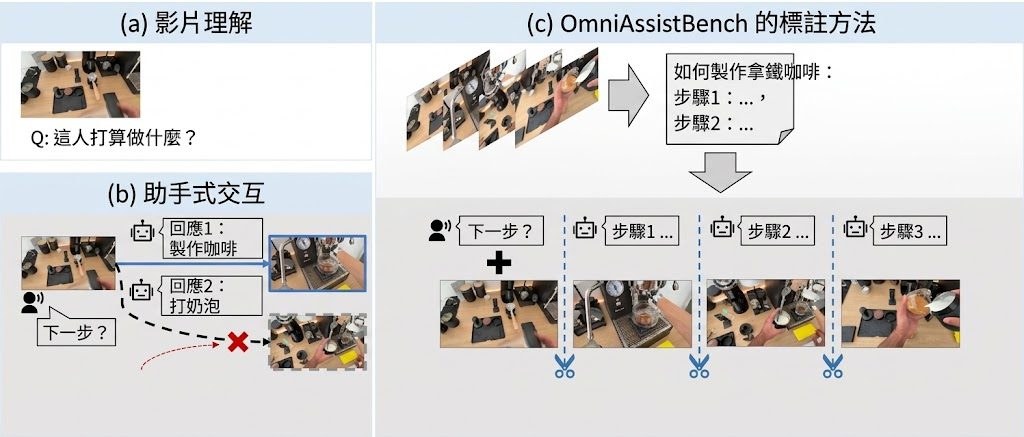
當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

Page 10 of 21
1 … 8 9 10 11 12 … 21