OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

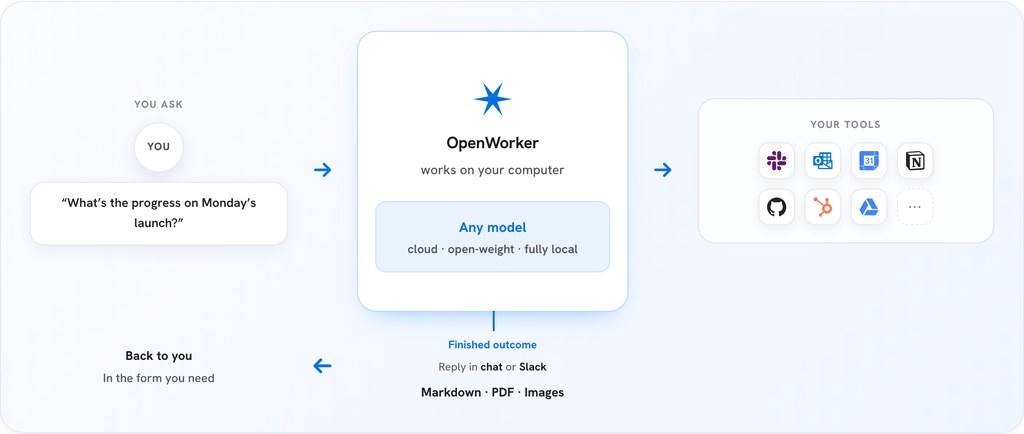
OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。
項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

TrajLoc 把路線描述對準衛星圖

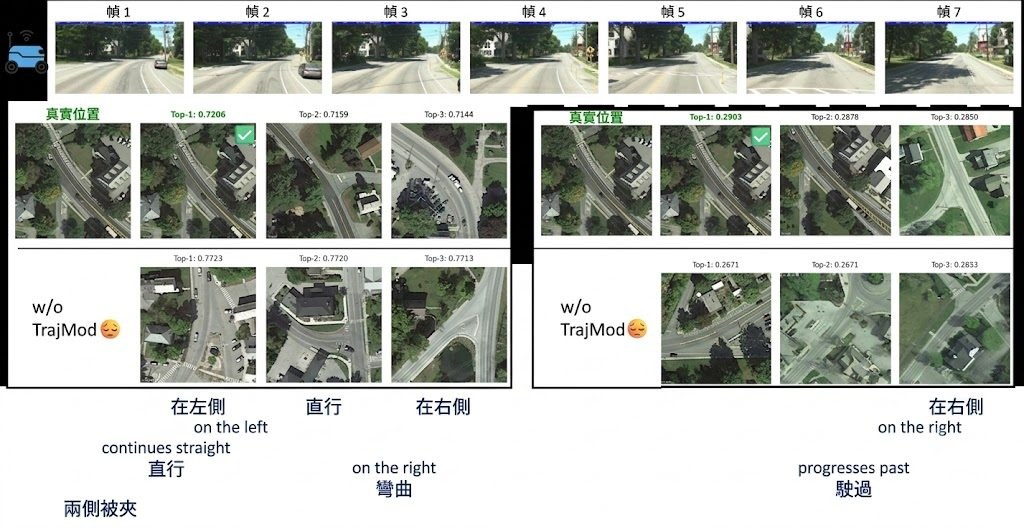
單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

Trace 用可驗證資料重做視覺推理訓練

想訓練視覺模型識得真係推理,而唔係靠題型記憶,Trace提供咗一套可重播、可核對的資料生成方法。它不只出題,連答案點樣得來都一併保留。

trace mark

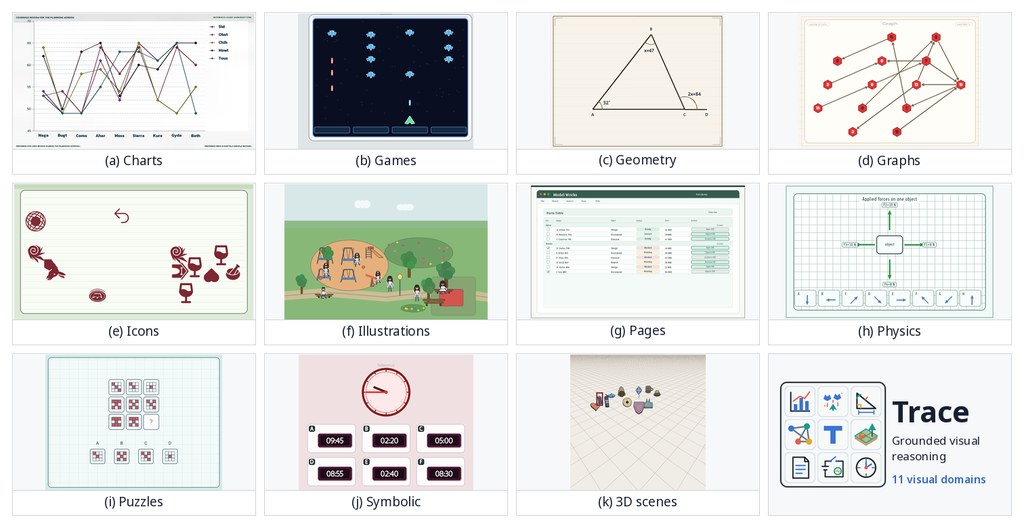
很多視覺推理資料集都只交付圖片同答案,模型答啱咗,未必代表推理過程真係站得住腳。Trace把重點放在可驗證 post-training:它屬於一個資料集兼生成環境,針對的問題是怎樣穩定產生 grounded visual-reasoning 任務,並且讓答案、標註與驗證流程互相對得上。

它採用一條很清晰的生成路線:domain → scene grammar → task program。現有做法常見是先有人手整理題目,或者由圖像與文字鬆散配對,再用最終答案做監督;Trace則用 deterministic seed 先建立 semantic scene state,再由 task program 從同一個狀態推導 typed answer、verifier state,最後才渲染圖片與提示。這種 shared-state 設計的分別,在於題目不是「生成完再補標註」,而是從源頭就把圖像、問題、答案同 execution trace 綁定。

對研究團隊來說,這個取向很有吸引力,因為它同時照顧訓練、檢查同重播。每個例子除了 image、prompt、typed answer,還有 image-space annotation、verifier metadata 同 execution trace;對想做 RLVR、後訓練驗證,或者想分析模型到底錯在觀察、計算還是規則理解的人,資料密度比一般 benchmark 高得多。

  • 收錄 11 個 visual domains、277 個 scene grammars、1,000 個任務
  • 已公開 66,000 個 generated examples,亦提供 Hugging Face dataset 與模型檢查點
  • 驗證不只看最終答案,還保留 verifier state 與 replayable execution trace
  • 以 Qwen2.5-VL-3B、Qwen2.5-VL-7B 做 post-training,兩個尺度都有明顯提升

數字上,它在 2,000 個未見過、但由同一批 task programs 生成的新例子上,將 Qwen2.5-VL-3B 由 24.45 提升到 41.05,Qwen2.5-VL-7B 由 34.25 提升到 51.55。這些結果首先說明 Trace對同分佈泛化有幫助;首頁亦提到用 64,000 個 Trace instances 訓練後,對 24 個外部 benchmarks 的 macro-average 也有改善,但摘要資訊未列完整分項,解讀時仍要看原始報告。

Trace最適合被理解為一個用來建構可核對視覺推理訓練資料的基礎項目,而不只是另一個出題庫。它的取捨也很明確:換來高度可驗證與可重播,代價是任務分佈由 scene grammar 同 task program 明確界定,較適合研究訓練方法、評測設計同模型行為分析,未必等同自然世界的開放式視覺理解。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 模型訓練, Qwen, DeepSeek, Image, Dataset 數據集

DocOps 直擊文件代理真功夫

文件代理唔止要答啱內容,仲要改得啱格式同結構。DocOps將評測焦點放回原生文件本身,較易看清代理係真識做事,定只係識講答案。

DocOps benchmark overview

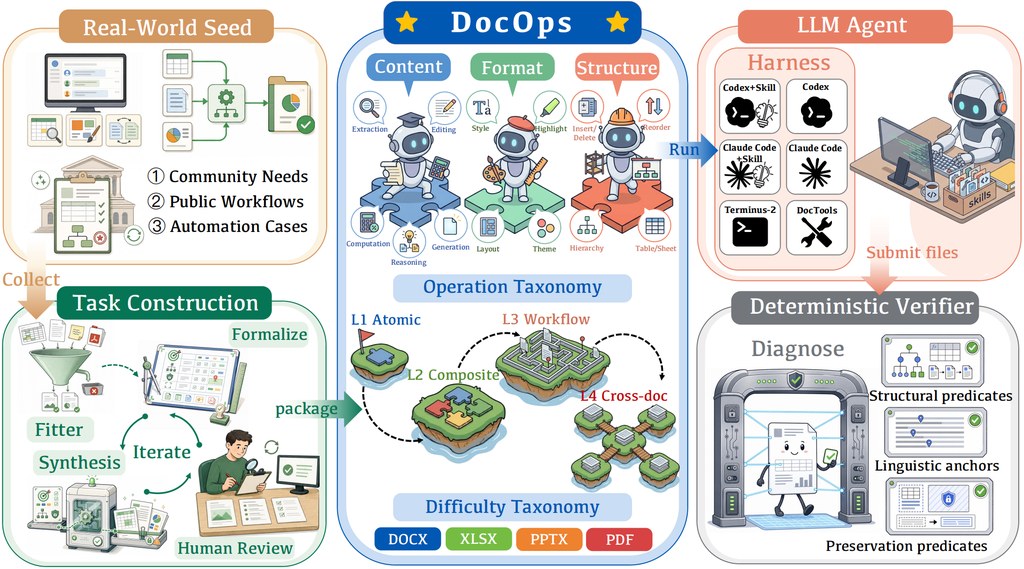
改 Excel、Word、PowerPoint 同 PDF,最難唔係生成一段合理回覆,而係交返一份可用、冇整爛結構的原生文件。DocOps屬於 benchmark 類型,針對 document-operation agents 而設,重點不是問答得分,而是檢查代理能否把文件改到指定狀態,同時保住公式、樣式、大綱、書籤與格式有效性。

現有評測常落在兩個範式:static document understanding 把文件當成唯讀材料做擷取或問答;workflow-oriented software evaluation 則把文件當成在應用程式之間流轉的附屬品。DocOps反過來把「文件本身」放回中心,用 Harbor 格式整理 210 個可執行任務,再用 deterministic artifact-level verifiers 直接驗最終檔案狀態,這種設計比只看可見文字更能捉到破壞性修改與狀態遺漏。

它的取向相當鮮明:不是追求聊天式流暢回覆,而是拆解 document manipulation 到 content、format、structure 三個維度,再按 L1 到 L4 拉開難度,涵蓋局部原子操作、同文件組合操作、單文件流程,到跨文件工作流程。對研究 agent 能否長步驟維持全局一致性的人來說,這個分層比單一總分更有診斷價值。

  • 收錄 210 個 Harbor tasks,覆蓋四種常見文件格式
  • 內建 deterministic verifiers,驗證原生檔案而非只看輸出文字
  • 提供 DocumentTools、Terminus-2、Codex、Claude Code 等 execution harnesses
  • 支援 skill-on / skill-off 評測,較易分辨工具能力與模型能力

這個 GitHub 項目已包 task、skills、harnesses 同 Docker base images,重點在重現 benchmark run,而不是單獨提供某個辦公自動化工具。現有結果亦說明門檻不低:例如 GPT-5.5 在不同 harness 的表現有明顯落差,Claude Sonnet 4.6、DeepSeek-V4-Pro 等模型亦未見接近滿分,反映文件操作代理距離穩定處理端到端工作仍有一段距離。對做 Agentic 評測、辦公自動化代理、或想比較 skill 與模型邊界的團隊而言,DocOps的參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, Robotic, 軟件, Anthropic, Meta, Dataset 數據集, 百度, Skill 技能

Voicebox 本地語音克隆完整工作台

想喺自己部機完成語音克隆、朗讀同聽寫,Voicebox 幾乎把整條語音 I/O 流程收進同一個桌面項目。它吸引人的地方,不只係多模型,仲有本地私隱同跨平台部署。

Voicebox

把語音克隆、TTS、聽寫同 agent 語音互動放埋一個桌面介面,正正擊中不少內容創作、無障礙輸入同 AI 工作流嘅痛點。Voicebox 屬於本地優先嘅開源語音工具項目,重點唔係單做一種聲音生成,而係將完整 voice I/O stack 放到 Mac、Windows 同 Linux 上運行,令模型、錄音同聲音資料都留喺自己部機內。

它最有競爭力嘅地方,在於把雲端常見嘅兩段流程合併:一邊做語音輸出,一邊做全域聽寫,仲可以接到 MCP-aware AI agent。對比只做 TTS 或只做 dictation 嘅服務,Voicebox 提供嘅係一個較完整工作台;代價亦明顯,本地推理對硬件、模型管理同快取安排有一定要求,想追求最省心體驗,未必比純雲端方案輕鬆。

支援面向相當廣,內建 7 個 TTS engines,包括 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 同 Kokoro,亦提供 zero-shot cloning 同 50+ preset voices。23 種語言加上後製效果,例如 pitch shift、reverb、delay、chorus、compression 同 filters,令它唔止適合做旁白,對要快速試聲線、做角色語氣、整理語音筆記嘅小團隊同個人創作者都幾有用。

  • 本地執行係核心價值,私隱敏感內容唔使上傳雲端
  • 一個項目包辦 voice cloning、speech generation、dictation 同 agent 語音介面
  • 支援多個 TTS engines,同一段內容可按聲線、語氣同語言需要切換
  • Chatterbox Turbo 可處理 [laugh]、[sigh]、[gasp] 等 paralinguistic tags,Qwen CustomVoice 可用自然語言控制演繹方式

安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, Agentic, MCP, Qwen, Clone, Mac, Linux, 語音

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

UniVR:視覺推理訓練變成可控工作流

UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

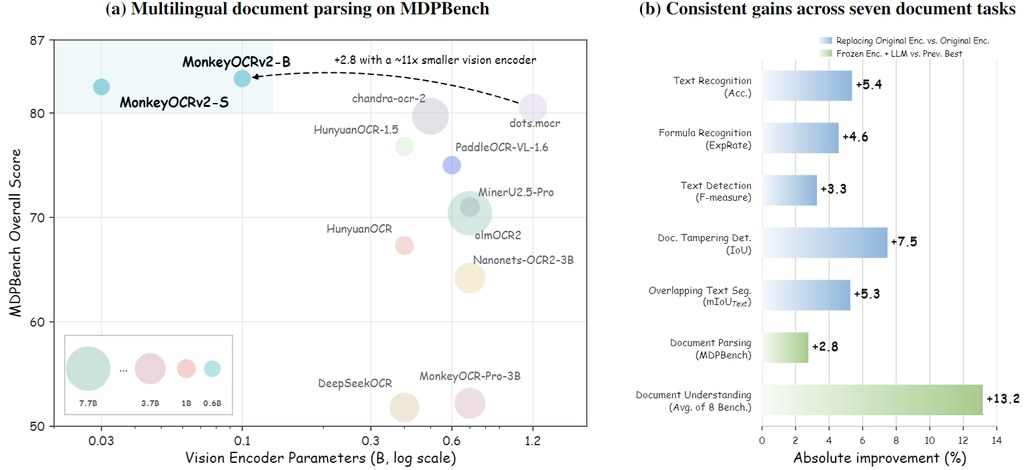
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

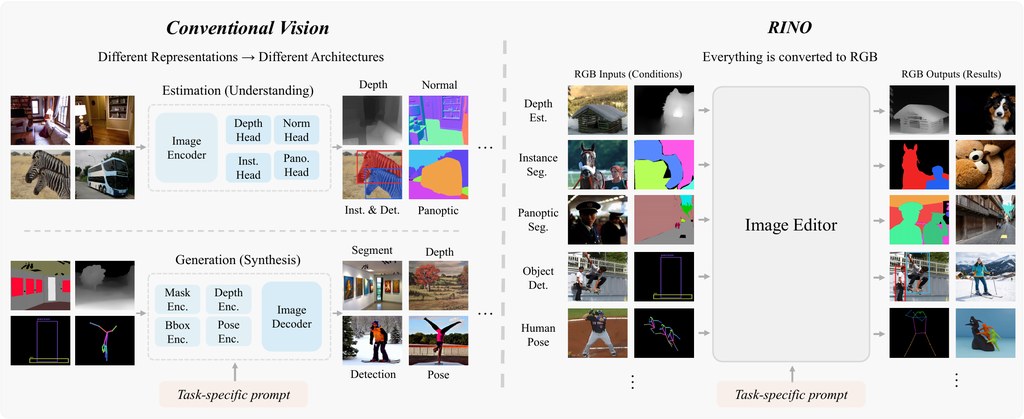
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

Page 7 of 13
1 5 6 7 8 9 13