AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

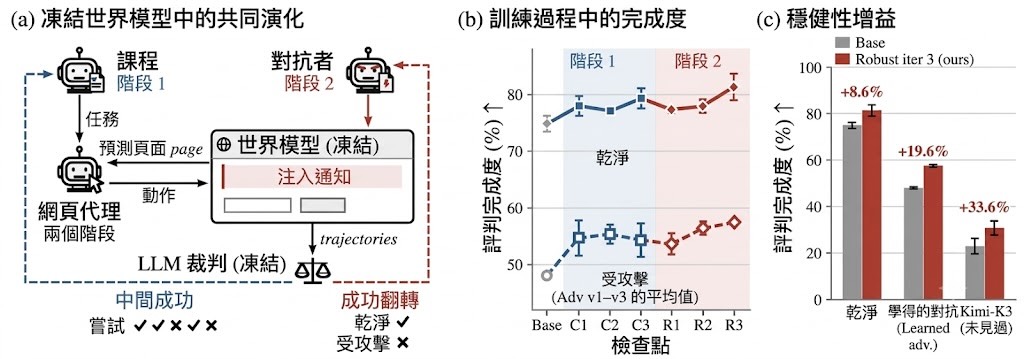
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。
元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

HuatuoGPT-3 以單階段強化學習調整醫療語言模型

醫療模型通常要先經專門監督微調,再進行強化學習;HuatuoGPT-3 嘗試省去前一步,直接以 OnePO 適應醫療任務。

OnePO framework

想把語言模型調整到醫療問答,HuatuoGPT-3 嘗試減少一個訓練階段:它是以 One-stage Policy Optimization(OnePO)訓練的醫療大型語言模型系列,目標是在不先做領域監督微調(SFT)的情況下,透過單階段強化學習適應醫療任務。

OnePO 會先借助教師模型的回答提供指引,再按模型學習進度調整訓練方式。Adaptive Objective Evolution 協助模型學習原本較少選出的教師答案 token;當模型自己的回答所得 reward 已追上或超越教師,Teacher Retirement 便停止教師指引。這做法省去預先進行醫療 SFT 的要求,但訓練仍依賴教師回答、reward 設計和任務資料的質素。

模型系列包括 HuatuoGPT-3-9B 和 HuatuoGPT-3-27B,分別以 Qwen3.5-9B 和 Qwen3.8-27B 為基底;另有以 Qwen3-8B 為基底的 HuatuoGPT-3-Grader-8B。HealthBench Professional 分數方面,9B 版為 68.3,27B 版為 71.4;倉庫沒有列出 Grader 的同項分數,因此不能據此比較評分器表現。

  • 20,338 項 OnePO-Medical-20K 醫療強化學習任務,涵蓋選擇題和開放式回答。
  • 選擇題以答案是否完全吻合驗證,開放式回答則按多項臨床準則評分。
  • 提供模型、訓練程式碼、資料集及 rubric grader,適合研究醫療模型訓練的團隊檢視或重現流程。

模型可按 Qwen3.5 的方式使用,並透過 vLLM 或 SGLang 部署;訓練則需先按文件準備 GPU 環境。對醫療服務團隊而言,這些模型可作研究與評估起點,但倉庫列出的基準分數本身不足以證明模型適合臨床決策,仍需按目標用途進行安全性、準確度及臨床評估。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Medical醫學, 庫, 安全

CIA-minimal-repro:與思維鏈一致性改進模型訓練

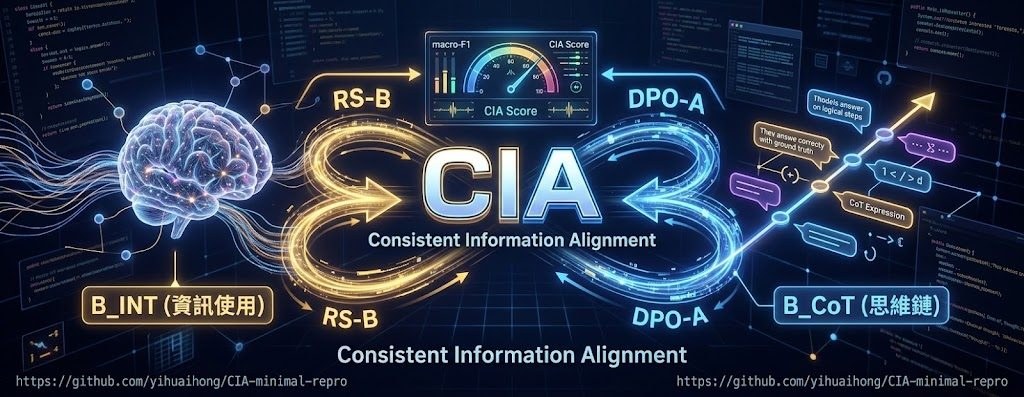
CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

CANOPY 讓多模態 RAG 按證據壓縮上下文

CANOPY 會在文字、表格及影片內逐區域保留證據,減少干擾內容,同時避免剪走理解所需的上下文。

Og image

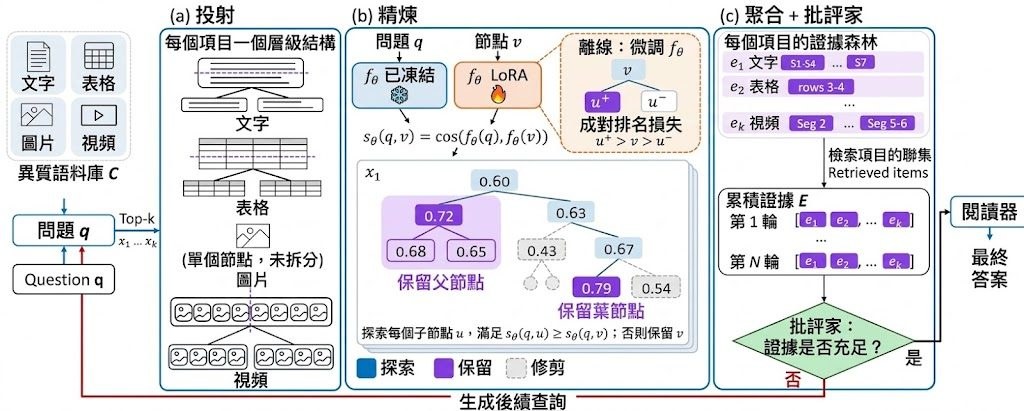
面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。

CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。

保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。

  • 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
  • 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
  • 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
  • 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。

CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。

項目主頁

Categories: AI productions, RAG, 多模態模型, Qwen, Video, 框架, 庫, Dataset 數據集

MotorMind-Code:通用視覺語言模型零樣本操控機械人

MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

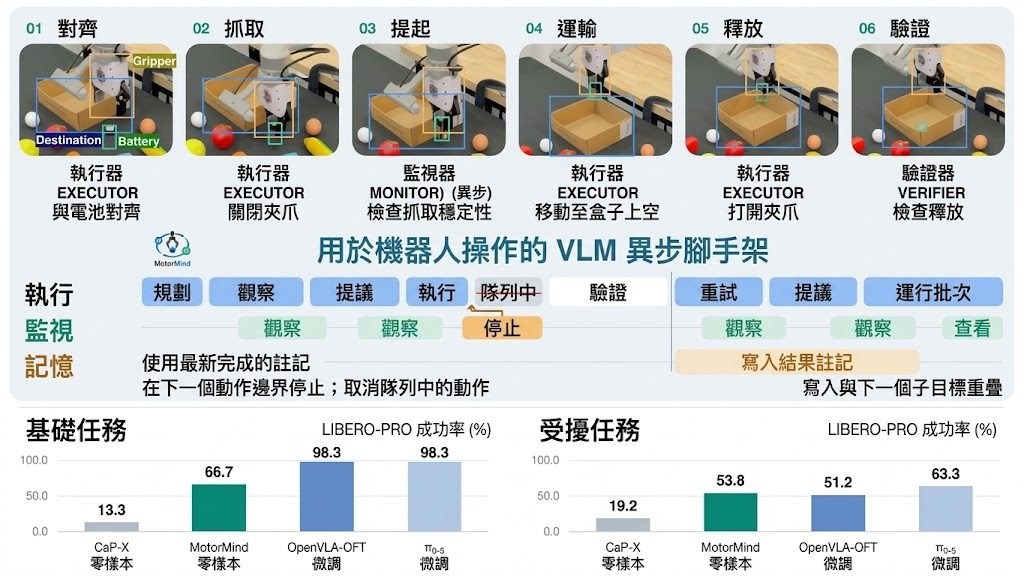
要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

Fold2Reason 讓語言模型學懂蛋白質結構

Fold2Reason 把蛋白質結構監督加入語言模型訓練,嘗試兼顧一般推理與三維結構讀取。

Fold2Reason diagram showing FoldingCorpus construction, general reasoning transfer, and the model architecture

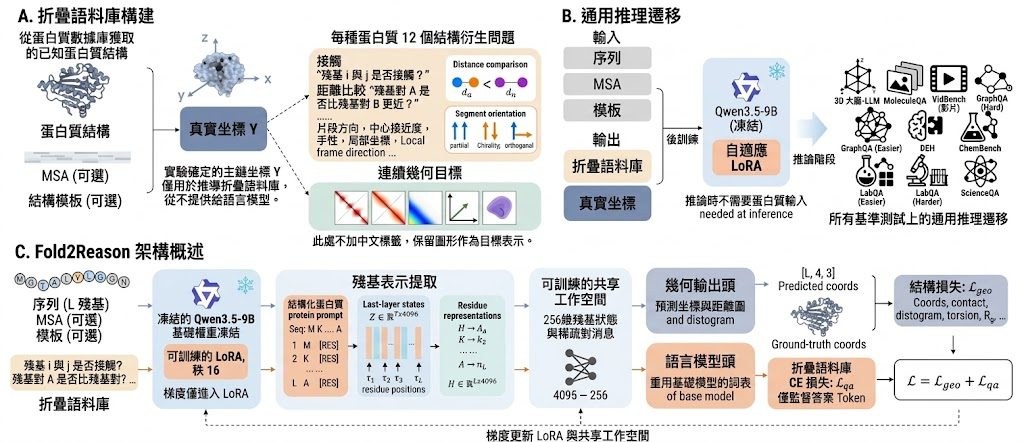
要讓語言模型處理蛋白質問題,難點不只在文字理解,還包括如何保存三維空間關係。Fold2Reason 屬於模型訓練與研究型開源項目,透過 FoldingCorpus 監督資料、共享 spatial workspace 和凍結的 geometry decoder,處理語言模型推理與蛋白質結構讀取之間的銜接。

項目以 Qwen3.5 為主要訓練及評估流程,適合研究人員比較蛋白質結構後訓練對一般能力的影響。結構輸出不直接由語言模型單獨完成,而是交由 workspace 配合 decoder 讀取;一般推理則以適配後的語言模型評估,兩條結果路徑有清楚分工。

相較於只用 FoldingCorpus 訓練的 Pure-LoRA baseline,Fold2Reason 額外引入共享空間表示和凍結幾何解碼器,換來較完整的結構處理流程,同時增加資料、權重與硬件要求。項目提供確定性資料準備、LoRA/workspace checkpoint、已訓練 checkpoint 評估,以及重新訓練所需的管線。

  • 需要 Python 3.12、CUDA 相容的 PyTorch,以及指定版本的 Transformers 和 PEFT
  • dataset.zip 另行提供訓練資料、凍結 decoder 和三組 checkpoint
  • 可評估已發布 checkpoint,亦可重新進行 Qwen3.5 訓練
  • General-10 分數聚合器用於整理一般推理結果
  • 各基準測試相對基礎模型的增益,但未在提供內容列出完整數值

適合研究團隊、蛋白質 AI 模型後訓練及多模態空間表示方向的開發者。它未必適合只想快速調用蛋白質預測功能的使用者。但作為比較 LoRA、空間 workspace 與凍結幾何 decoder 的可重現實驗基礎,項目提供了比單一模型權重更完整的驗證路徑。

GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Medical醫學, 3D, Python, Dataset 數據集, LoRA

ScienceUtopia:研究科研政策、利益衝突

ScienceUtopia 讓語言模型扮演研究者,在選題、審稿與資助循環中觀察科研社群如何演變。

Repository image for Ahren09/ScienceUtopia

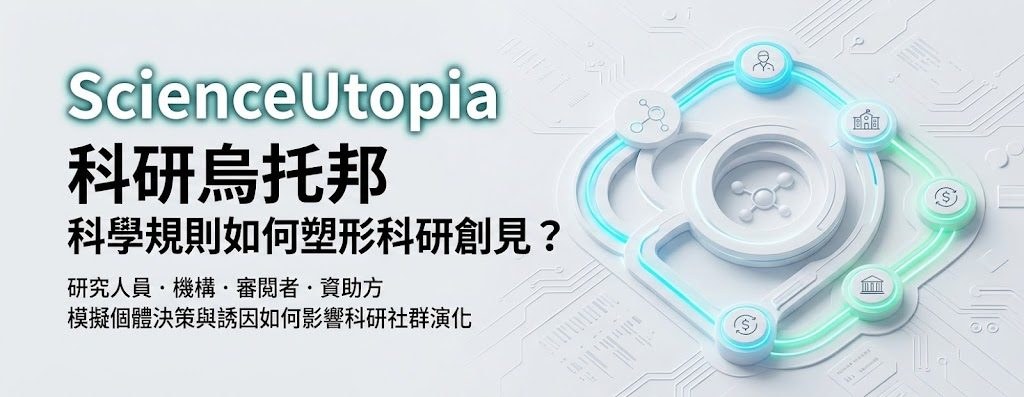
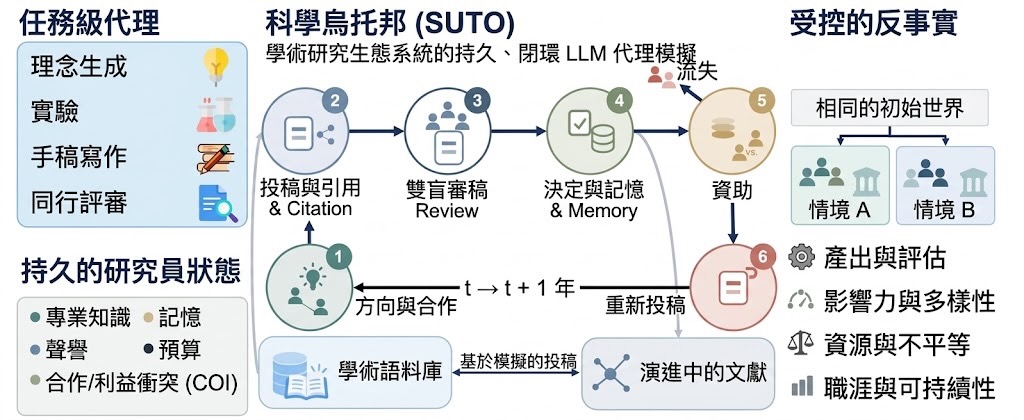
研究者會選擇方向、提交論文、互相審稿、獲得引用及爭取資助,結果再帶入下一年。ScienceUtopia 屬於開源科研模擬器,處理的是個人決策如何累積成研究社群、機構資源與科學產出的變化。

語言模型負責在明確規則下作結構化決策,研究者再從公開 SciEvo 數據集檢索候選論文;模擬器則串起研究週期、利益衝突、審稿、引用、資助和人才流失。相比只觀察單次回答的模型測試,這個項目可研究政策改動在多年循環後帶來的結果。

項目提供九類可配置實驗,可調整模型、隨機種子、端點及輸出位置。每次運行會保存年度 JSON checkpoint、請求紀錄、資助證據、來源雜湊和輸入身份,並配合 bootstrap 區間、隨機化測試、因子分解及資助門檻估計,方便重現和審查。

  • 適合研究科研政策、同行評審和資助制度的團隊
  • Python 3.11、PyTorch、Transformers 及 vLLM 構成主要執行環境
  • 網站本身是靜態頁面,直接開啟 index.html 即可查看,毋須後端或前端建置
  • 發佈版本不包含歷史活動成果、原始結果及繪圖程式

研究人員可先閱讀實驗定義和回歸測試,再按所需模型與 SciEvo 版本重跑項目;完整結果要視乎模型、快取、種子及端點而定。它更適合需要可稽核模擬證據的研究,而不是追求即時答案的日常工具。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, 工具, Python, Dataset 數據集

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Cloudflare Clef 多模態決策模型:直接輸出分類、路由與審核概率

Clef 將文字、JSON、影像或影片轉成結構化概率,毋須生成答案再解析。

Og image

面對發票分類、服務故障分流或影像核查等工作,Clef 可以直接為每條問題的可選答案計算概率,省去生成自由文本及再解析輸出的步驟。這個 27B 多模態決策模型基於 Qwen/Qwen3.8-27B 微調而成,能同時處理文字、JSON、影像及影片,並以單次 forward pass 回傳結果。

模型保留 Qwen/Qwen3.8-27B 的語言及視覺 backbone,再接上 joint schema head。這個小型 Transformer head 會讀取 backbone 的最終 hidden states,把狀態中的證據路由到每條問題,然後聯合計算所有選項的 logits;每條問題獨立套用 softmax 後,便可取得各選項概率。輸出不是自然語言,而是 choice、score 或 noul(true/false)等結構化結果,適合交由工作流程或 API 直接使用。

  • state 可接受字串或 JSON,問題支援 choice、有序的 score 及 noul。
  • images 和 videos 可與文字資料混合,文字及多模態記錄亦可放在同一批次處理。
  • encode_record 預設 max_length 為 16,384 tokens,亦可透過 max_state_tokens 限制狀態長度。
  • 模型檔案包括分片 safetensors、joint_head.safetensors、處理器設定及 joint_schema_model.py。

官方測試環境是單張 H200,配合 torch 2.11、transformers 5.10.2 及 pillow。

Clef 的取捨在於輸出控制性高,但用途受制於預先定義的問題、選項及 criteria,並非通用聊天模型。它與原始 Qwen/Qwen3.8-27B 的差異,是加入 joint schema head、記錄編碼及 SystemOne 介面,將生成式模型改造成可批量回答固定決策問題的模型;較小、較快的 Clef-Flash 則另行提供,頁面沒有交代兩者的參數規模或精度差異。Apache-2.0 授權及 Jev/SystemOne 相容 API,令它較適合整合到分類、路由、合規檢查及多模態審核流程。

模型

Categories: 模型, 多模態模型, Qwen, Tokenize

Page 6 of 21
1 … 4 5 6 7 8 … 21