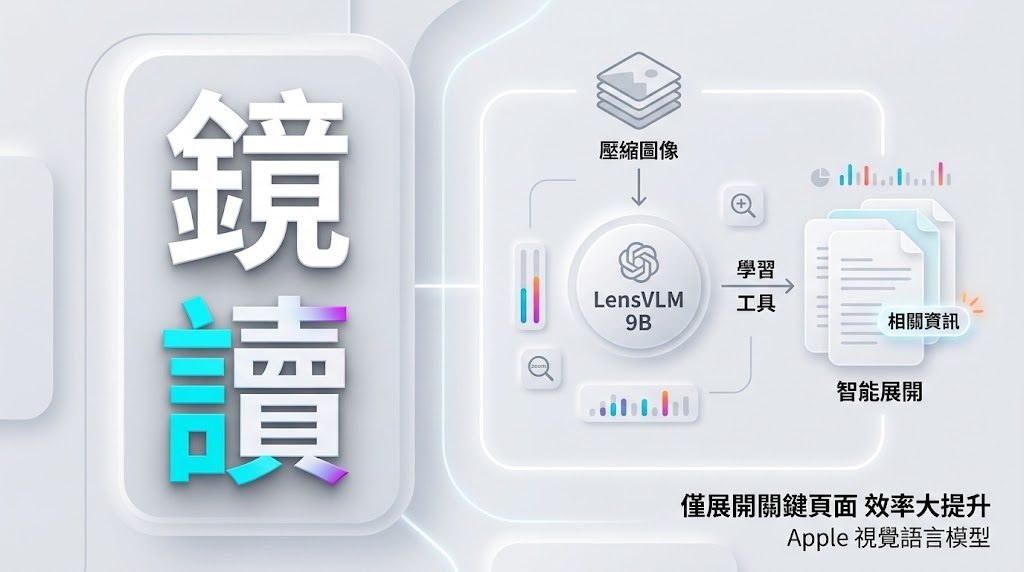
面對多頁文件問答,LensVLM不必一開始把每頁完整內容送入模型,而是先以壓縮頁面圖定位線索,再讀取相關頁面的全文。這個項目屬於多模態 Vision Language Model(VLM),實際處理的是長文件輸入過大、文字內容難以一次放入上下文的問題。
LensVLM是經微調的 Qwen3.5-9B,配合學習得到的 read_page 工具,讓模型在掃描頁面縮圖後按需擴展內容。示範包括模型檢查15頁文件,只讀取第10頁,經兩輪互動便由人物資料連結到答案;壓縮比例可選5x、10x或15x,取捨是壓縮越高,初步掃描成本較低,但頁面細節亦可能減少。
- 先處理壓縮頁面圖,再按問題讀取完整頁面
- 支援自訂文字文件及 HuggingFace 評估數據準備
- 輸出頁面圖與結果檔案,方便檢查推理軌跡
- 適合長報告、資料集問答及文件檢索測試
項目提供 requirements 安裝方式、示範流程及自訂文件參數,結果會寫入指定輸出目錄;原始資料沒有交代硬件要求、推理速度或記憶體消耗。提供的示例能說明工作流程,但未有完整準確率、延遲或與其他長文件 VLM 的量化比較,因此較適合作為研究原型和評估基礎,而非已證實在所有文件類型上都更快或更準的方案。
需要處理大量頁面、又希望控制視覺 token 成本的研究者和工程團隊,較容易從這種按需展開機制受益。文件版面複雜、關鍵答案分散,或問題需要跨頁整合時,仍要留意壓縮圖能否保留足夠線索,以及 read_page 讀取到的文字是否完整。