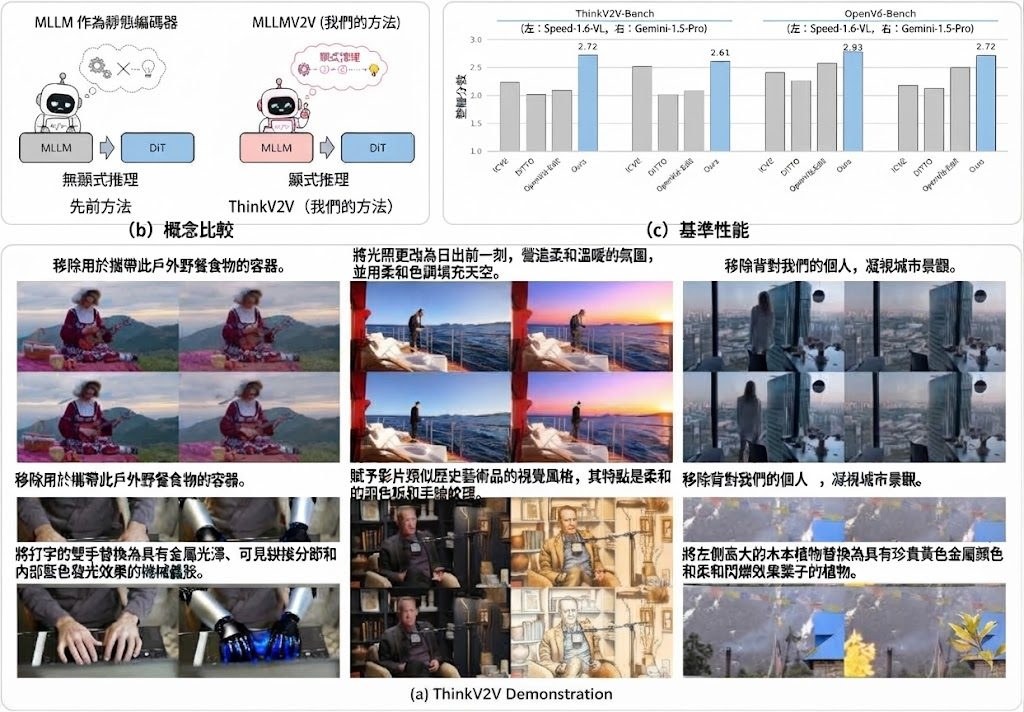
面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。
MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。
- 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
- 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
- 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
- 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。
項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。