Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

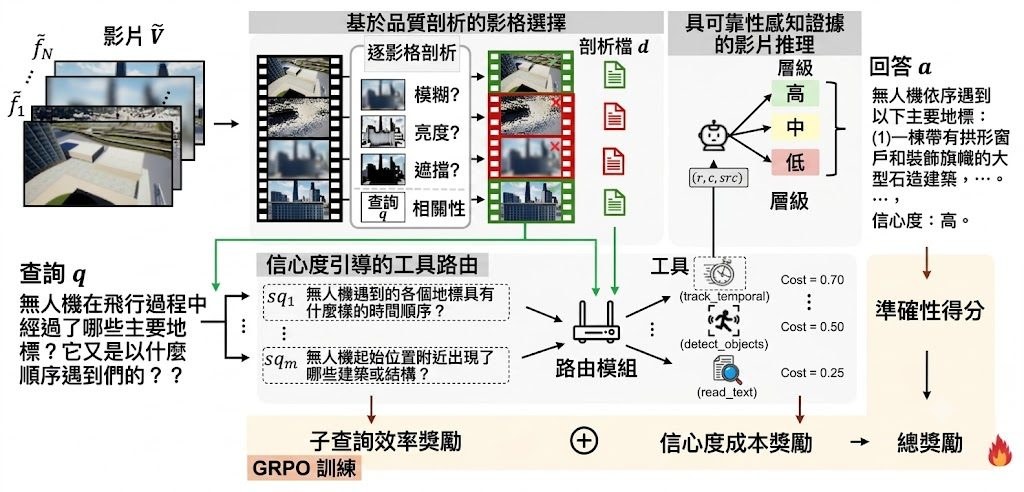
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

ViQ 想把影像變成更懂語意的離散碼

ViQ 是把影像量化成離散表示的研究框架,目標是在語意理解與細節保留之間取得平衡。它也支援任意解析度輸入,對多模態訓練效率有明顯吸引力。

hunyuan logo

ViQ 是一個視覺量化表示研究框架,也是把影像轉成離散 codes 的模型方法。它要解決的問題,是讓圖片像文字 token 一樣可交給多模態大模型處理,同時盡量不要在量化過程丟失太多語意與畫面細節。

現有做法常見兩條路:一類偏重重建,還原畫面能力較好,但語意資訊不足;另一類依賴 contrastive vision-language learning 的連續特徵,語意較強,卻不容易直接變成高品質離散表示。ViQ 的切入點是先做 Text-Aligned Pre-training,再做量化學習,把「先對齊語言語意、後逐步離散化」拆成清楚兩段。

它的核心設計有幾個辨識度很高的部件:以 pretrained language model 監督視覺編碼器、用 resized positional embedding 與 native patchify 支援 any-resolution input、再用 Proximal Representation Learning 配合 L∞-norm 約束,把特徵逐步推近量化錨點,最後交給 position-aware、head-wise FSQ(Finite Scalar Quantization)處理。論文亦提到基座可接 SigLIP2 vision tower、Qwen2.5 backbone,並透過 LoRA 等輕量組件訓練量化部分,而不是全面微調整個系統。

  • 支援任意解析度輸入,不用被固定尺寸綁死
  • 目標不是只重建圖片,而是兼顧語意理解與細節
  • 多模態訓練可直接吃離散視覺 codes,論文稱效率可提升約 20% 至 70%
  • 已公開訓練與推論程式,並提供 HuggingFace 權重

從部署與測試角度看,這個 GitHub 儲存庫較適合當研究實作與模型驗證項目來理解:可先用已公開權重跑 inference,觀察影像如何被編成離散 codes,再進一步重現單階段訓練示例,之後才嘗試論文中的兩階段 recipe。較受惠的會是做 MLLM、視覺 tokenization、影像重建或訓練加速的團隊;限制則是概念與訓練流程都不算輕,重點較偏研究價值,未必是即裝即用的通用工具。

GitHub: https://github.com/yuxumin/ViQ

Paper: https://arxiv.org/pdf/2606.27313

Categories: 開源, 清華大學, 騰訊, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架

EventVLA:長時序機器人操作加入事件記憶機制

EventVLA 是一個視覺語言動作框架,透過事件驅動的關鍵幀記憶機制,讓機器人在長時序任務中能回溯早期視覺證據,提升操作準確度。

EventVLA Overview

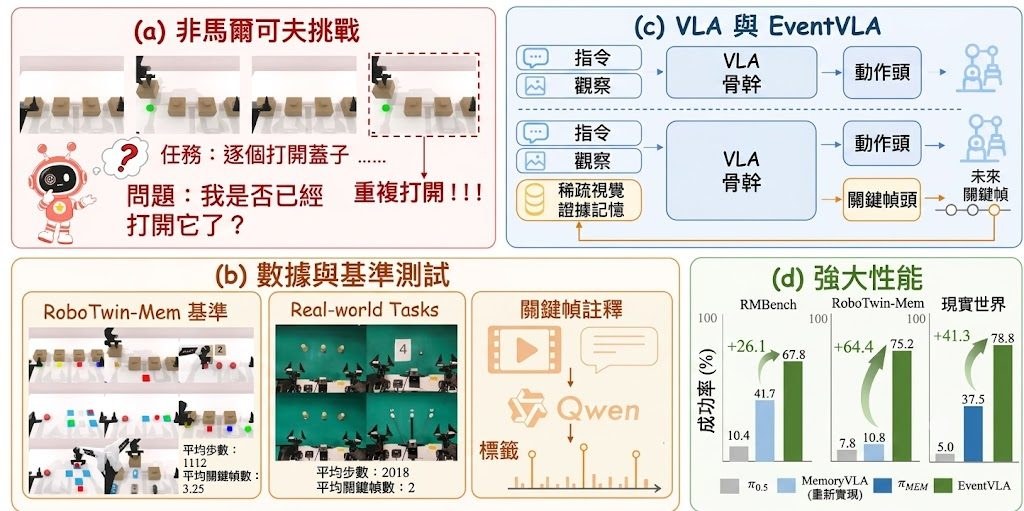
EventVLA 是一個由中國科學技術大學、上海人工智能實驗室、上海交通大學、大連理工大學、香港大學、清華大學、北京大學及華為等團隊共同開發的視覺語言動作(Vision-Language-Action, VLA)框架,專門針對長時序機器人操作任務設計。它解決的核心問題是:當機器人需要執行跨越許多步驟的任務時,往往必須回想起數十步之前出現過的視覺線索,而傳統 VLA 政策通常只依賴壓縮後的隱狀態,容易遺失早期關鍵畫面。EventVLA 的做法是引入事件驅動的視覺證據記憶(event-driven visual evidence memory),在執行過程中偵測與任務相關的事件,把對應的關鍵幀以原始影像形式存入記憶體,並在後續動作預測時重新取用這些畫面作為參考。

這個項目同時發佈了 RoboTwin-MeM 基準測試,這是建基於 RoboTwin 2.0 的記憶依賴型操作評測環境,包含八個需要長時序記憶的任務,例如依序拾取物件、按照紙上指示重複放下積木、依指示重現路線等。與同類 VLA 框架相比,EventVLA 的差異在於它不只壓縮隱狀態,而是保留原始關鍵幀影像作為可回溯的視覺證據,這在需要精確回憶早期空間配置的任務上特別有用。

部署與測試方式

  • 建議建立兩個 conda 環境:一個用於 RoboTwin-MeM 模擬,另一個用於 EventVLA 模型訓練與推論。
  • 從 Hugging Face 下載對應的 checkpoint(RoboTwin-MeM 或 RMBench 版本),搭配相應的評測腳本即可在模擬環境中重現結果。
  • 數據集同時提供 HDF5 軌跡格式與 LeRobot 2.1 訓練格式,方便不同訓練流程直接取用。
  • 目前程式碼已支援模擬訓練與評估,真實機器人推論與微調模型仍在開發中。

重點摘要

  • 核心機制:事件驅動的關鍵幀記憶,以原始影像儲存視覺證據而非僅壓縮隱狀態。
  • 配套基準:RoboTwin-MeM 包含八個長時序記憶依賴任務。
  • 目前狀態:模擬環境訓練與評估已開源,真實世界部署尚未釋出。
  • 適用場景:需要回溯早期視覺線索的多步驟機器人操作任務。

從已釋出的資源來看,研究人員與機器人團隊可直接透過 Hugging Face 上的 checkpoint 與 RoboTwin-MeM 數據集進行基準測試與模型微調,評估記憶機制對長時序任務表現的影響。

GitHub: https://github.com/InternRobotics/EventVLA

項目主頁: https://ganlin-yang.github.io/EventVLA.github.io/

模型: https://huggingface.co/ganlinyang/EventVLA/tree/main

Categories: 開源, 香港大學, 北京大學, 清華大學, 上海人工智慧實驗室, 華為, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, Qwen, Robotic, 框架, 香港, 深度學習, 中國

ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。
Repository image for DANG-ai/ReMMDBench-Agent

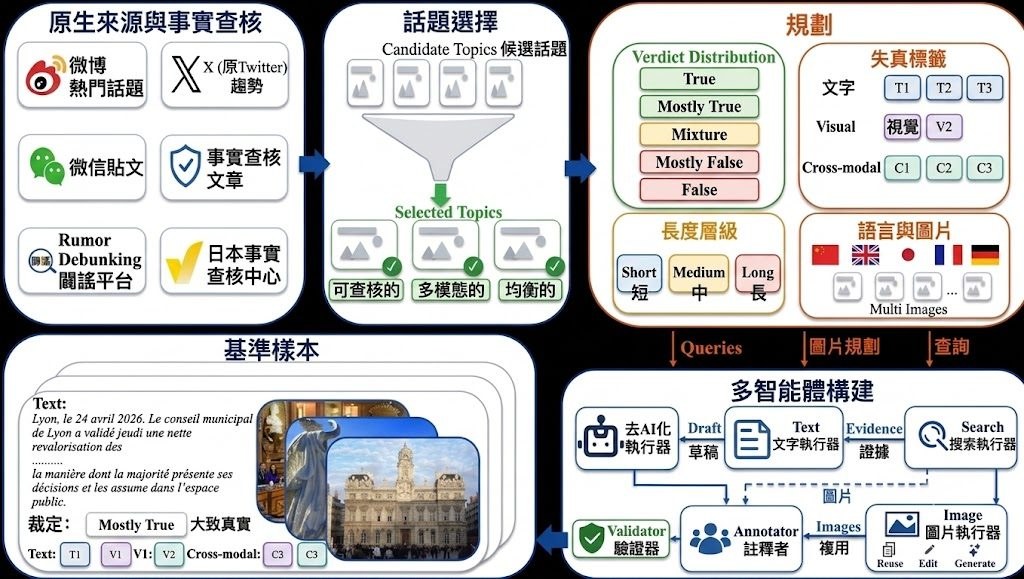
開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml 或 .env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/
Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, 庫, 安全, 深度學習, 中國

DREAM:用語言模型反向教檢索

DREAM 不是一般對比式檢索訓練,而是借用自回歸語言模型的預測誤差來教 retriever。它瞄準標註成本高、負樣本難挖的老問題。

DREAM banner

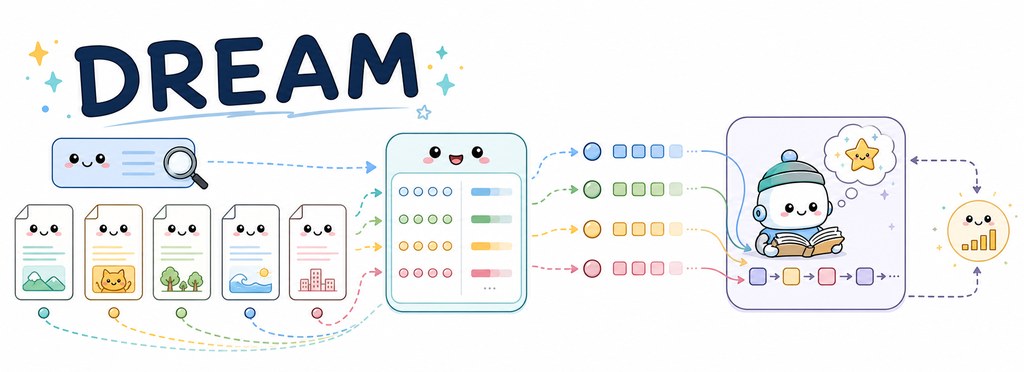
DREAM 是一個稠密檢索嵌入訓練方法/研究原型,核心是把 autoregressive language model 的預測訊號拿來訓練 dense retriever。它要解決的問題很明確:傳統 dense retrieval 多數依賴 contrastive objectives,需要正負文件配對與標註,但這類資料昂貴,hard negatives 也不穩定。

現有做法通常是替 query 配 positive documents 與 sampled negatives,再拉近或拉遠 embedding 距離;作者認為這種範式過度依賴人工或額外挖掘流程,未必真正反映哪些文件能幫助模型完成生成。DREAM 的做法是把 query-document 相似度送入指定的 Query-Focused Retrieval Heads(QRHeads),讓 frozen LLM 在預測 target 時,直接用 next-token prediction loss 回傳訊號,告訴 retriever 哪些文件真的有用。

這個取向最值得留意的地方,在於它不是單純改 loss,而是把檢索分數接進 attention heads,令生成模型的預測難度成為監督來源。代價也很明顯:流程比一般 embedding fine-tuning 更複雜,要先做 QRHead detection,再跑 DREAM adapter 訓練;儲存庫亦未附完整 training data、checkpoints 與 evaluation outputs,較接近研究復現路線,而不是即裝即用工具。

安裝與理解方式算清晰,儲存庫分成 qrhead_repo/、dream_routing/ 與 data/sample/ 三部分:前者負責找出 QRHeads,後者負責訓練 adapter,樣本資料則用 JSONL 提供 query、docs、target 結構。部署重點不是直接上線服務,而是先準備自己的 Hugging Face dataset 或本地 JSONL,依序完成 head 檢測與訓練;推論部分則主要依賴 Hugging Face 上已釋出的 adapters。

  • 已提供預訓練模型:DREAM-0.5B、DREAM-1B、DREAM-3B
  • 對應底座模型:Qwen2.5-0.5B、Llama-3.2-1B、Llama-3.2-3B
  • 評測指向 BEIR 與 RTEB,論文稱在不同模型尺寸上都優於既有 baselines
  • 適合研究檢索訓練、RAG、embedding 設計與 LLM-retriever 協同優化的團隊

受益最大的一類人,不是只想下載 embedding 即用的使用者,而是要研究 retriever 如何配合生成模型工作的團隊。對做 RAG、知識檢索、代理式搜尋的人來說,DREAM 提供了一條不同於 contrastive training 的路;對資源有限的小團隊而言,訓練鏈較長、重現門檻較高,較適合作為方法參考或實驗基線,而非現成產品元件。

GitHub: https://github.com/yixuantt/DREAM

Model: https://huggingface.co/collections/yixuantt/dream

Categories: 開源, 香港科技大學, RAG, Embedding, 模型, 模型訓練, Qwen, 香港, 工具, LLaMa, Python, 庫, Meta, Dataset 數據集

MobileForge:手機 GUI Agent 訓練新路線

MobileForge 想解決手機 GUI Agent 太依賴人工標註的老問題。它把真實 App 互動變成訓練資料與回饋流程。

MobileForge Logo

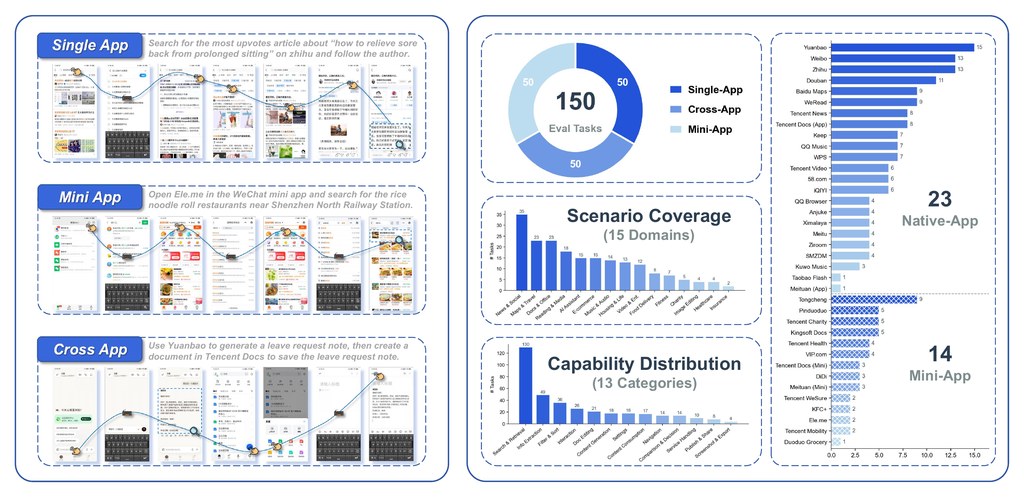
MobileForge 是一個用來調整 mobile GUI agents 的研究型訓練框架。它主要解決手機操作代理往往要靠人工寫任務、示範或獎勵標籤,成本高又難快速轉去新 App 的問題。

常用做法 human-written tasks、demonstrations 或 reward labels 去訓練,作者認為這種固定範式有兩個限制:生成的任務未必貼近目標 App,rollout 只得到稀疏成敗訊號,也很難轉成可重用的步驟級學習訊號。MobileForge 的處理方式是把目標 App 的真實互動交給 MobileGym,先做探索、抽取 executable curricula,再用 HiFPO 把 hints、hierarchical trajectory feedback 和 step-level GRPO training 串成一個不用任務標註的調整流程。

這個取向不是單靠更大模型硬推成績,而是重新整理資料來源與訓練單位:任務來自 target-app interaction,回饋不只看最後成功與否,還會拆成 outcome labels、process feedback 和 corrective hints。代價也很明顯,整個流程依賴真實 Android app 互動環境,部署與測試較像研究實驗管線,而不是裝好即用的消費級工具。

根據項目較合理的理解方式是:先取用作者釋出的 codebase、HuggingFace models、datasets 與 benchmark results,再在 Android 任務環境重跑 exploration、rollout、training、evaluation 幾個部分。它較適合做 mobile agent 研究、行動自動化、GUI policy optimization 的團隊,也適合想比較 annotation-free adaptation 與傳統人工標註流程差異的人。

  • 類型定位:研究型框架,核心是 annotation-free adaptation
  • 方法骨幹:MobileGym 負責探索與任務生成,HiFPO 負責回饋轉訓練訊號
  • 已公開模型:GUI-Owl-1.5-8B、Qwen3-VL-8B 的 MobileForge 版本
  • 結果重點:GUI-Owl-1.5-8B 在 AndroidWorld 達到 67.24% Pass@1、77.59% Pass@3;MobileWorld 為 41.03% SR
  • 取捨:減少人工標註依賴,但需要較完整的互動環境與實驗流程支持

MobileForge 同時展示 in-domain AndroidWorld adaptation 與 out-of-domain MobileWorld GUI-only generalization,表示它不只是在單一資料分佈內調參。對想建立可遷移手機代理能力的團隊來說,這個項目提供的價值不只是模型 checkpoint,還包括一套如何把真實 App 操作痕跡轉成訓練循環的具體方法。

GitHub: https://github.com/kwai/MobileForge

項目主頁: https://mobile-forge.github.io/

Model: https://huggingface.co/collections/lgy0404/mobileforge-models

Categories: 開源, 清華大學, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 工具, Dataset 數據集

Qwen-AgentWorld:用語言模型模擬七大代理環境的世界模型

Qwen-AgentWorld 是首個覆蓋 MCP、Search、Terminal、SWE 等七大領域的原生語言世界模型,透過三階段訓練管線與千萬級真實互動軌跡,為代理訓練提供可擴展、可控的環境模擬器。

logo

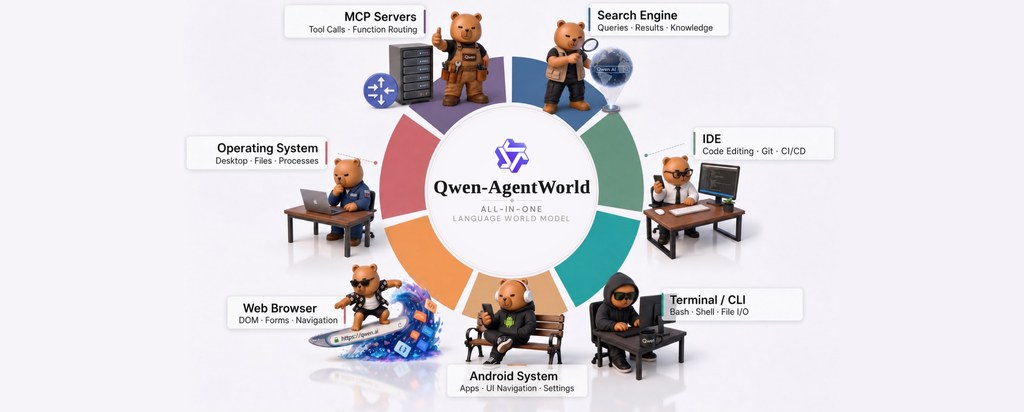
Qwen-AgentWorld 是阿里 Qwen 團隊開源的語言世界模型(Language World Model),屬於模型與訓練框架類項目,核心任務是透過長鏈思維推理模擬代理(agent)在七大領域的環境動態,並為代理強化學習提供可擴展、可控的模擬環境。

現有做法普遍把世界模型視為代理訓練完成後的「後加配件」(post-hoc add-on),僅在需要時才引入環境模擬能力,這種範式限制了模擬品質與遷移效果。Qwen-AgentWorld 的差異在於從 CPT 階段起就把環境建模作為訓練目標,透過 CPT 注入環境知識、SFT 啟動下一狀態預測推理、RL 以混合獎勵機制銳化模擬保真度,最終在超過 1000 萬條真實互動軌跡上完成訓練。

這個項目同時釋出 Qwen-AgentWorld-35B-A3B(MoE 架構,總參數 350 億、激活 30 億、256K 上下文)以及 AgentWorldBench 評測基準,後者涵蓋 Tool Decathlon、Terminal-Bench 1.0/2.0、OSWorld-Verified 等九個基準,從五個維度以真實標籤評分世界模型品質。團隊亦提出兩種互補應用範式:作為解耦的環境模擬器支援大規模代理 RL,或作為統一代理基礎模型,以世界模型預訓練作為下游代理任務的暖身步驟。

重點摘要:

  • 七大統一領域:MCP、Search、Terminal、SWE、Android、Web、OS,首次由單一語言模型覆蓋。
  • 原生世界模型:環境建模從 CPT 階段即為訓練目標,非後加適配。
  • 可泛化模擬器:支援零樣本遷移到分布外環境(如 Claw Agent),並允許可控擾動與虛構世界構建。
  • 代理基礎模型:單輪非代理軌跡上的 LWM RL 暖身,可遷移至多輪工具調用代理任務。
  • 開源權重與基準:模型權重與 AgentWorldBench 均於 Hugging Face 與 ModelScope 釋出。

部署方面,模型可透過 Hugging Face 模型 ID 直接下載,或在無法存取 HF Hub 的環境下透過 ModelScope 配合 SGLang、vLLM 等框架載入。對於需要大量代理 RL 訓練數據的團隊,這個項目提供了一條以模擬取代部分真實環境互動的路徑,有助降低成本並提升可控性。

GitHub: https://github.com/QwenLM/Qwen-AgentWorld

Paper: https://arxiv.org/pdf/2606.24597

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 世界模型, 模型訓練, Qwen, 框架, 深度學習

PhoneBuddy:訓練手機代理的雙路徑做法

PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。

PhoneBuddy logo

PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。

現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。

這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。

現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。

  • 核心差異:把 real-app RL 的真實性,與 mock-app RL 的可驗證擴展性結合
  • 已公開模型:PhoneBuddy-4B、PhoneBuddy-4B-RealApp、PhoneBuddy-0.8B
  • 公開成績:AndroidWorld 83.2%,平均比 real-app RL only 高 5.0
  • 主要限制:cross-app 表現偏低,資料集未公開,程式與評測文件仍未齊備
  • 較適合人群:研究 Computer-use agents(CUAs)/手機代理、做 agent training、benchmark 或安全與私隱分析的團隊

想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。

GitHub: https://github.com/PhoneBuddyAI/phonebuddy

項目主頁: https://phonebuddyai.github.io/

項目: https://huggingface.co/PhoneBuddyAI/PhoneBuddy-4B

Categories: 開源, 香港中文大學, 騰訊, Agentic, 模型, 模型訓練, Qwen, OpenAI, Gemini, 香港, 安全, 中國, Dataset 數據集

BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

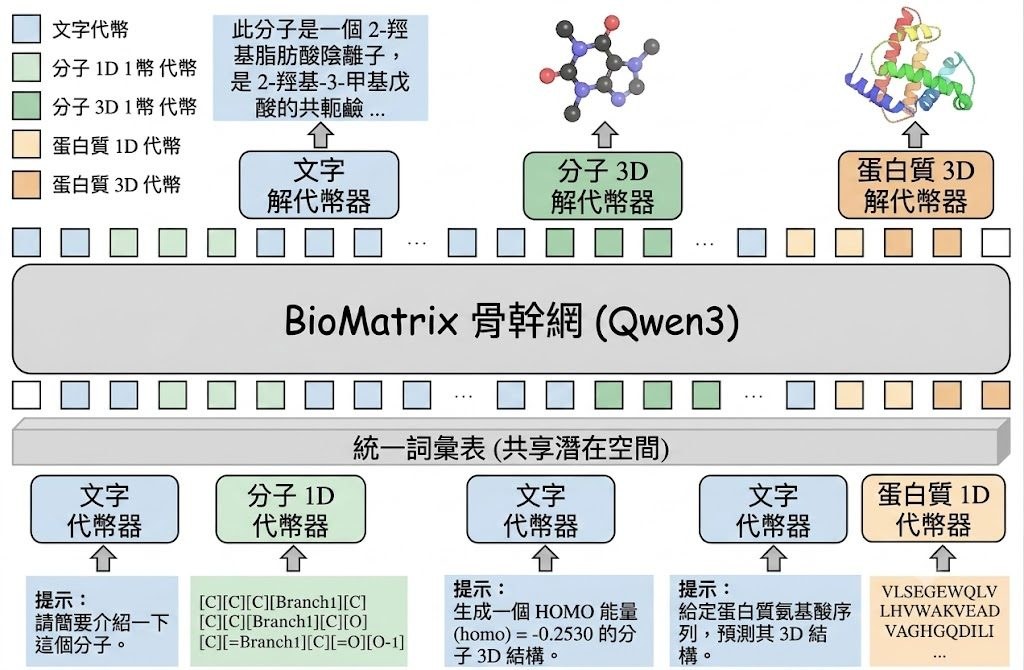
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix

項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

DataClaw0 想把雜亂多模態資料變成可訓練資產

DataClaw0 不是普通標註工具,而是把原始多模態資料主動整理成可用訓練資料的研究原型。它瞄準的是資料太亂、太長、太難重用的老問題。

DataClaw

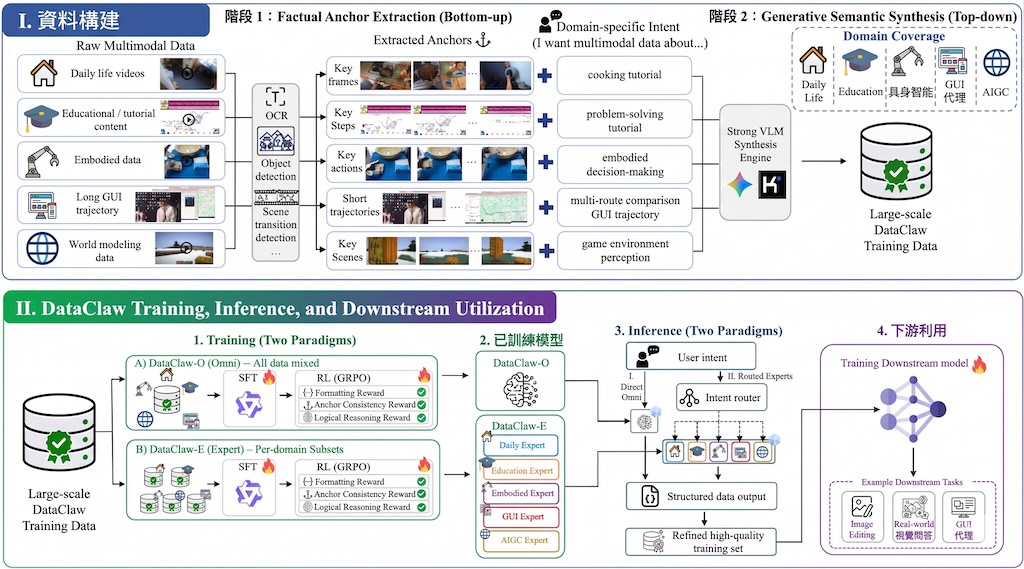
這是一個面向多模態資料整理的研究原型兼框架,核心是用 Agentic Data Tailoring 把原始串流資料重組成有結構、可驗證、可直接用於訓練的 supervision。它要解決的不是「再做一次標註」,而是長影片、GUI traces、embodied trajectories 與 editing sequences 太雜亂、資訊密度不均,令人和模型都難以有效吸收。

現有做法多數依賴 passive annotation paradigms,用 heuristic rules 或 general VLMs 被動加標籤;作者認為這類方式成本高、內容單調,亦抓不到原始資料入面的 procedural logic。DataClaw0 改用「Bottom-up Factual Anchors → Top-down Semantic Synthesis」兩段式流程,先抽取較確定的 factual anchors,再按意圖生成結構化語意,重點在於它不是只描述內容,而是按 downstream objective 重寫資料。

模型層面,項目提出 DataClaw-9B,並以 Supervised Fine-Tuning(SFT)加 rule-driven Group Relative Policy Optimization(GRPO)做對齊;部署上分成 unified Omni model 的 DataClaw-O,以及分領域 Experts 的 DataClaw-E。這種取向的取捨很明顯:Omni 較方便統一處理多域資料,Experts 則較可能在特定場景保留更細緻的領域表達。

現階段先看論文與案例再判斷是否值得追蹤,因為 code、model weights、dataset 和 DataClaw-val benchmark 仍未正式釋出。已公開資訊顯示,它的評測不只看生成是否通順,還會檢查 JSON validity,以及 schema-aware 的 Field、Semantic、Sequence 指標,並再用 video generation、real-world VQA、GUI navigation 的下游 post-training 效果驗證資料整理是否真的有用。

  • 項目類型:研究原型/資料整理框架,重點是把原始多模態串流轉成意圖對齊的訓練資料
  • 主要差異:不是被動標註,而是主動 refinement,並保留 schema-conformant、verifiable 輸出
  • 相關模型:DataClaw-9B、DataClaw-O、DataClaw-E,訓練結合 SFT 與 rule-driven GRPO
  • 適合情境:做多模態 post-training、GUI agents、VQA、影片或 embodied 資料整理的團隊

如果你關心的是建立資料引擎,而不只是找一個模型做推理,DataClaw0 比一般 VLM 標註流程更有方向性。限制也很直接:目前公開內容以論文與項目頁案例為主,能否重現效果、部署成本多高、不同領域泛化有多穩,仍要等正式釋出的資料與基準再作判斷。

GitHub: https://github.com/vancyland/DataClaw0

項目主頁: https://czjdsg.github.io/MakeAnyData/#cases

Paper: https://arxiv.org/pdf/2606.21337

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Qwen, Gemini, Video, 影像模型, 影像處理, 框架, 工具, IDE, Dataset 數據集

Page 19 of 21
1 … 17 18 19 20 21