PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

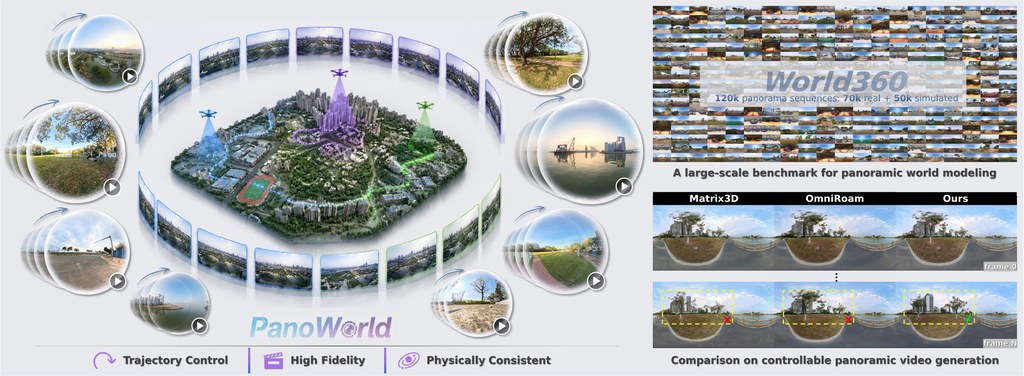
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC) 與 Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。
項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

GenCeption 單一模型多種視覺任務

同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

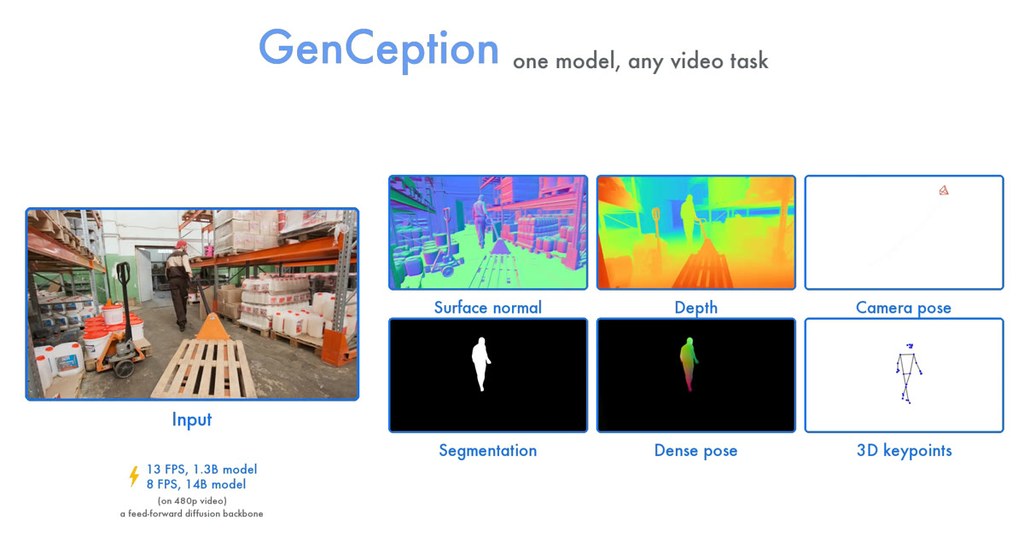
做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
– ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

Video-Oasis 想重做影片理解評測

不少影片 benchmark 分數看似漂亮,其實未必真係考到影片理解。Video-Oasis 把焦點放回評測本身,專門拆解捷徑題與真正需要時序證據的題目。

video native challenges

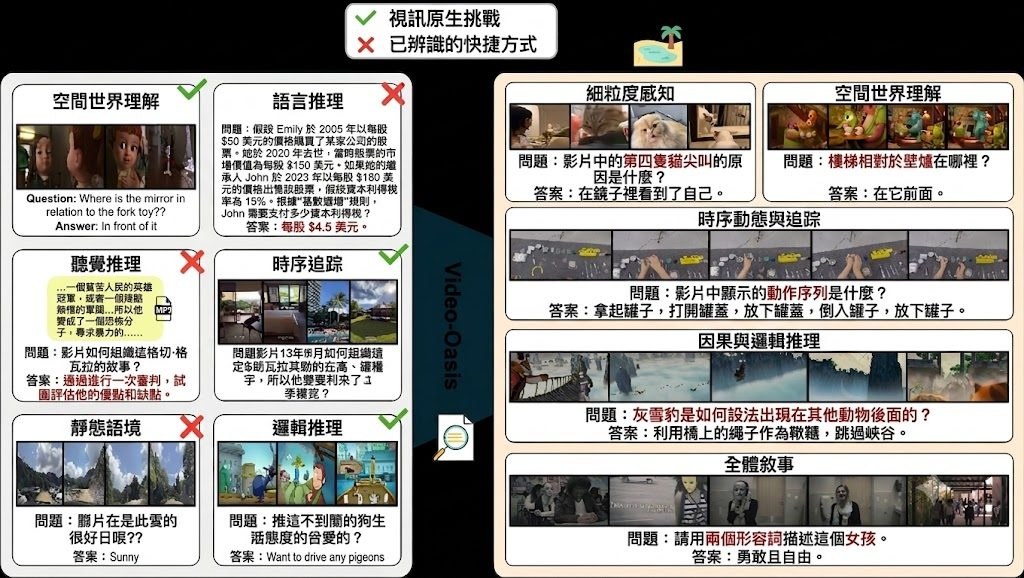
高分未必代表模型真係睇得懂影片,呢個項目正正針對呢個落差。Video-Oasis 屬於資料集與評測項目,重點不是再加一份題庫,而是重新檢查現有 video benchmark 到底有幾多題目真的需要 visual grounding 與 temporal reasoning,避免模型只靠文字線索、單幀畫面或靜態背景就答中。

普遍做法是把不同影片問答 benchmark 直接合併比較,作者認為這種固定範式忽略了「是否真係需要影片」這個前提。Video-Oasis 先整理 14 個 benchmark、24,416 個 QA samples,再用共享的 visual 與 temporal criteria 審視題目,結果指出約 55% 樣本可被 non-video shortcuts 解開,之後再萃取出 11,033 個較具代表性的 Video-Native 挑戰。

它和同類 benchmark 最大分別,在於不是追求覆蓋更多題型,而是先清理評測污染。官方資料提到五類 video-native challenges 才是核心難點,而現時模型在這部分表現仍然偏弱,最佳模型 Gemini-2.5 Pro 只有 46.7%,接近 chance 25.63% 之上不遠,說明這套評測更能拉開「答得中」與「真理解」之間的差距。

  • 涵蓋 14 個 benchmark,任務由 perception 延伸到 reasoning,片段長度由幾秒到數小時
  • 以 shared visual and temporal criteria 重新審核題目,不是單純拼接舊 benchmark
  • 約 55% QA samples 可用 non-video shortcuts 解答,真正 video-native 部分約佔 45%
  • 評測流程建基於 lmms-eval,並支援透過 huggingface_hub 下載模型
  • README 已提供資料下載、影片修復與目錄整理方式,但完整程式碼仍標示為 coming soon

部署理解上,它較像一個研究型 benchmark workflow:你要先準備 Python 3.12、CUDA-compatible GPUs、torch、vllm 0.11.0 與 transformers 4.57.0,再下載各 benchmark 影片、用 ffmpeg 腳本修復損毀檔案,之後透過內建 lmms-eval 跑 vqa_total 或 v_oasis 任務。現階段較適合做模型評測、研究比較,或者幫團隊檢查自家 video model 是否只是在 benchmark 上「識考試」,未必適合作為即裝即用的應用工具。

項目預設支援可由 huggingface_hub 下載的模型,示例提到 Eagle2.5-8B;成績說明中則點名 Gemini-2.5 Pro 為目前最佳表現者。整體來看,Video-Oasis 最有價值的地方不是再造一個排行榜,而是把影片理解評測裡最容易被忽略的捷徑問題公開化,令後續模型比較更可信。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 視覺模型, 視頻模型, NVIDIA, Gemini, Video, Python, Dataset 數據集

CineMobile 點樣把電影運鏡搬上手機

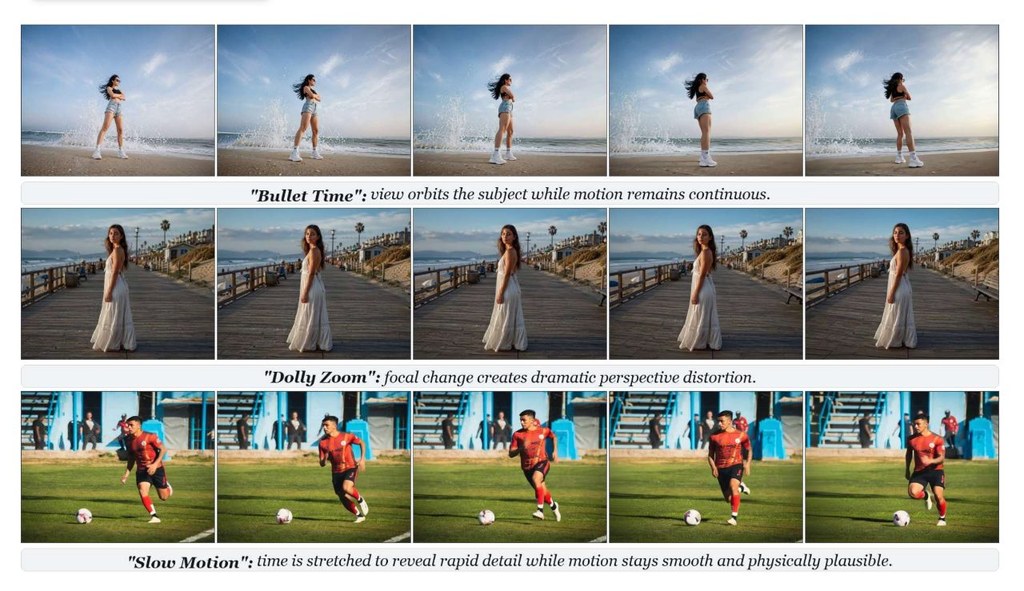
想用一張相做出 bullet time 或 dolly zoom,CineMobile 瞄準的正是手機端生成速度與畫質之間的拉扯。它把大型影片擴散模型壓縮到可落地的體積,同時盡量保住電影感運鏡。

Hugging Face

由 Wan 2.1 架構的 teacher model 壓縮而來,CineMobile 針對 image-to-video diffusion 而設,重點唔係追求最大全能,而係讓 bullet time、dolly zoom、slow motion 這類電影感鏡頭可以在手機晶片上跑得動。對一般使用者來說,最大差異是它把原本偏向雲端或高階 GPU 的生成流程,縮短到可在行動裝置完成的級別。

技術路線分三步走:先用 distillation-guided pruning 保留關鍵影片生成能力,再把壓縮後模型結合 diffusion distillation 與 reinforcement learning,進一步做成 4-step generator,最後再用 hybrid post-training quantization 把整體模型壓到 1 GB 以下。這組做法直接對準兩個瓶頸:DiTs 參數太大,以及多步去噪太慢。

頁面提供的數字相當具體。相比採用 Wan 2.1 architecture 的 teacher model,CineMobile 可帶來 40× 生成加速;生成 49-frame、480p 影片時,在 NVIDIA H200 GPU 的每步 denoising latency 為 0.6 秒,在 MediaTek Dimensity 8400 Ultimate 5G 平台約為 20 秒,峰值記憶體使用量為 1.8 GB。這代表它雖然仍有明顯等待時間,但已進入手機可接受的範圍。

  • 基礎來源可確認與 Wan 2.1 架構有關,但頁面未見完整 base model 款式或 checkpoint 名稱
  • 核心優化包括 pruning、distillation、reinforcement learning 與 post-training quantization
  • 目標輸出為 49-frame、480p 的 cinematic camera motion 影片
  • 重點能力在於連續運鏡,同時維持 subject identity 與 scene consistency

Hugging Face 暫未提供可直接下載量化檔的模型頁,未提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio、chat template 或 v2 檔名更新資訊,亦無法判斷是否支援 MTP draft speculation。

項目主頁 · Paper

Categories: AI productions, 視頻模型, 模型訓練, NVIDIA, Video, Image, LLaMa, Ollama

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

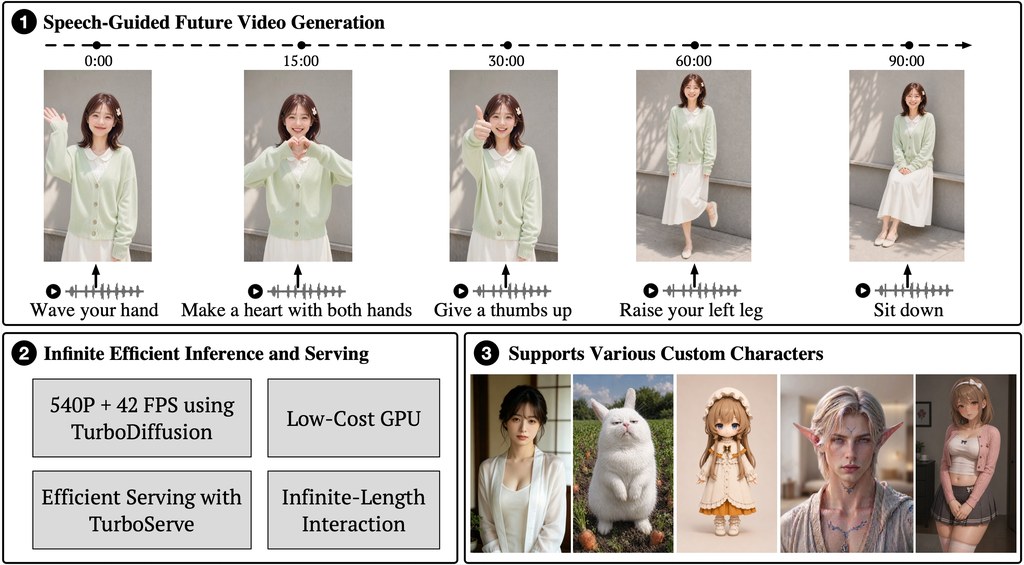
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

OpenCoF 用影片學會推理

推理未必只靠文字一步步寫出來,OpenCoF 把重點放到影片幀與幀之間的連續變化。它想證明,生成影片本身都可以成為推理過程。

Repository image for xinyan-cxy/OpenCoF

文字 Chain-of-Thought (CoT) 之外,OpenCoF 把推理搬到影片時間軸上,主打 Chain-of-Frame (CoF) reasoning:模型不是靠外部工具拆步驟,而是在連續生成的畫面裡理解因果、規則同狀態變化。這屬於一個研究型框架,核心想處理的問題,是現有影片生成模型多數只見過一般影片資料,未必學到穩定的時序推理能力。

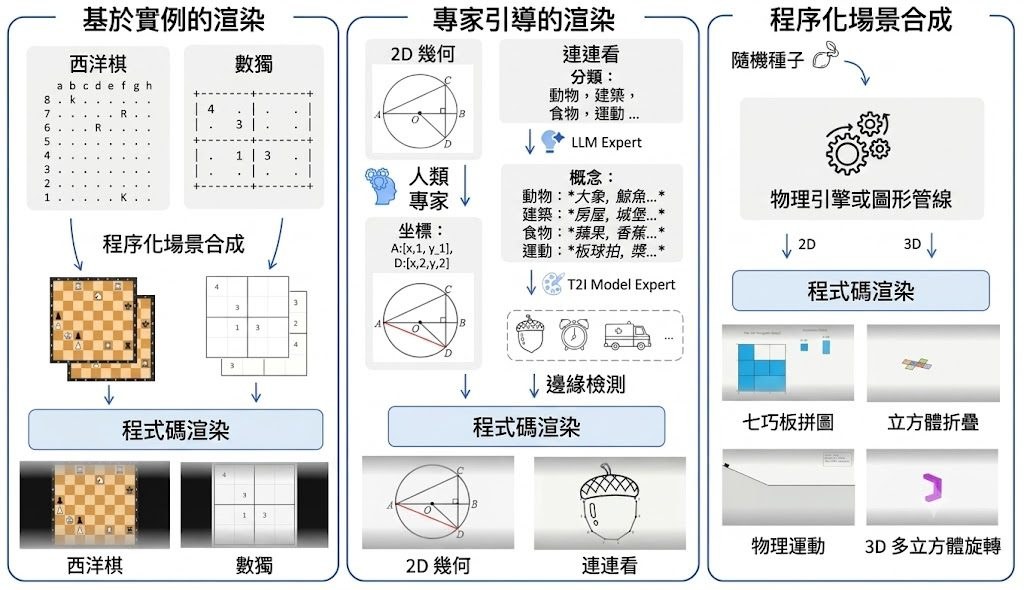
作者對既有做法的批評很明確:以往影片模型通常用通用影片語料訓練,缺少專門針對 CoF reasoning 的監督,因此即使畫面能動起來,都未必真係「識推」。OpenCoF 於是補上兩層東西:先有 OpenCoF-17K 這個包含 17,312 段影片、覆蓋 11 類任務的資料集,再用它把 Wan2.2-I2V-A14B 經 LoRA 微調成 Wan-CoF,之後再加上 Visual Reasoning Tokens (vt) 與 Textual Reasoning Tokens (tt) 兩種設計。

OpenCoF 先用資料監督驗證影片推理能否被教出來,再用 token 設計補強中間推理狀態,而不是一開始就堆很多複雜推理機制。公開資訊顯示,Wan-CoF 單靠資料監督,已經在 MME-CoF、Gen-ViRe、VIPER、RULER-Bench 四個外部 benchmark 全面勝過基線;Wan-CoF vt 與 Wan-CoF tt 則再向前一步,但兩者偏重不同,vt 較擅長低階視覺線索,tt 較著重高階語意先驗。

  • OpenCoF-17K 由四條資料整理流程建成,兼顧規則型任務、程序生成場景與真實影片多樣性
  • Wan-CoF 以 Wan2.2-I2V-A14B 為底,靠 LoRA 微調驗證資料本身已可提升推理表現
  • Wan-CoF vt / Wan-CoF tt 分別從視覺 latent 與文字條件序列加入 reasoning tokens,走兩條互補路線
  • 評測覆蓋 MME-CoF、Gen-ViRe、VIPER、RULER-Bench,結果指向同一件事:時序監督對影片推理有明顯幫助

OpenCoF 適合研究團隊、做視覺推理評測的人,或者關注 Video reasoning 與 Video generation 交界的開發者參考:儲存庫已公開論文與方法框架,但 code、dataset 同 model checkpoints 仍在內部審核,暫時未能直接下載測試;現時較合理的理解方式,是先把 OpenCoF 視為一個針對 CoF reasoning 的資料與訓練範式,等正式釋出後再判斷重現成本與落地價值。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 字節跳動, 視覺模型, 多模態模型, 視頻模型, Video, 蘋果, Dataset 數據集

LingBot-Video 想做懂物理的生成影片

首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-Dense 同 LingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

NVIDIA 用單一影片模型兼顧連貫與速度

想要影片生成既連貫又夠快,往往要在畫質、全局一致性同串流效率之間取捨。Flex-Forcing 嘗試用同一個 Video Diffusion Model,同時處理呢個矛盾。

Og image

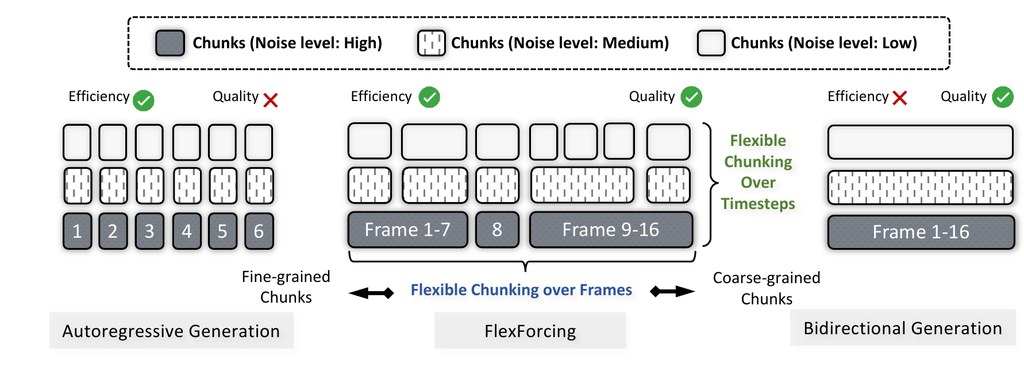
做影片生成時,最常見的卡位係:Bidirectional diffusion 生成得穩,前後鏡頭更一致,但速度慢;Autoregressive 方式可以逐段輸出,較適合串流,不過長片段容易失去連貫。Flex-Forcing 針對的正正係呢個兩難,屬於影片模型方向,目標係用同一個 Video Diffusion Model 橫跨兩種生成模式。

它的做法不是把兩套系統硬拼在一起,而是用一個較靈活的 chunking 機制,同時沿時間軸同 denoising steps 去切分。咁樣模型可以在 chunk 之間做 bidirectional 的全局規劃,又能在 chunk 之內用 autoregressive 方式逐步生成,兼顧整體一致性同推理效率。網頁用一句話概括得很清楚:one model, two generation regimes。

對內容創作、長影片生成同需要邊生成邊輸出的工作流來說,呢種設計幾有吸引力。它不是單純追求最快,亦不是只追求最完整的全局建模,而係嘗試將「先看全局」同「逐段出片」放入同一套推理框架,減少以往要為不同場景分開選模型的麻煩。

  • 統一 Bidirectional 與 Autoregressive 兩種影片生成路線
  • 以 temporal axis 配合 denoising steps 的 chunking 作核心設計
  • chunk 之間強調全局規劃,chunk 之內保留串流生成能力
  • 目標是改善長距離一致性、速度與 exposure bias 之間的取捨

現有資料顯示,Flex-Forcing 的核心價值在於統一訓練與推理框架,而不是只做單一生成模式的微調優化。公開內容暫時未完整列出具體評測細節,但方向已很明確:希望用一個模型覆蓋更多影片生成場景,特別適合重視長片段敘事連貫,同時又需要較靈活輸出節奏的項目。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, NVIDIA, Video, 框架

AlayaWorld 想做可玩式長時影片世界

它唔止係生成影片,重點係讓鏡頭可即時移動、途中改提示,場景仍盡量記得之前發生過乜。AlayaWorld瞄準的,是更接近「可探索」而唔只係「可觀看」的世界模型。

fig1 AlayaWorld

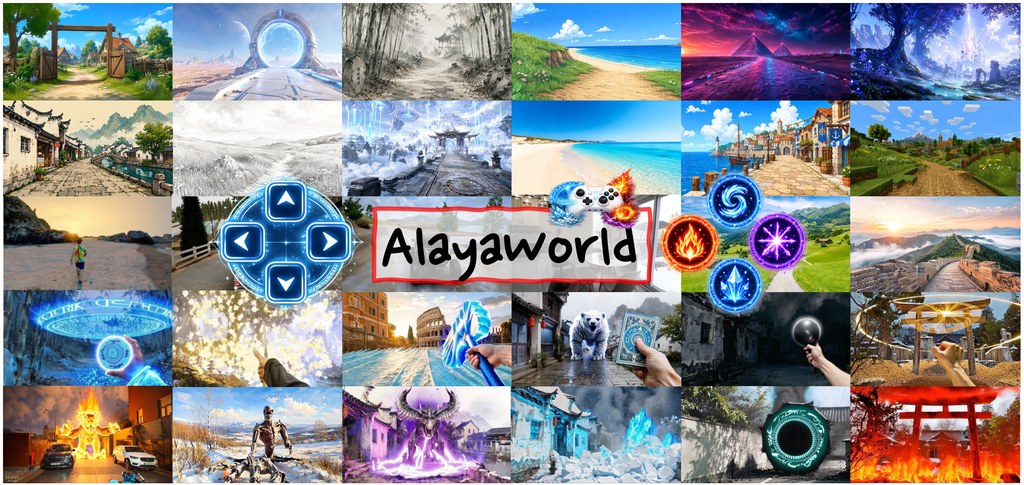
一段生成影片能否變成可探索空間,關鍵唔係畫面靚唔靚,而係鏡頭轉向、路徑改變、甚至中途加入新事件之後,個世界仲認唔認得自己。AlayaWorld屬於world model 研究項目,目標係處理長時間影片生成入面最麻煩的幾件事:互動控制、記憶一致性,同埋長序列愈滾愈走樣的問題。

而家不少影片生成做法偏向一次過出片,畫面可以吸引,但未必承受到持續探索;鏡頭一郁、提示一改,前後場景就容易斷裂。AlayaWorld明確反對呢種偏靜態範式,改用 interactive autoregressive world model 路線,把 3D cache、frame-history embedding,同 chunk-level prompt switching 組合起來,嘗試同時保住空間記憶、時間連續性,同中途插入事件的能力。

它最有辨識度的地方有幾個:一方面用 rendered 3D cache 配合輕量 AdaLN camera modulation,令 6-DoF 鏡頭控制更貼地;另一方面又用壓縮後的歷史影格表示,幫手維持 revisited places 的辨識度。為咗減少長時間 rollout 累積錯誤,團隊亦加入 drifted histories 訓練同 error bank,把已出現的瑕疵重新注入記憶與目標,避免失真一路放大。

  • 支援 real-time camera control,同時可在片段邊界切換 prompt
  • 以 3D cache 加 frame-history embedding 處理空間與時間記憶
  • 透過 few-step DMD distillation 爭取即時生成效率
  • 官方展示指向 720p、24 FPS、60s+ long-horizon、15B parameters
  • 目前公開的是 technical report、示範頁與影片,code 與 weights 尚未釋出

現階段較適合把它理解成研究原型,而唔係可立即部署的開源工具。想測試的人,暫時只能先睇 demo 同 technical report,重點觀察鏡頭移動、風格切換、事件插入後的連貫度;等 inference code 同 pretrained weights 釋出後,先有條件判斷佢喺內容製作、互動敘事、遊戲原型或世界模型研究工作流入面,究竟可以走到幾實用。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 世界模型, 3D, Dataset 數據集

Page 8 of 18
1 … 6 7 8 9 10 … 18