PhysStream:邊播邊拉物件,讓 AI 影片生成更貼近物理直覺

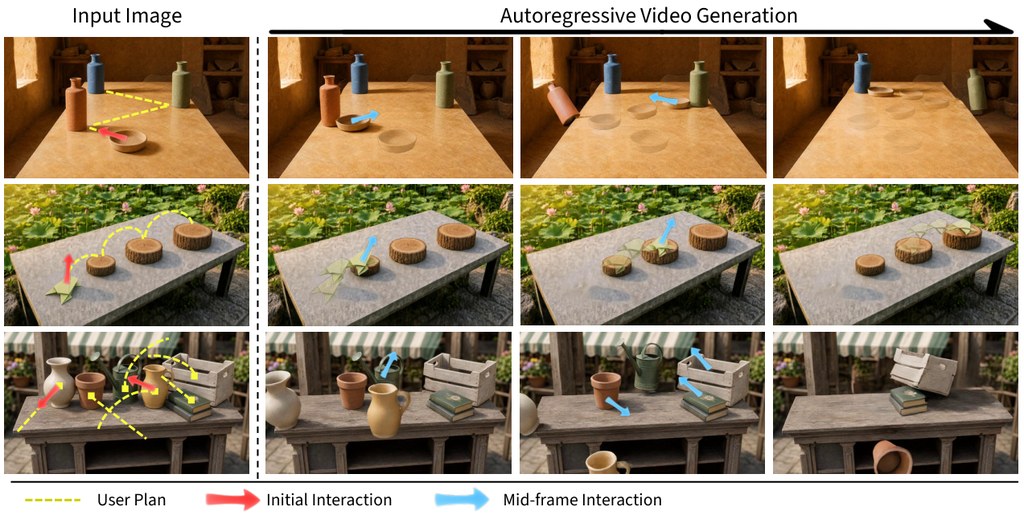
PhysStream 是一個物理導向的影片生成模型,用戶可以在生成過程中隨時拖動物件來改變它的運動方向,做到真正的中途互動控制。

Og image

以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。

核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。

PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。

重點摘要:

  • 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
  • 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
  • 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
  • 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
  • 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%
項目主頁

Categories: AI productions, 視頻模型, 模型訓練, Video, World-Action Model, Robotic, 動畫

AlayaVista:全景潛態驅動嘅可串流世界模型

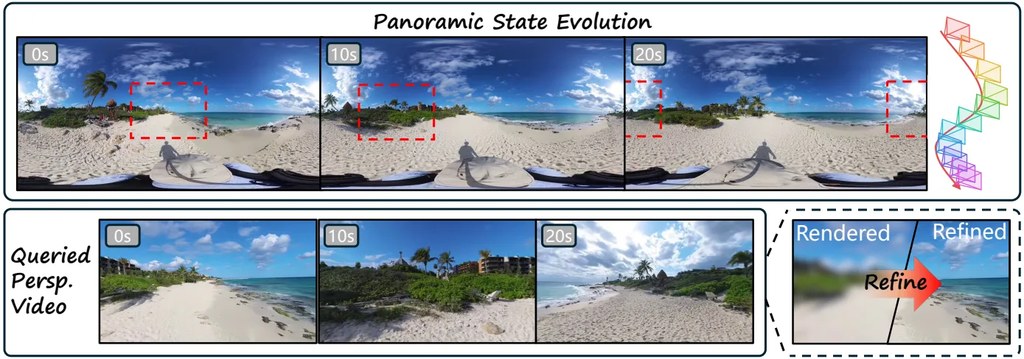
AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

EditVid:零訓練、單一框架處理五大影片編輯任務

伊利諾伊大學 PLAN Lab 推出 EditVid,毋須訓練即可在一個框架內完成風格轉換、屬性修改、物件插入等多種影片編輯。

PLAN Lab Logo

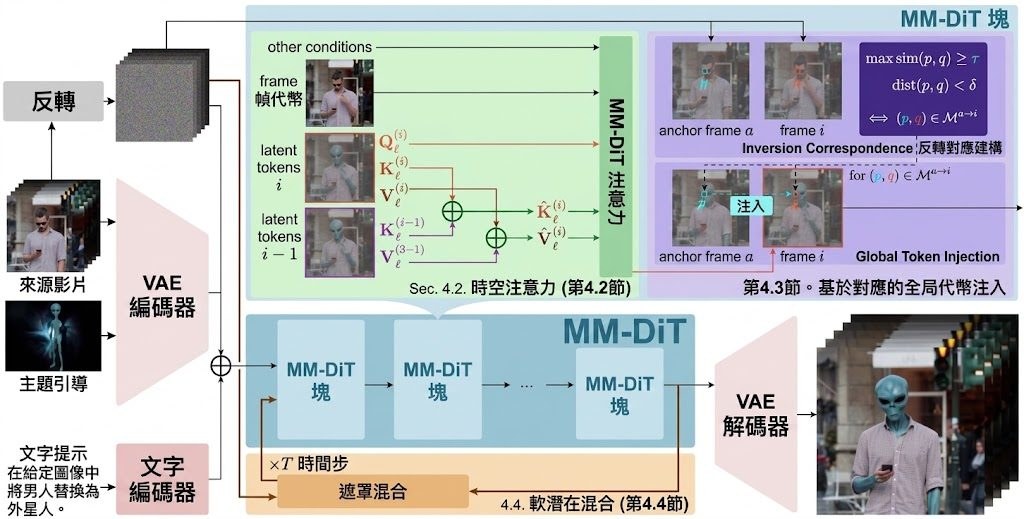
想用同一套方法幫一段影片換風格、改顏色、甚至換主體,又唔想為每種任務訓練專屬模型?PLAN Lab(伊利諾伊大學厄巴納-香檳分校)嘅 EditVid 正正就係為呢個煩惱而設計。佢屬於免訓練(training-free)嘅影片編輯框架,直接喺凍結嘅多模態擴散 Transformer(MM-DiT)圖像編輯器上動手術,同時支援文字指令引導同參考圖引導兩大路線。

對一般用家嚟講,最大體感差異係:一條原本只能用嚟改顏色嘅編輯鏈,現在仲可以做局部部件編輯、物件插入、主體替換等五類任務,唔使每樣重新煉模型。你叫佢「將大象變藍色」、「將海浪轉做黑色」、「將衣服轉紅色」,佢都能在同一條流程內完成。

佢能夠兼顧短距離同長距離一致性,關鍵在於三個互相配合嘅設計:

  • 稀疏因果記憶:每幀只向前一幀取視覺鍵值狀態,避免長距離 RoPE 交互變得唔穩定。
  • 後注意力 Token 注入:用置信度同循環一致性匹配把幀同錨點幀對齊,再注入匹配到嘅視覺表示,維持主體外觀一致。
  • 軟潛空間混合:根據時間步動態調整保留權重,源內容需要保留嘅地方唔會被強行覆蓋。

量化結果方面,喺 FiVE 基準上 EditVid 拎到 78.16 分 FiVE-Acc,比目前最強嘅訓練免費基準高出近 20 分;喺 IVEBench 上面亦取得具競爭力嘅成績。用戶研究入面,超過一半受訪者(51.8%)傾向揀 EditVid 而唔係其餘 7 種對比方法。

如果日常工作涉及大量短片二次創作、廣告素材改版、或者需要快速試驗唔同視覺風格,EditVid 提供嘅「零訓練、單一框架」思路可省卻大量前置準備成本。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 框架

MiniMax-H3 Singularity:提升影像轉影片品質

基於 MiniMax-H3 深度微調的多模態影片模型,針對動作模糊、遠景人臉失真與光影過油等痛點進行修補。

Minimax-h3_Singularity 是建基於 MiniMax-H3 的多模態影片生成模型,採用 Apache-2.0 授權,於 ComfyUI 環境原生支援 Text-to-Video(T2V)、Image-to-Video(I2V)、Reference-to-Video(Ref2V)以及 Video-to-Video(V2V)四種工作流程。開發者並非單純做一次 LoRA 貼片,而是將 refflb25-49 等多個關鍵 checkpoint 進行策略性融合,再以高步數深度微調,最後花三天做精準剪枝與權重優化,目的是在保留 MiniMax-H3 原生 prompt 適應力與泛化能力的同時,壓住高步數訓練帶來的鬼影與過擬合。

這個版本重點針對三類常見瑕疵:高動態場景的運動模糊、Medium-to-Long Shot 距離下的人臉崩壞與糊化,以及人物皮膚過油、光澤不自然的問題。在功能面上,它特別加強了武打對戰、魔法施法、粒子光暈等奇幻動作場景的動感張力,同時提升鏡頭語言對搖鏡、推拉、追蹤等運鏡指令的回應度。

模型以 ComfyUI 節點工作流為主要入口,並附帶 RunningHub 線上 Demo 以及 YouTube、Bilibili 展示頻道連結,方便先觀察實際輸出再決定整合方式。

MiniMax H3 Singularity开源!全面微调融合,基础能力还在!嗨,大家好,这里是啊ban!快去玩!纯推荐分享视频!

重點摘要:

  • 基礎模型:以 MiniMax-H3 為底,融合 refflb25-49 等 checkpoint 做高步數微調與剪枝
  • 支援工作流:T2V、I2V、Ref2V、V2V 四種 ComfyUI 多模態流程
  • 主要修正:HDR 影像品質、遠景人臉修復、去油感光影、強化武打與魔法 VFX 動感
  • 鏡頭控制:對 pan、tilt、zoom、tracking 等運鏡指令有更敏銳回應

項目主頁

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, MiniMax

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

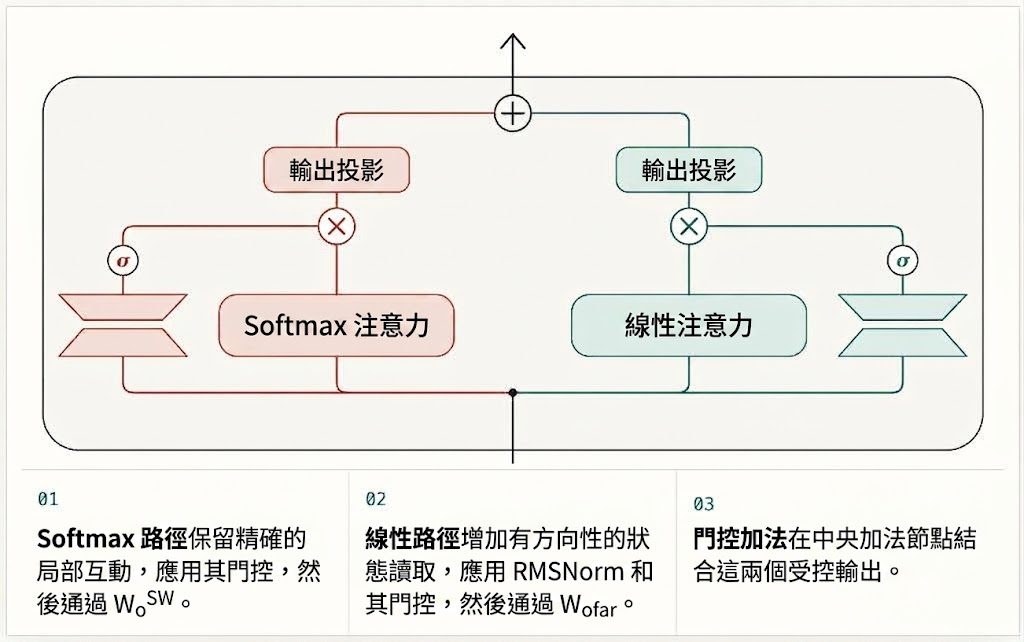
影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點

Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

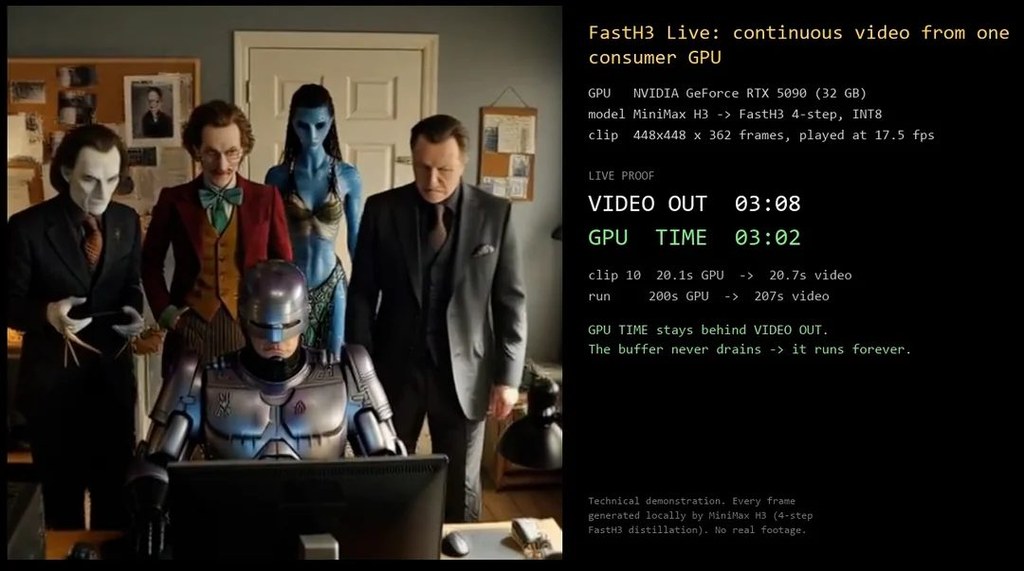
FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。

項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

LayerRecall 讓長影片生成記得返之前嘅角色

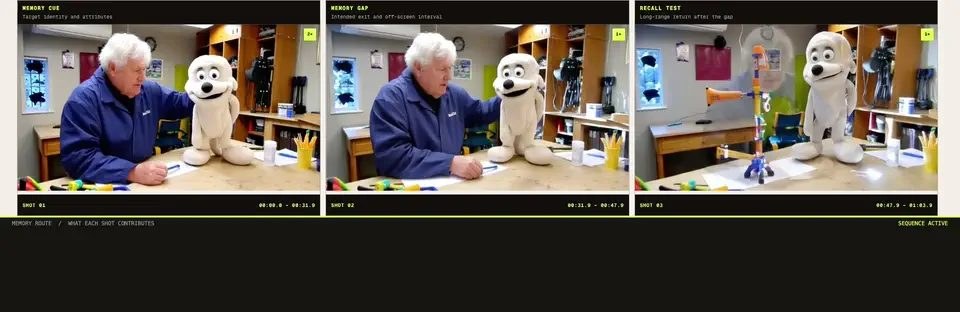
長影片 AI 最怕隔咗一段就認唔返角色同場景,LayerRecall 用記憶路由加選擇性注入,只喺敏感層補返歷史 K/V,效果贏過 MemoBench 同 MovieBench。

Memory Cue Recall animated preview

用 autoregressive 方式逐段砌長片,視窗一滑過去就會連角色同場景都一齊唔見——LayerRecall 就係針對呢個痛點。佢屬於記憶路由模組,唔係新模型,定位係加喺現有影片 DiT 上面做補強。當一段 chunk 入面出現需要回憶嘅元素(例如主角、服飾、場景)時,佢會用 current-conditioned 嘅方式去 historical candidate pool 做 cosine retrieval,搵到相關嘅 K/V state 之後再注入返去揀過嘅記憶敏感層,例如 4、9、10、12、13、15、16、17、18、26 等。其餘本地 attention 就照舊行,唔會因為補歷史資料而擾亂局部連貫性。

想理解點解要分層注入,研究發現唔同 layer 對「當下」「近期」「遠距」context 嘅依賑差好遠,所以亂餵歷史 token 反而會害咗本地一致性。配合嘅 KV cache budget 大約係 80 個 latent frames,本地 attention 32 幀,當中 8 幀做 sink、8 幀做 current chunk。訓練上仲用咗 Cross-Horizon Prediction Matching(CHPM),由一段長 context reference 喺 prediction space 監督呢個有界嘅 router,等佢喺稀缺長片數據下都學到幾時去 recall 乜嘢。

100 條多 shot prompt 評估入面,LayerRecall 喺 MemoBench 同 MovieBench 攞到最佳綜合結果,VBench-Long 維持返 backbone 水準,可見長距離回復做得好而本地連貫無受犧牲。論文仲展示咗 memory-guided self-correction,模型會主動糾正返之前嘅錯處。

重點摘要

  • 屬於記憶路由模組,設計上要喺現有影片 DiT 上加掛
  • 只喺 memory-sensitive 層注入歷史 K/V,其他層保持本地 attention
  • 訓練用 CHPM,用長 context reference 喺 prediction space 監督 router
  • MemoBench 同 MovieBench 綜合表現領先,VBench-Long 維持 backbone 水準
  • 適合做多鏡頭、跨時間角色同場景一致性嘅長影片生成工作

呢類工具對做長片創作、廣告分鏡或者角色需要反覆出場嘅團隊會幾實用;研究人員亦可以睇佢點樣將「selective injection」呢個取捨由啟發式變成可學習路由。

項目主頁 · GitHub

Categories: 開源, 香港大學, 視頻模型, 香港

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

Page 1 of 16
1 2 3 16