MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

ComfyUI-Spectrum-MiniMax-H3:為 H3 加速 33%

將 1056x608 影片生成由 685 秒縮短至 464 秒,避開昂貴的 transformer 重算。它屬近似加速,但影片細節可能走樣。

Repository image for xmarre/ComfyUI-Spectrum-MiniMax-H3

每次跑 MiniMax H3 都要付出完整 transformer 計算成本,對要反覆試 prompt、鏡頭動作同參考音訊的人來說,等待本身就是工作流瓶頸。xmarre/ComfyUI-Spectrum-MiniMax-H3 針對的正是這一步:它屬於 ComfyUI 自訂節點工具,會在部分 solver steps 直接預測 post-transformer hidden features,減少原生 MiniMax H3 audio-video model 的重計算次數。

實測生成 1056×608 影片由 685 秒縮短至 464 秒。加入這 Node 後可惜仍未能解決「廣東話」問題!

它不是把整個模型 shortcut 掉,而是用 Chebyshev ridge model 去擬合已經算出的 hidden features,再對未來步數作 spectral forecasting;但當前步的 output heads、video reconstruction、audio reconstruction、sigma mapping 同回傳結構仍然照常執行。這個取捨很務實,因為它換到的是抽樣成本下降,不是完全無損加速,所以 README 已經講明輸出不會與原生 MiniMax H3 bit-identical。

作者後來把預設路徑改成 offline_smoothing_replay,核心原因不是追求更高畫質,而是先救回音訊品質。早期單次流程會令語音清晰度、自然度同穩定性下降,甚至出現 doubled syllables 同 stuttering;現時預設把 audio_blend_weight 維持在 0,並以第二次無 transformer 的 replay 處理 video blend,目的就是切斷後段 video-to-audio feedback 對聲音的干擾。不過,畫面軌跡仍可能改變,動作、視線、時間點,甚至眼睛、手指、四肢細節都有機會走樣。

安裝十分簡單,適合願意做 exact-seed A/B 比對的創作者、工作流調校者,或者已經在 ComfyUI 內使用 MiniMax H3 的團隊。README 也提到舊版 workflow 可能要手動開啟 offline_smoothing_replay,而且 broader checkpoints、prompts、samplers 同 reference inputs 仍未完成足夠驗證,現階段更像是一個有方向、有明確修正策略,但仍需按素材類型逐步確認的加速方案。

  • 以 spectral forecasting 預測部分 future solver steps,重點是減少 MiniMax H3 最昂貴的 transformer evaluations。
  • 保留當前步的原生輸出頭與音畫重建流程,因此屬於近似加速,不是無損複製原生結果。
  • 預設改用 offline_smoothing_replay,主要是修正早期版本對語音自然度與穩定性的破壞。
  • 音訊路線暫時較保守,但視覺結果仍可能出現 motion、pose 與細節結構偏移。
  • 較適合已在 ComfyUI 工作流內做反覆測試、願意接受 A/B 驗證成本的使用情境。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

ComfyUI-MiniMaxH3-Easy:幫 H3 補回可用性

把 MiniMax H3 放進 ComfyUI 後,最麻煩的接線、引用同提示編排,被整理成較順手的一套介面。

Mixed media input

做影片生成時,最阻手往往唔係模型能力,而係節點圖愈接愈亂、參考素材愈加愈難管理。ComfyUI-MiniMaxH3-Easy 屬於 ComfyUI 自訂節點工具,集中處理 MiniMax H3 的 text-to-video、image-to-video 同 reference-to-video 工作流,將原本分散嘅媒體接線、參考標記同提示編輯收埋到同一個操作面。

呢個項目最實際嘅改動,在於保留 ComfyUI 彈性之餘,減少你每次都要手動整理素材順序。主節點用一個 Media 輸入口同時接收圖片、影片同音訊,仲會分開追蹤各自次序;一張圖會走 image-to-video,兩張圖就可用作 first/last-frame generation。做 reference-to-video 時,提示編輯器支援 @ 揀選已連接素材,執行時再自動轉成 MiniMax 建議嘅 <Picture N>、<Video N>、<Audio N> 格式,唔使自己逐個標籤維護。

  • 將多種媒體收進單一 Media 入口,節點圖會乾淨得多
  • @ 參考編輯器有預覽,較適合需要反覆改 prompt 嘅影片生成流程
  • # 對話區塊可直接寫成可編輯 block,送出時自動轉成 <d>...</d>
  • 可接 model-only LoRA、Sage Attention patch,亦可直接連到模型相關節點

同類做法通常要求使用者自己記住引用格式、接線順序同素材對應,ComfyUI-MiniMaxH3-Easy 選擇用較重介面包裝,換來較低出錯率同較高可讀性。代價亦明顯:它改善嘅係 MiniMax H3 在 ComfyUI 入面嘅操作層,不是另起一個新模型,也未見提供生成品質、速度或資源佔用測試數字,因此價值主要落在工作流整理,而唔係模型性能突破。

較受惠嘅會係已經用開 ComfyUI、但又嫌 MiniMax H3 節點圖太碎太亂嘅創作者、影片實驗團隊同需要反覆比對參考素材嘅人。部署方式亦唔複雜,理解上可以當成安裝到 ComfyUI 內嘅一組工作流節點:接好模型或 LoRA、把圖片或影片餵入 Media、再用內建編輯器整理引用同對話內容,就可以直接進入生成流程。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

MiniMax-H3 Turbo LoRA 移植 ComfyUI,4 步生成同步聲畫

呢個版本唔係重新訓練主模型,而係把 MiniMax-H3 Turbo LoRA 轉成 ComfyUI 可直接載入的格式。重點在於 4-step 加速生成,同時保留聲畫同步能力。

Og image

想用更少步數生成影片同音訊,呢個頁面最值得留意的地方,是它明確基於 Comfy-Org/MiniMax-H3,而且屬於 adapter 形式的 LoRA,不是完整基礎模型。它針對 ComfyUI 使用的 pruned/curve-form MiniMax-H3 checkpoint 做兼容轉換,目的是讓原本由 larryvrh 發佈的 MiniMax-H3 Turbo LoRA — 4-step audio-video generation preview,可以透過 ComfyUI 內建的 MiniMax-H3 LoRA 載入流程使用。

技術上,核心價值在於把原始 Turbo LoRA 的 four-step distillation 和 dual video/audio sampling 帶入 ComfyUI 工作流。4-step 代表生成步數大幅壓縮,推理延遲有機會下降;頁面同時指出 non-EMA 權重較銳利、較能保持快速動作,EMA 權重則較平滑,但因為當時 EMA 未完全成熟,畫面會較柔。呢種取捨直接影響你想要的觀感:動態表現優先,可先看 non-EMA;畫面過渡想更順,EMA 版本更值得比較。

檔案方面,頁面列出 4 個 .safetensors LoRA 權重,包括初始兼容轉換版,以及兩個 further-trained checkpoint-500 變體:minimax_h3_turbo_4step_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ema_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ckpt500_pruned_comfyui.safetensors,以及對應的 EMA checkpoint-500 版本。

  • 基礎模型已明示為 Comfy-Org/MiniMax-H3,屬於 LoRA adapter 兼容轉換
  • 主要能力是 text-to-video,並帶有 text-to-audio、audio-video、synchronized-audio 標籤
  • 重點方法來自原作者的 four-step distillation,目標是加速推理
  • 頁面提供 ComfyUI workflow 範例下載,定位很明確:直接服務 ComfyUI 用戶

這個 Hugging Face 頁面是第三方整理的 ComfyUI 相容版本,價值在於把原始 MiniMax-H3 Turbo LoRA 接入 ComfyUI 生態,方便直接測試 4-step 聲畫同步生成與 checkpoint-500 變體之間的差異。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

MiniMax H3:全模態影音生成說明書

MiniMax H3 把文字、圖片、影片與聲音整合到同一套生成流程,並支援同步影音輸出。

Og image

MiniMax H3 面向需要由多種媒體素材生成影片的場景,輸入可包括文字、圖片、影片及聲音,輸出則涵蓋影片與同步音訊。它屬於通用 omni-modal generative system,並非只處理 text-to-video,亦標示支援 image-to-video、video-to-video、audio-to-audio-video 等流程。提供的內容未載明它基於哪個 base model,亦無法確認是否由其他模型 fine-tuned from。

這種統一處理方式適合將參考圖片、動態片段或聲音一併納入生成條件,減少工作流程需要分拆成多個模型的情況。metadata 指向 Diffusers,並列出 multimodal、synchronized-audio-video 及 reference-to-audio-video 等能力;不過目前資料未交代模型架構、參數規模、上下文長度、訓練方法或效能指標。

可留意的使用重點包括:
– 支援 text-to-video、image-to-video、image-text-to-video 及 video-to-video。
– 可處理文字、圖片、影片與音訊,並生成 audio-video 組合內容。
– 提供 Global 與中國地區的 Online API,以及 Hailuo AI 網頁和桌面 App。
– 標示使用 MiniMax H3 Community License Agreement,部署前應查閱 LICENSE。

項目主頁

Categories: 開源, 多模態模型, 視頻模型, Video, Image, Audio, 3D, Ollama, MiniMax

JoyAI 把即時串流影片編輯推向 720p

影片逐幀抵達便可按文字指令修改,JoyAI-Video-Edit 以 30.19 FPS 連接即時攝影與生成式編輯。

JoyAI-Video-Edit teaser

直播畫面或上載影片不必等到完整片段準備好,便能一邊輸入自然語言指令、一邊看到修改結果。JoyAI-Video-Edit 屬於開源影片生成及影像處理模型,處理的是影片串流中延遲高、必須預先知道片長,以及難以維持連貫性的編輯流程。

它支援主體修改、局部區域調整、背景替換、風格轉換、動作改變和參考影像引導,適合互動示範、直播效果及需要即時預覽的創作工具。系統以 Multimodal Large Language Model(MLLM)條件編碼器、causal video Variational Autoencoder(VAE)及 16B-parameter Multimodal Diffusion Transformer(MMDiT)組成,逐段處理新抵達的畫面。

同類影片生成方法往往先取得完整影片,再一次過進行離線處理;JoyAI-Video-Edit 改用 autoregressive diffusion,配合 aligned autoregressive distribution matching distillation、long-horizon optimization、bounded Key-Value state(KV-state)inference 和 deployment-oriented scheduling,換取串流速度。不過,這種設計仍要留意長時間輸出可能出現的 temporal drift,而且消費級 GPU 支援仍列為待辦工作。

部署基準在 720×1280 解像度達到 30.19 FPS end-to-end throughput,代表系統已接近互動式影片處理所需的速度,但不能直接等同於所有硬件和指令下都能保持相同表現。Hugging Face 提供 JoyAI-Video-Edit checkpoint,GitHub 同時提供部署程式碼和線上 Demo,較適合具備 GPU 資源、希望整合影片工作流,或研究 Computer Vision 與串流生成的團隊。

  • 即時串流:畫面逐幀處理,不要求預先提供完整影片或固定片長。
  • 指令範圍廣:涵蓋主體、局部、背景、風格、動作及參考影像編輯。
  • 速度指標:720×1280 下達到 30.19 FPS 的完整流程吞吐量。
  • 部署取捨:透過 bounded KV-state inference 控制計算量,但消費級 GPU 支援仍未完成。
  • 適用人群:影片工具開發者、直播創作者及需要即時預覽的研究團隊。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Google, NVIDIA, Video, 蘋果, Dataset 數據集

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRA、audio_proj_step_*.pt、wav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • 用 Brownian bridge 同 Bridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGE、AUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

Youtube 影片

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

VideoCoCo 先用代碼演物理再出片

想要影片動得合理,又唔想一開始就靠像素生成碰運氣,VideoCoCo提供咗另一條路。它先把物理過程寫成可執行草稿,再交畀影像模型做寫實化。

cot paradigm

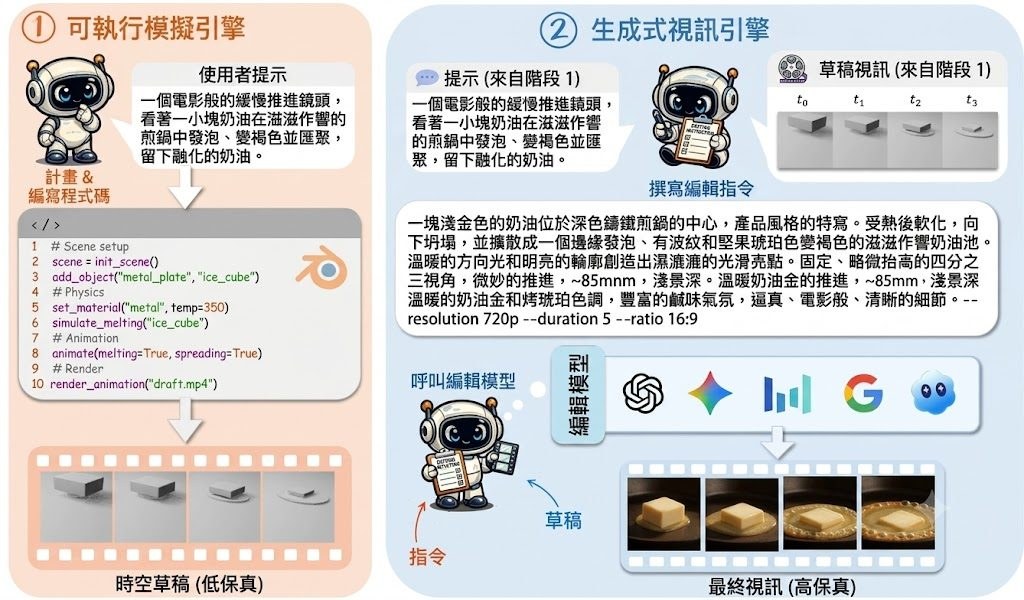
一段影片要做到「似真」並不只靠畫面細緻,動作因果同物理變化站唔站得住腳更關鍵。VideoCoCo屬於視頻生成管線,處理的正是這個問題:先用 code as a chain-of-thought 寫出物理草稿,再把中性白模影片轉成寫實結果,減少模型直接由像素猜測運動時常見的失真。

VideoCoCo 不是一步生成最終影片,而是先由 code agent 產生 Blender 可執行模擬,輸出灰白、近似 clay render 的 proxy video,讓形狀、透明度、變形、遮擋與運動先承載物理意義,之後再檢查這段草稿是否符合 physical plan,最後才用編輯指令把 proxy restyle 成 photorealistic video。這種雙階段流程換來較強的可控性,但也代表整體鏈路比單段式生成更長,對中間草稿品質有依賴。

目前 GitHub 已放出五個 Agent Skills、batch inference 腳本、對上游 OmniWeaving 的 patch,以及 Hugging Face 上的 tuned transformer;另有 8 組 hand-checked 的 video-to-video triplets 可用來理解資料格式與輸入輸出關係。README 停在 Inference 章節開頭,未見完整安裝與執行細節,所以現階段較適合把它視為可檢查流程設計與推理組件的研究型項目,而不是即裝即用的成品。

  • 先做物理草稿,再做寫實化,把運動因果同畫面風格拆開處理
  • 以 Blender 可執行代碼承載 process-level CoT,重點不在文字解釋,而在可驗證的模擬結果
  • toy dataset 只有 8 個案例,涵蓋 buoyancy、melting、surface tension、boiling 等現象,較像格式樣本
  • 已提供 tuned transformer、inference 腳本與 OmniWeaving patch,但公開資訊未足以完整重建部署流程

受益最大的會是研究 Agentic video generation、多步驟 controllable generation,或者想把物理先驗帶入視頻模型工作流的團隊。現有資料未見完整量化指標或大規模評測結果,優勢主要來自方法設計與中介表示的可檢查性;想判斷生成穩定度與泛化能力,仍要等更完整實驗或自行測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視頻模型, Video, Dataset 數據集, Skill 技能

Page 6 of 18
1 … 4 5 6 7 8 … 18