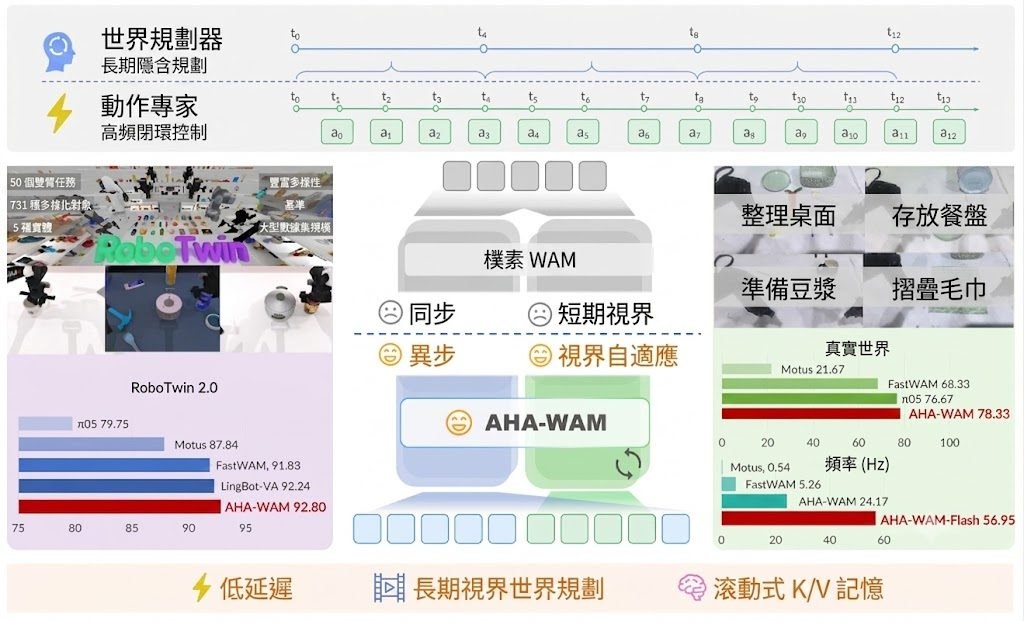
AHA-WAM 採用兩個 Diffusion Transformer(DiT)分支:低頻的 video DiT 負責長程的視覺世界規劃,並利用滾動式 K/V 記憶體儲存可重用的上下文;高頻的 action DiT 則接收本體感覺訊號,向 video DiT 查詢所需上下文後,即時產生短時閉環動作區塊。兩者各司其職,避免互相拖累。
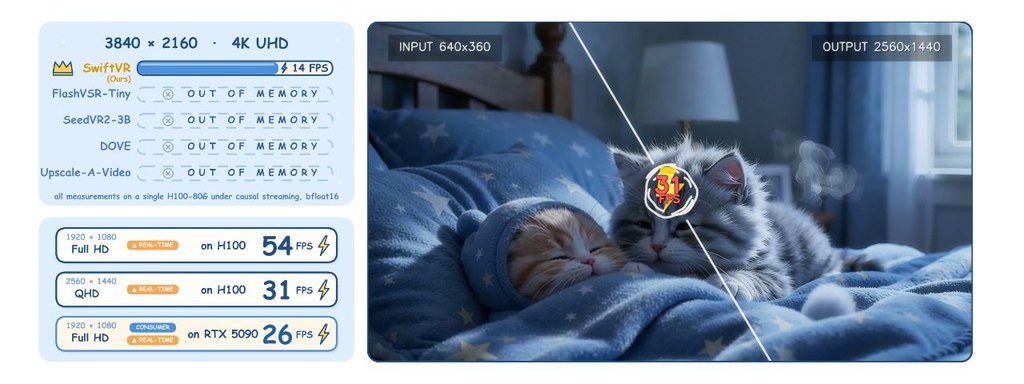
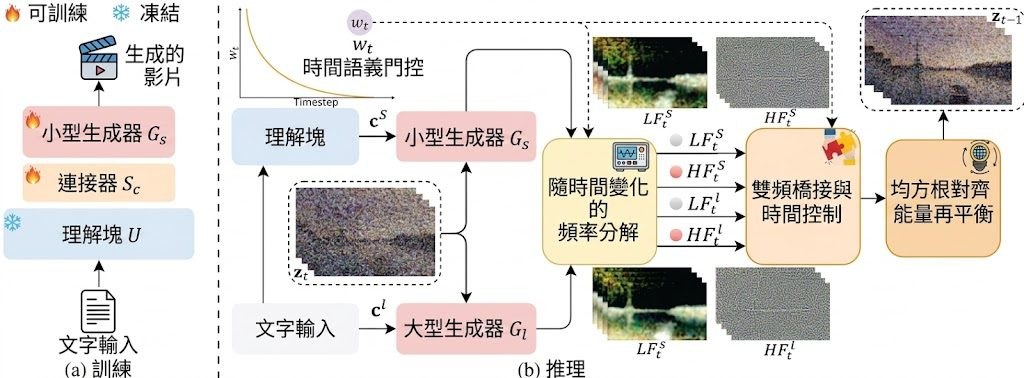
把低清、模糊的影片即時變成清楚版本,一直是擴散式(diffusion-based)影片修復(VR, Video Restoration)模型的痛點:畫質漂亮,卻慢得跑不動。SwiftVR 是一個以單步生成(one-step generative)路線設計的串流修復框架,主打把高解析度延遲壓到可即時播放的範圍,同時保持擴散模型的視覺品質。
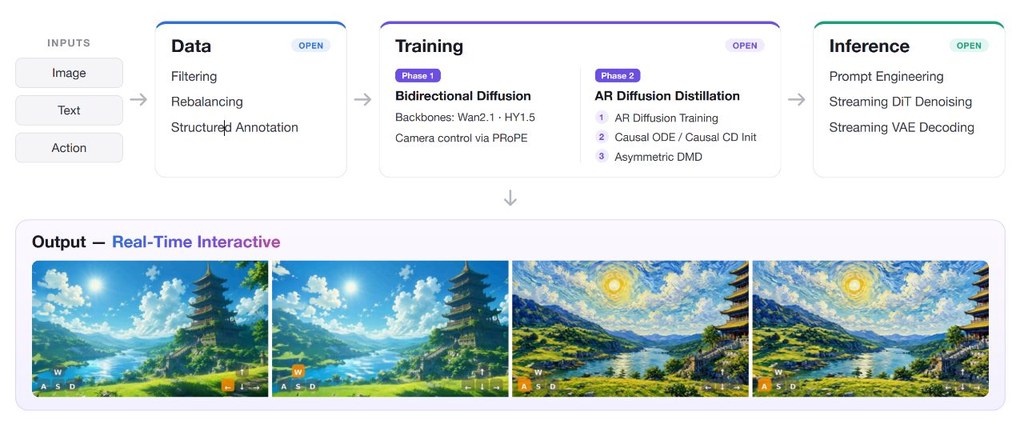
minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。
這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。
提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
提供 integrate-new-backbone,示範怎樣接入新的 video DiT
參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V
項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。
它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。