TRIBE v2 (Meta) 全腦神經活動資訊

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。 可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。 若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。
它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。

可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。

若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

Categories: 開源, 視覺模型, Medical醫學, Meta

PrismAudio 視訊立體聲模型框架

PrismAudio 是一套影片生音訊框架,把強化學習帶進 V2A 任業,並以 Chain-of-Thought 拆開語意、時間、美感、空間四個目標,讓生成結果更貼合人類偏好。

以往 Video-to-Audio(V2A)模型總要在語意對不對、聲畫同步、音色好唔好聽、空間定位準唔準四個指標之間拉鋸,往往一個 loss function 包起晒,結果邊樣都做唔好。PrismAudio 想處理嘅就係呢個「目標纏結」問題。

佢最特別嘅做法係把生成過程拆成四個專門嘅 Chain-of-Thought 模組,分別對應語意、時間、美感、空間,每個模組配對一組針對性嘅 reward function,再用 RL 聯合優化。換句話講,模型唔再係靠單一總分亂試,而係四個維度各自有指引。

訓練成本係 RL 常見痛點。PrismAudio 提出 Fast-GRPO,用 ODE 同 SDE 混合採樣,比起一般 GRPO 實現大幅減低開銷,令多維度 RL 訓練變得貼地。

團隊亦同步推出 AudioCanvas 基準,包含 300 個單事件類別同 501 個多事件樣本,比現有數據集更貼近真實多樣場景。喺 VGGSound 同 AudioCanvas 上,PrismAudio 都拎到四個感知維度嘅 SOTA。

配搭 Sora 2、Veo 3 等頂級影片生成模型時,PrismAudio 可以補上立體聲音軌,令短片多一層沉浸感。對做 AI 影片、數字人、內容創作嘅人來說,多咗一件可以直接嵌入成片流程嘅音訊工具。

重點摘要

  • 首次把強化學習引入 V2A 生成流程。
  • 四個 Chain-of-Thought 模組對應語意、時間、美感、空間 reward,拆解目標纏結。
  • Fast-GRPO 以 ODE-SDE 混合採樣降低 RL 訓練成本。
  • 自建 AudioCanvas 基準涵蓋更多真實多事件場景。
  • 喺 VGGSound 同 AudioCanvas 上四個感知維度都達到 SOTA,並可配合頂級影片模型輸出立體聲。
  • 語義合理性(Semantic)
  • 音視同步性(Temporal synchrony)
  • 音質美感(Aesthetic quality)
  • 空間準確度(Spatial accuracy)

作者的關鍵點是:現有模型通常把這些目標混在一個損失函數裡,會造成「目標互相干擾」(objective entanglement),而 PrismAudio 用 分解式 Chain‑of‑Thought(CoT)推理+多維度強化學習(RL) 來避免這個問題。

項目主頁

Categories: 開源, 視覺模型, 聲效

VLS : 透過視覺語言模型引導預先訓練機器人策略

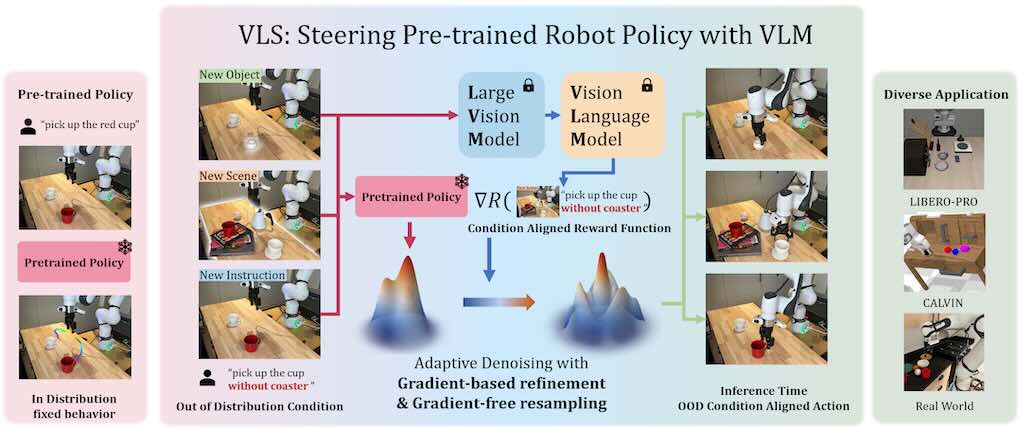
VLS(Vision-Language Steering)的具體作用是透過視覺語言模型(VLM)即時導向預訓練機器人策略,解決測試時的分布偏移,讓機器人在新環境中保持高成功率,而無需重新訓練。 VLS 針對預訓練擴散策略在空間變化(如新位置)或任務變化(如新物件)下的失效,提供無梯度、無訓練的適應機制,利用 VLM 生成可微分獎勵函數,注入去噪過程。​它將任務分解為順序階段(如「抓取」→「放置」),使用 3D 關鍵點獎勵,避免單一失敗導致整體崩潰。 場景 無 VLS 成功率 有 VLS 成功率 提升幅度 任務擾動 23% 38% +15% 位置擾動 24% 35% +11% 真實廚房任務 ~50% 85% +35%

VLS(Vision-Language Steering)的具體作用是透過視覺語言模型(VLM)即時導向預訓練機器人策略,解決測試時的分布偏移,讓機器人在新環境中保持高成功率,而無需重新訓練。

VLS 針對預訓練擴散策略在空間變化(如新位置)或任務變化(如新物件)下的失效,提供無梯度、無訓練的適應機制,利用 VLM 生成可微分獎勵函數,注入去噪過程。​
它將任務分解為順序階段(如「抓取」→「放置」),使用 3D 關鍵點獎勵,避免單一失敗導致整體崩潰。

場景無 VLS 成功率有 VLS 成功率提升幅度
任務擾動23%38%+15%
位置擾動24%35%+11%
真實廚房任務~50%85%+35%
Categories: 開源, 視覺模型, Robotic

ShapeR 隨拍可還原 3D 場景

ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟: 先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。 Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。 研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。 在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。 總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。 面向 ShapeR SAM3D 輸入 多視角序列 + […]

ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟:

先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。

Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。

研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。

在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。

總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。

ShapeR: Robust Conditional 3D Shape Generation from Casual Captures
面向ShapeR SAM3D
輸入多視角序列 + SLAM 點 + caption 等多模態單張影像 +(物件時多半要 mask / 互動)
任務重點場景級、物件為中心的度量重建與佈局單視圖高品質幾何 + 貼圖的物體/人體重建​
幾何精度強調 metric accuracy、相對尺度與佈局一致性可缺乏精確比例與 layout,特別是複雜場景​
紋理 / 外觀較偏幾何與場景結構(官網重點在 shape)​強調 photoreal 紋理與真實外觀 priors
互動需求不需要使用者互動,pipeline 自動處理需要物件 mask / prompt,屬於 promptable / interactive workflow​
訓練數據合成多模態場景(SLAM + 多視圖)大規模真實 image→3D(Objects/Body 各自的 dataset)
適合場景AR 眼鏡 / 機器人多視角感知、場景 mapping、學術評測商業應用:電商 AR、human pose & shape、單圖 3D content creation
Categories: 開源, 視覺模型, 影像處理

Step3-VL-10B 輕量但超級視覺模型

Step3-VL-10B 是一款輕量級開源基礎模型,旨在重新定義緊湊高效與前沿多模態智能之間的權衡。儘管僅有 10B 參數,Step3-VL-10B 在視覺感知、複雜推理和人類對齊方面表現卓越。 該模型在 10B 規模以下的模型中始終表現最優,並能媲美甚至超越規模大 10×–20× 的開源模型(如 GLM-4.6V 106B-A12B、Qwen3-VL-Thinking 235B-A22B)以及頂級閉源旗艦模型(如 Gemini 2.5 Pro、Seed-1.5-VL)。 Demo: 根據表格推導”STEPFUN”的莫爾斯編碼 Step3-VL-10B 的成功源於兩大核心設計:高質量多模態語料庫的統一預訓練(1.2T tokens)與規模化多模態強化學習(超過 1,400 次 RL 迭代),並引入 Parallel Coordinated Reasoning (PaCoRe) 實現並行視覺探索的證據聚合。

Step3-VL-10B 是一款輕量級開源基礎模型,旨在重新定義緊湊高效與前沿多模態智能之間的權衡。儘管僅有 10B 參數,Step3-VL-10B 在視覺感知、複雜推理和人類對齊方面表現卓越。

該模型在 10B 規模以下的模型中始終表現最優,並能媲美甚至超越規模大 10×–20× 的開源模型(如 GLM-4.6V 106B-A12B、Qwen3-VL-Thinking 235B-A22B)以及頂級閉源旗艦模型(如 Gemini 2.5 Pro、Seed-1.5-VL)。

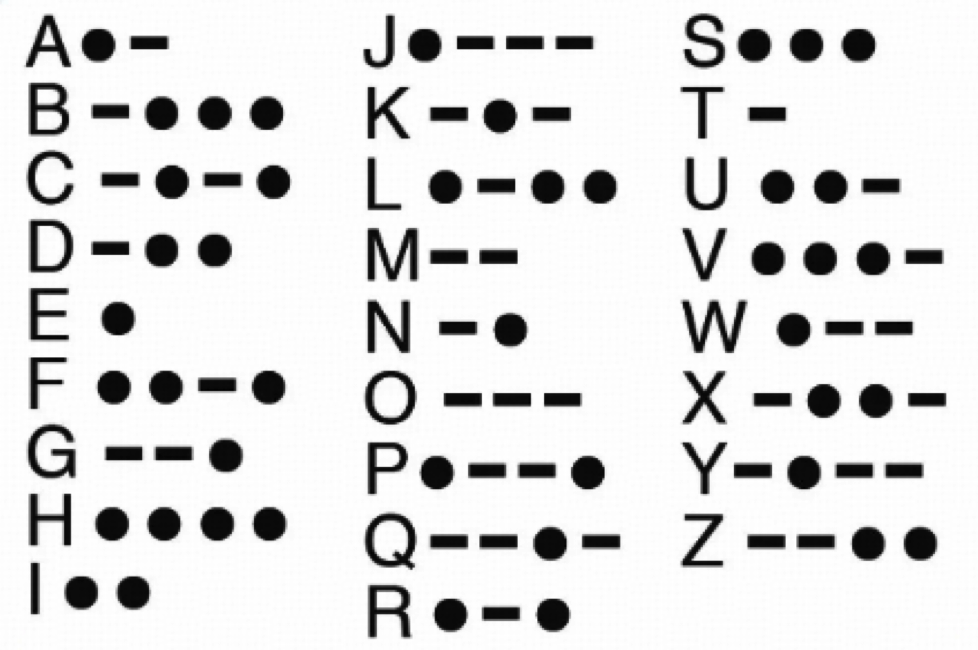
Demo: 根據表格推導”STEPFUN”的莫爾斯編碼

Thinking Process

用户现在需要把每个字母转换成莫尔斯电码,先看每个字母在表中的编码。首先分解"STEPFUN"每个字母:S、T、E、P、F、U、N。

S:看右边第三列第一个,S是···(三个点)。(一个短横)
T:第三列第二个,T是-。
E:左边第一列第五个,E是·(一个点)。
P:中间列(J到R)中P对应的符号是·--·点、短横、短横、点)。
F:最左侧列第六行,F的符号是··-·(两个点、一个短横、一个点)。
U:最右侧列第三行,U的符号是··-(两个点、一个短横)。
N:中间列(J到R)第五行,N的符号是-·一个短横、一个点)。
再将每个字母的编码按顺序拼接(字母间用空格分隔更清晰),"STEPFUN"的莫尔斯电码为:··· - · ·--· ··-· ··- -·

Final Answer
··· - · ·--· ··-· ··- -·

Step3-VL-10B 的成功源於兩大核心設計:高質量多模態語料庫的統一預訓練(1.2T tokens)與規模化多模態強化學習(超過 1,400 次 RL 迭代),並引入 Parallel Coordinated Reasoning (PaCoRe) 實現並行視覺探索的證據聚合。

Categories: 開源, 視覺模型, 推理引擎

CoF-T2I 漸進式視覺推理模型

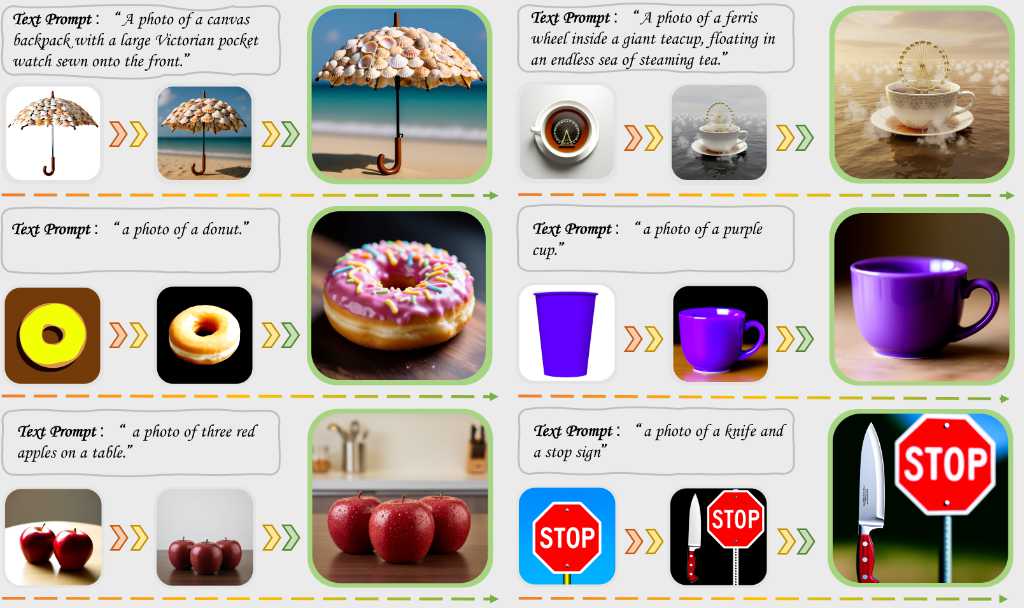
CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

Categories: 開源, 視覺模型, 影像處理, 推理引擎

3AM 分割影片中具有幾何的內容

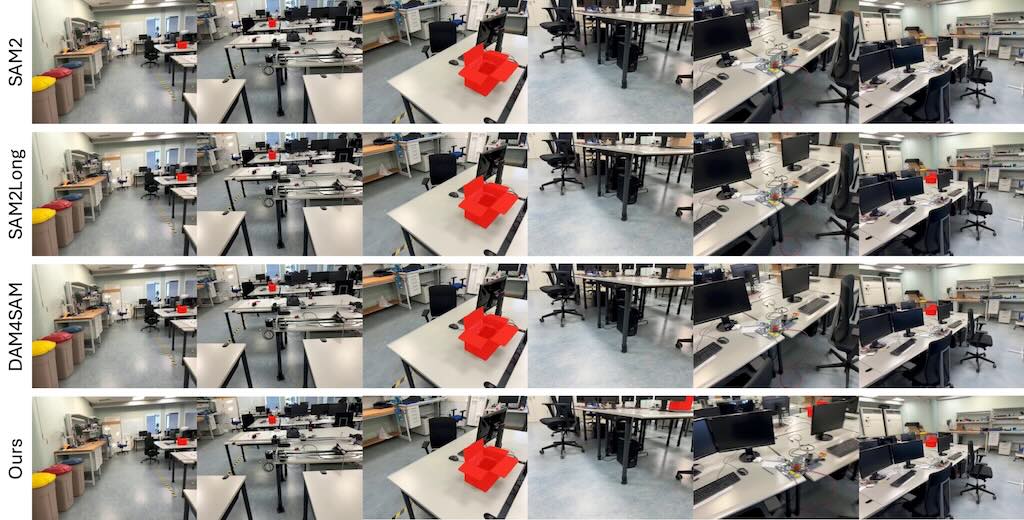
3AM 是一種結合了 2D 即時分割模型 SAM2 與 3D 幾何資訊的方法,目的是在影片或任意多視角圖像集合中,對同一物體保持一致的分割 mask。傳統的 2D 追蹤模型(如 SAM2)在觀點大幅變化時會因為只能依賴外觀特徵而失去目標,而早期的 3D 方法則需要提供相機位姿、深度圖或複雜的前處理,才能保證跨視角的一致性。 3AM 的創新在於在模型訓練階段,透過輕量的特徵合併模組把從 MUSt3R(一個多視角重建模型)學到的隱式幾何特徵與 SAM2 的外觀特徵結合,形成既能捕捉空間位置又能反映視覺相似度的表示。這樣的融合讓模型在推論時只需要原始 RGB 影像和使用者提供的提示(點、框、mask 等),就能在不同觀點之間追蹤物體,且不需要額外的相機資訊或前處理步驟。文章指出,這種做法在包含大量視角變化的基準測試集(如 ScanNet++、Replica)上,IoU 數值提升顯著,例如在 ScanNet++ 的 Selected Subset 上比 SAM2Long 高出約 15.9 個百分點。整體而言,3AM 在保持即時、可提示化的特性同時提升了跨視角的一致性,為後續的 3D 實例分割與多視角物體追蹤提供了一個更簡單、更有效的解方案。

3AM 是一種結合了 2D 即時分割模型 SAM2 與 3D 幾何資訊的方法,目的是在影片或任意多視角圖像集合中,對同一物體保持一致的分割 mask。傳統的 2D 追蹤模型(如 SAM2)在觀點大幅變化時會因為只能依賴外觀特徵而失去目標,而早期的 3D 方法則需要提供相機位姿、深度圖或複雜的前處理,才能保證跨視角的一致性。

3AM 的創新在於在模型訓練階段,透過輕量的特徵合併模組把從 MUSt3R(一個多視角重建模型)學到的隱式幾何特徵與 SAM2 的外觀特徵結合,形成既能捕捉空間位置又能反映視覺相似度的表示。這樣的融合讓模型在推論時只需要原始 RGB 影像和使用者提供的提示(點、框、mask 等),就能在不同觀點之間追蹤物體,且不需要額外的相機資訊或前處理步驟。文章指出,這種做法在包含大量視角變化的基準測試集(如 ScanNet++、Replica)上,IoU 數值提升顯著,例如在 ScanNet++ 的 Selected Subset 上比 SAM2Long 高出約 15.9 個百分點。整體而言,3AM 在保持即時、可提示化的特性同時提升了跨視角的一致性,為後續的 3D 實例分割與多視角物體追蹤提供了一個更簡單、更有效的解方案。

Categories: 開源, 視覺模型, 模型訓練, NVIDIA, 影像處理

VINO 多模態模型對齊提示生成圖像與影片

VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。 這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。

VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。

這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

InfiniDepth 解析二維深度圖

InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。  

InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。  

Categories: 開源, 視覺模型, 影像處理

NeoVerse 4D 世界模型

NeoVerse 是一種強大的 4D 世界模型,專門設計來處理現實環境中的單眼視頻,從而實現多種應用。這個模型的核心優勢在於它能夠進行無姿態限制的前饋 4D 重建,這意味著它可以從普通的單眼視頻中直接生成高質量的 4D 場景,而不需要複雜的多視角數據或預處理步驟。

NeoVerse 是一種強大的 4D 世界模型,專門設計來處理現實環境中的單眼視頻,從而實現多種應用。這個模型的核心優勢在於它能夠進行無姿態限制的前饋 4D 重建,這意味著它可以從普通的單眼視頻中直接生成高質量的 4D 場景,而不需要複雜的多視角數據或預處理步驟。

Categories: 開源, 視覺模型, 視頻模型, 世界模型, 影像模型, 影像處理

Page 21 of 23
1 … 19 20 21 22 23